LLM 请求与流式响应
一个 Agent 项目里,LLM 客户端这一层看着只是”发请求、收回复”。但一次请求里到底发出去什么、收回来什么,是这一层所有代码的骨架——这件事没理清,后面每个函数都只能照着别人的代码抄。
所以先别急着分层,把一次往返从头走一遍。
1. 一次完整的往返:发什么,收什么
问一句”东京现在天气怎么样”,客户端和 API 之间是这样来回的:
1 | ① 你 → API |
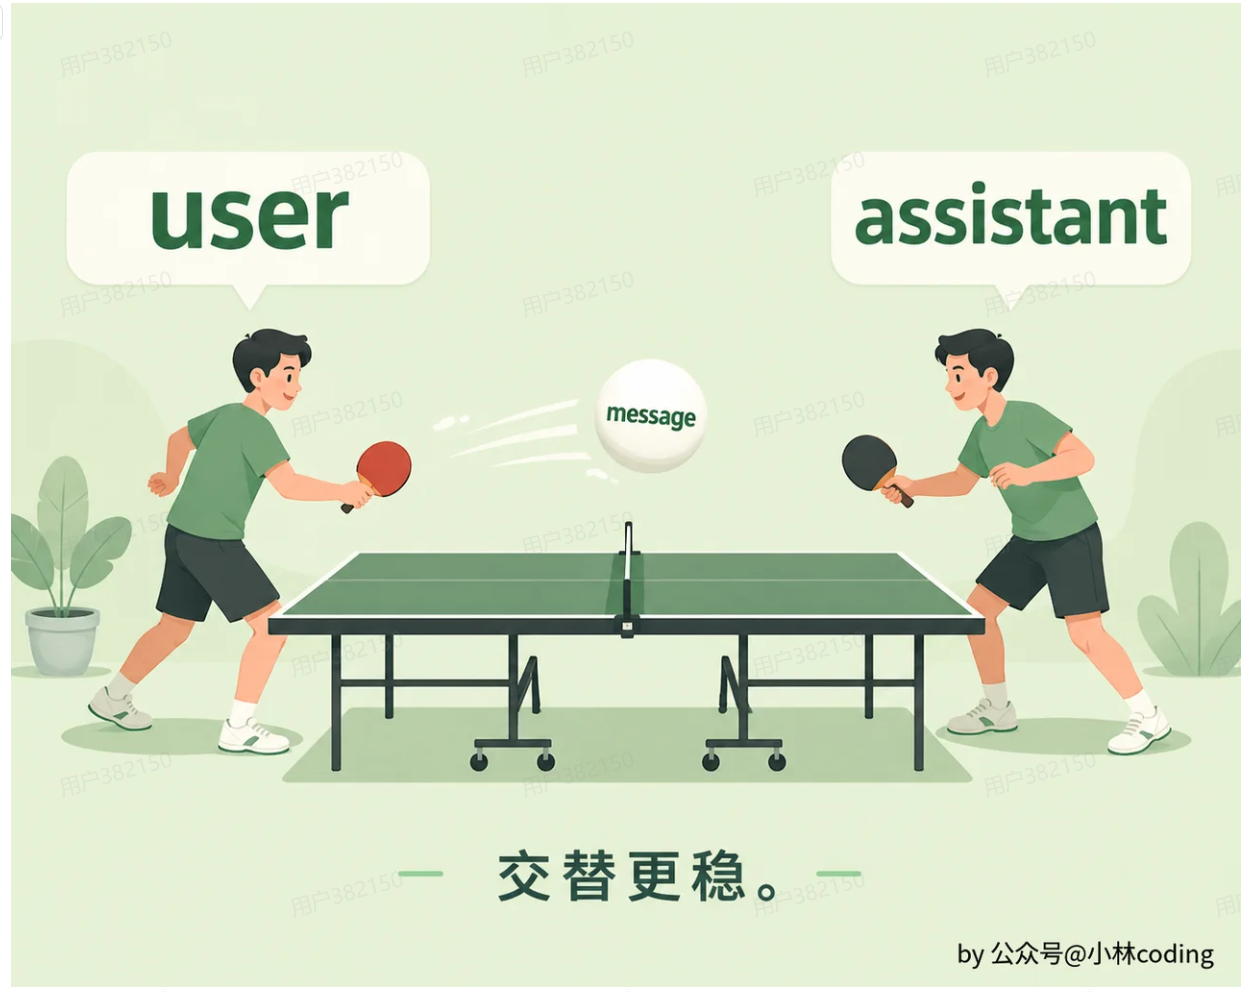
发送方向上,只有两样东西: 一个 messages 数组,加上 model、system、tools 这些配置(§2 会完整列一遍)。messages 里每条消息是 role + content,而 role 只有两个值——你发给模型的一切都算 user,模型返回的一切都算 assistant。
这条规则解释了第 ④ 步为什么长成那样:工具是你自己执行的,但结果必须作为 user 消息发回去,因为从 API 的视角看,凡是”发给模型”的东西都归 user。规则就这么简单,但也正是它最容易被”工具结果应该算 tool 角色”这种直觉带偏(§3 细说)。
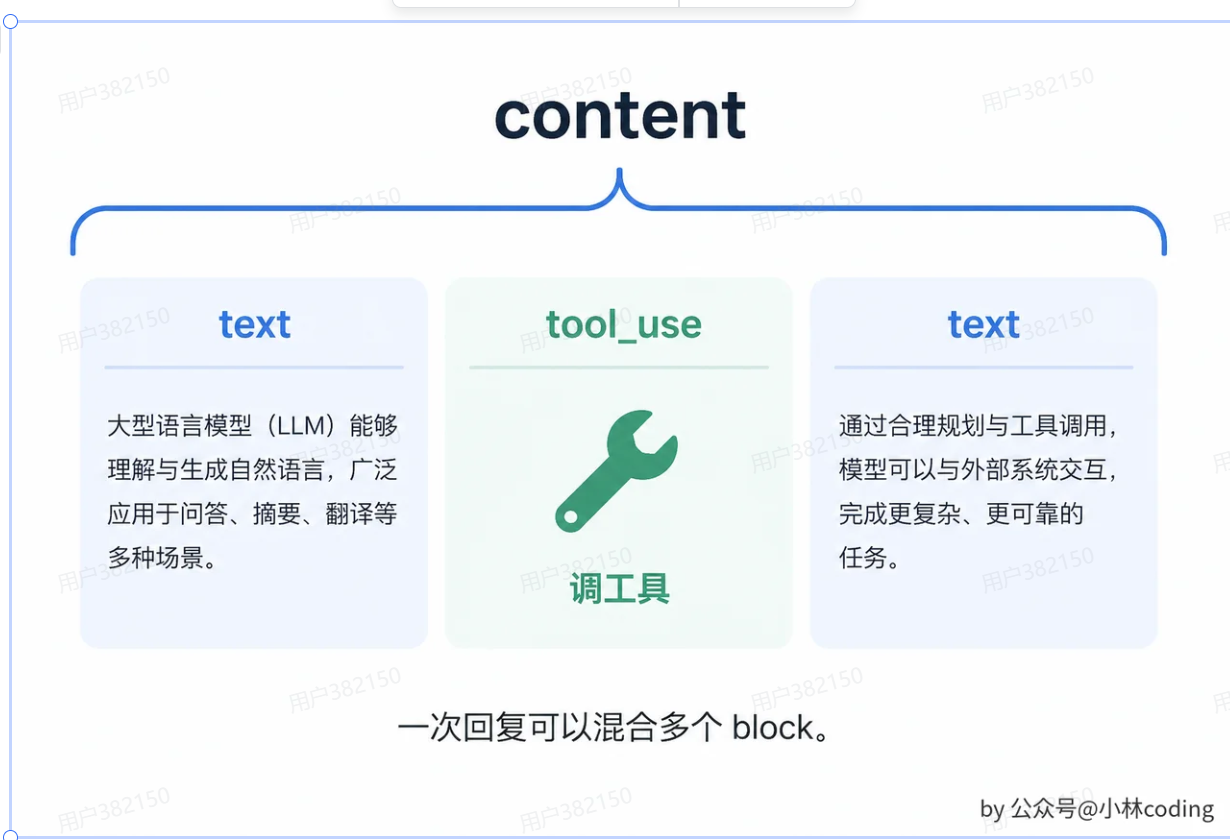
接收方向上,content 不再是一句话,而是一串内容块。 三种块:
| 块类型 | 谁生成的 | 含义 |
|---|---|---|
text |
模型 | 模型要说的话 |
tool_use |
模型 | 模型申请调用某个工具,附上参数 |
tool_result |
你 | 工具执行完的结果,回传给模型 |
tool_use 是最容易理解错的一个:它只是一条声明,不是一次执行。 它长这样:
1 | { |
模型输出这个块,意思是”我想调 get_weather,参数是 {"city": "Tokyo"}“。真正的执行发生在你的代码里——你取出 name 和 input,去调本地函数,再把结果包成 tool_result:
1 | { |
tool_use_id 和上面那个 id 是配对关系。模型一次可以调好几个工具,返回多个 tool_use,靠这个字段才知道哪个结果对应哪个请求。
第 ② ③ ④ 步会重复:只要模型还在返回 tool_use,你就再执行一次、再回一次结果,直到它输出 text 收尾。这个”调工具 → 回结果 → 再调工具”的循环,就是 Agent 的主循环。
各家叫法不一样:tool use 和 function calling
上面这套在 Anthropic 的 API 里叫 tool use,块名就是 tool_use / tool_result——本文后面全程用它。
但同一个概念,各家的字段名几乎都不一样。而且这个名字是 OpenAI 带火的:2023 年 OpenAI 上线这个能力时管它叫 function calling,所以很多人至今叫它 “function call”。OpenAI 自己后来把它改名成了 tools / tool_calls(老字段 functions / function_call 已废弃),可是在新的 Responses API 里,那个 item 的类型又真的叫 function_call。所以”function call 和 tool use 是不是两个东西”——是一个东西,只是三套名字。
| Claude(Messages API) | OpenAI(Chat Completions) | OpenAI(Responses API) | Gemini(generateContent) | |
|---|---|---|---|---|
| 工具定义 | tools[].input_schema |
tools[].function.parameters |
tools[].parameters |
tools[].function_declarations[].parameters |
| 模型申请调用 | content 里的 tool_use 块 |
message.tool_calls[] |
顶层 item function_call |
parts 里的 functionCall |
| 参数 | input,对象 |
function.arguments,JSON 字符串 |
arguments,JSON 字符串 |
args,对象 |
| 配对字段 | tool_use_id |
tool_call_id |
call_id |
id |
| 结果回传 | user 消息里的 tool_result 块 |
单独的 role: "tool" 消息 |
顶层 item function_call_output |
user 消息里的 functionResponse part |
| 停止原因 | stop_reason: "tool_use" |
finish_reason: "tool_calls" |
— | — |
换供应商时最容易踩的两处:
一、arguments 是字符串还是对象。 Anthropic 和 Gemini 给你解析好的对象,直接取值;OpenAI 两家都给字符串,必须自己 json.loads(arguments)。这些字符串在流式里还会被切成碎片——对照 §6 的 input_json_delta,是同一个问题。
二、结果回传给什么角色。 Anthropic 是塞进 user 消息(§3 细说),OpenAI 的 Chat Completions 有专门的 role: "tool",Gemini 又回到 user、只是换成 functionResponse 这种 part。把 role: "tool" 原样搬到 Anthropic 会被拒(角色只认 user / assistant),把它当成 assistant 发又会撞上”两条 assistant 挨在一起”——这两种错法出自同一个习惯迁移。
把两端合起来看,content 这个字段其实只有两种形态:
| 形态 | 什么时候出现 | 例子 |
|---|---|---|
| 字符串 | 纯聊天,没有工具、没有思考 | "content": "东京现在天气怎么样?" |
| 数组(装块) | 有工具调用、有思考、有图片 | "content": [{"type": "tool_use", ...}] |
客户端内部:同一条消息,记的东西多得多
上面是 API 层的消息模型——就是那个 role + content,专门用来跟 LLM 通信,保持简单干净。
切到客户端内部,同一条消息要多记一大摞东西。内部层的角色从两种扩展到四种(多出 system 和 tool),每条消息带一个唯一 ID 方便定位和更新,还有时间戳、token 用量、响应耗时这些元数据。
最关键的是多了一个状态字段——一条 assistant 消息刚创建时是 streaming,流完变成 complete,出错变成 error。这个字段的存在本身就说明问题:如果只在流式结束后才把消息放进列表,就不需要状态;正因为要在流式过程中就把它显示出来,才需要一个字段标记”它还没长完”。
于是这一层的工作就定下来了:把内部消息压成 role + content 发出去,再把 API 返回的东西撑回内部消息。 去程还好办,回程遇到流式就难了——API 给你的是一串事件,你得自己拼回一条完整消息。这是后半篇的主题。
2. 请求长什么样
先明确一件事:下面这份是 Anthropic Messages API(Claude)的形状,本文从头到尾都以它为准。其他供应商的字段名不一样,概念是一套(对照 §1 末尾那张表)。
一个带工具、带思考、带缓存的完整请求:
1 | { |
几个值得注意的地方:
system 可以是一个字符串,也可以是一个数组。 上面是数组形式——写成数组是为了能在某一段上挂 cache_control。想给系统提示词开缓存,就必须用数组形式把那段单独拎出来:
1 | "system": [ |
只写一句提示词不改缓存的话,直接给字符串更省事:
1 | "system": "你是 MewCode,一个终端环境中的 AI 编程助手。\n\n# Environment\n当前工作目录: /home/dev/myproject\n操作系统: Linux\n当前时间: 2026-05-27" |
tools 里的 input_schema 就是一份 JSON Schema。 模型不是”理解”你的函数签名,它是照着这份 schema 生成参数。description 写得好不好,直接决定模型会不会在该调的时候调、参数填得对不对。
一条 assistant 消息里可以装三种块:thinking、text、tool_use。顺序有要求——thinking 必须在 text 和 tool_use 之前。上面那条就是先想了、再说一句”我来查”、然后调工具。
3. 最容易搞错的一处:tool_result 要当 user 发
看上面请求的最后一条 messages——tool_result 的角色是 "user"。
这里容易反直觉:工具是你自己执行的,结果当然不是模型说的话。但 API 的视角只有两种角色——所有你发给模型的东西都归 user,模型返回的都归 assistant。
所以那一轮的往返是:
1 | user 东京现在天气怎么样? |
如果你把工具结果也当成 assistant 发出去,就会变成两条 assistant 连在一起,API 直接拒绝:
1 | { |
这条消息说的是”角色必须交替”,但根因通常不在交替,而在工具结果的归属。 报错信息不会告诉你”你把 tool_result 的角色写错了”,只会说两个 assistant 挨着——排查的时候从这个方向找更快。
tool_result 里还有两个字段:tool_use_id 必须和当初 tool_use 的 id 对上(模型可能一次调好几个工具,靠这个配对),is_error 用来告诉模型”这个工具执行失败了”——工具失败别用抛异常的方式处理,把它当一条成功的消息发回去、把 is_error 置为 true,模型才有机会自己纠正。
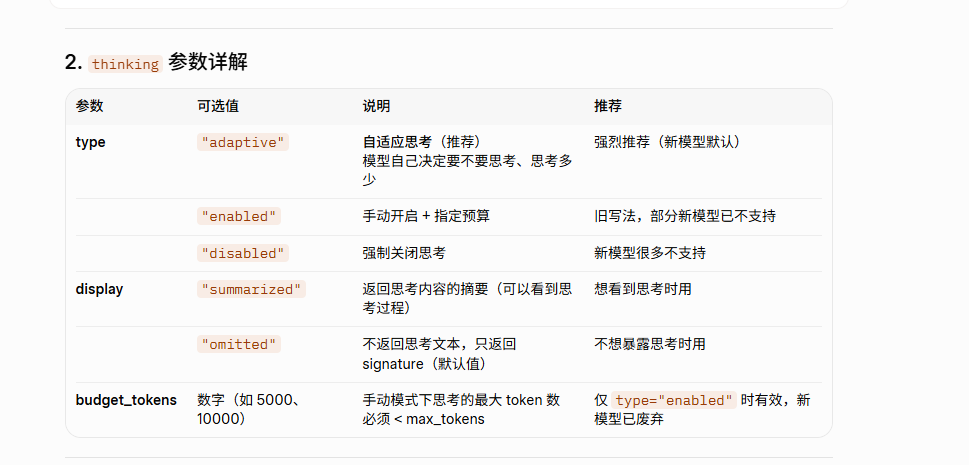
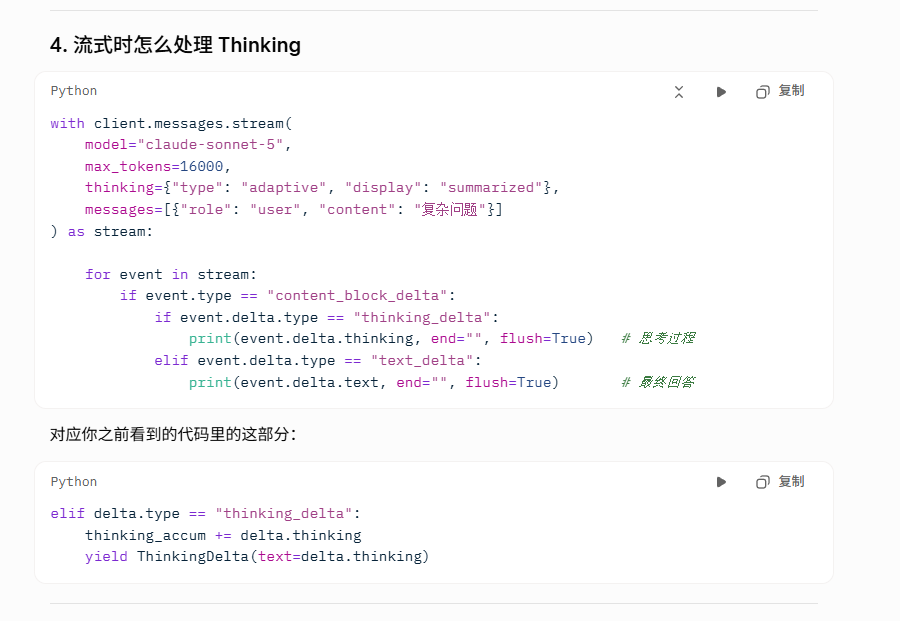
4. Thinking 参数
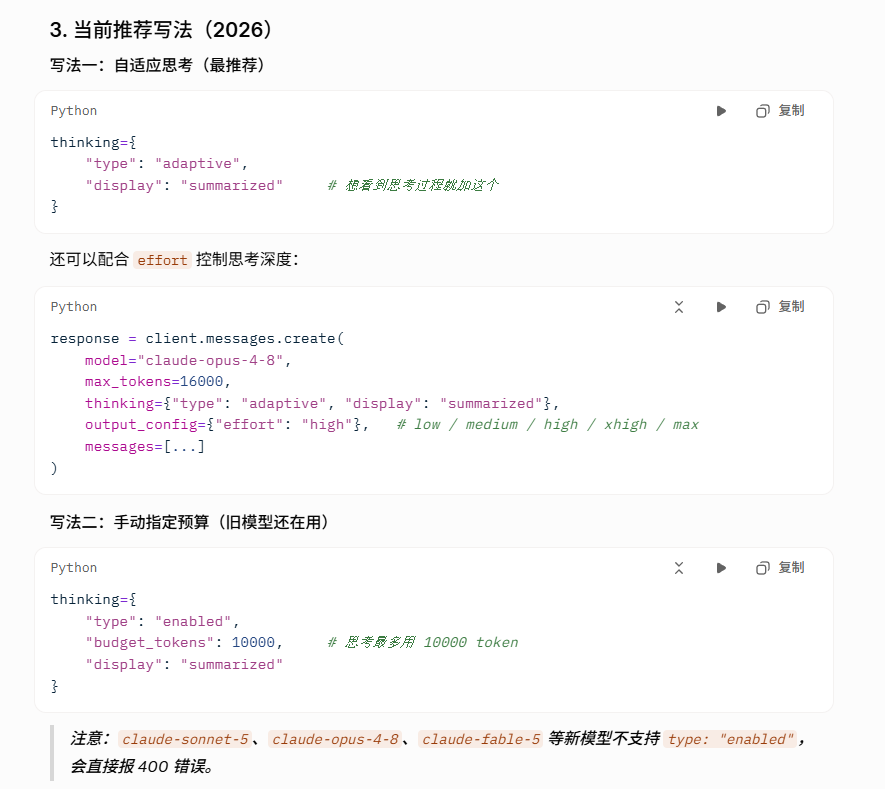
1 | response = client.messages.create( |
type:在 Claude 5 上只剩 adaptive
老写法是固定预算:
1 | thinking={"type": "enabled", "budget_tokens": 8192} # 老模型可用 |
这个形状在 Claude 5(Opus 5 / Sonnet 5 / Fable 5)上已经不被接受,会直接返回 400。在 Opus 4.6 / Sonnet 4.6 上还能跑但已标记弃用;Opus 4.5、Sonnet 4.5、Haiku 4.5、Claude 4 / 4.1 这些老模型则只能用老写法。
现在是 adaptive:让 Claude 自己根据问题复杂度决定想多久,不用你猜预算。想控制投入程度改用 output_config.effort。
有一个很常见的迁移 bug:adaptive 不能同时带 budget_tokens。 两个一起写会返回 400,报 Extra inputs are not permitted。看到这个错就检查是不是新旧两种形状混着写了。
还有一点:adaptive 会自动开启 interleaved thinking,也就是允许模型在多次工具调用之间思考。这正好是下一节那个签名坑的成因。
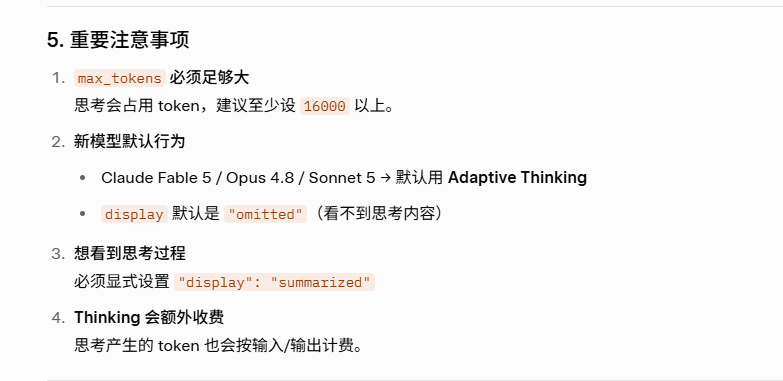
display:默认是 omitted,不看就白想
display 只有两个值:
| 值 | 效果 |
|---|---|
"summarized" |
返回可读的思考摘要,放在 thinking 字段里 |
"omitted" |
thinking 字段是空的,但 signature 依然保留 |
在 Claude 5 / Fable 5 / Mythos 5 / Opus 4.8 / Opus 4.7 上默认是 "omitted"——这是相对 Opus 4.6 / Sonnet 4.6 的一个静默变化(那两代默认是 summarized)。所以升级模型之后发现思考内容不见了,不是坏了,是要显式写出来。
还有一条关于钱的:不管 display 设成什么,thinking 的 token 都照收钱。 omitted 省的是延迟,不是成本。真实用量在 usage.output_tokens_details.thinking_tokens 里。
5. 流式响应:SSE 的事件序列
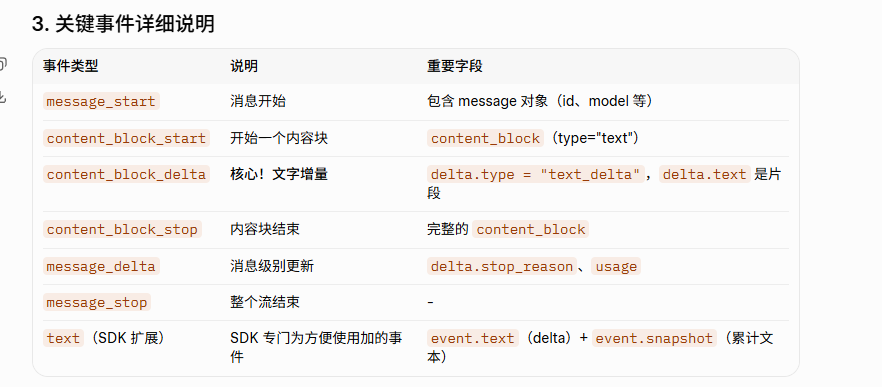
流式响应基于 SSE(Server-Sent Events)协议。一条完整的响应会被拆成按顺序到达的事件:
1 | message_start 整个响应开始,带着 input_tokens 信息 |
对照着看,非流式返回的那一坨 JSON 长这样:
1 | { |
把两张东西叠起来看,流式的任务就清楚了:你要用上面那串事件,重建出下面这个 JSON。 content_block_start 决定这个块是什么类型,content_block_delta 一点一点喂内容,content_block_stop 说明这个块完了。
流式和不用流的差别只在过程,不在结果——终点必须是同一条消息,否则你的内部层就要准备两套数据结构,后面每一处消费消息的地方都得判一下”这条是流式来的还是整条来的”。这是这一层设计上最容易走歪的地方。
usage 里的两个缓存字段也值得留意:cache_read_input_tokens 是从缓存里读到的(便宜),cache_creation_input_tokens 是这次写进缓存的(贵一点)。上面这个例子里 input_tokens 只有 1245 而缓存读到了 3200,说明大部分上下文走的缓存。
6. 四种 delta,各拼各的
content_block_start 只是告诉你”来了一个什么块”,真正的内容在 content_block_delta 里。收到它时,delta.type 决定了这是哪种更新:
1 | async for event in stream: |
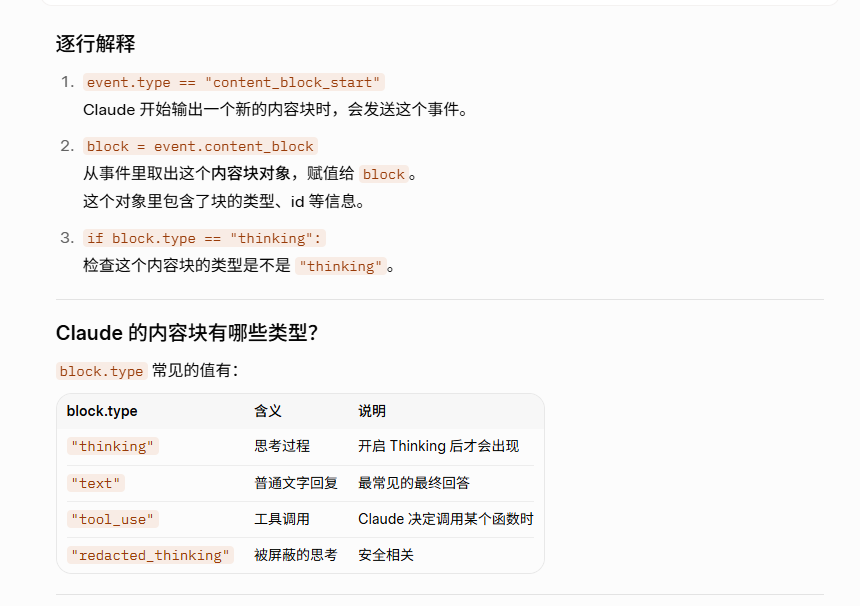
1 | elif event.type == "content_block_delta": |
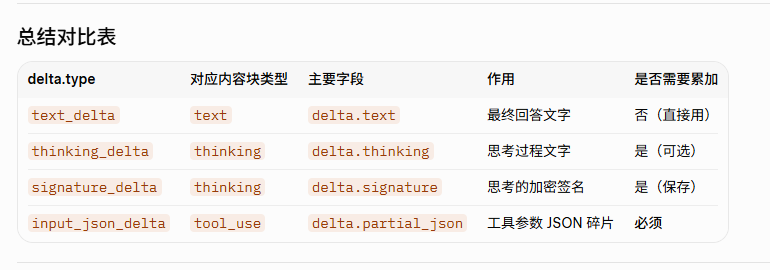
四种放在一起:
delta.type |
字段 | 是什么 | 怎么处理 |
|---|---|---|---|
text_delta |
delta.text |
最终回答的文字片段 | 直接交给前端(打字机效果) |
thinking_delta |
delta.thinking |
内部思考过程的文字片段 | 累加起来,同时可以实时展示 |
signature_delta |
delta.signature |
思考内容的加密签名 | 只存不展示,但必须存 |
input_json_delta |
delta.partial_json |
工具调用参数的 JSON 碎片 | 累加,等拼完整再 json.loads |
几条要点:
text_delta 是最常见的那个,用户最终看到的回复就是它一段段拼出来的。它的字段叫 delta.text,注意和 thinking_delta 的 delta.thinking 不一样,别看错。
thinking_delta 通常出现在最终回答之前,可以做成一个可折叠的思考区域。它需要累加是因为你要在 content_block_stop 时把完整的思考内容存进内部消息。
signature_delta 一般只出现一次,在 thinking 块快结束时(content_block_stop 之前)。它不需要展示给用户,但必须存下来——原因在下一节。
input_json_delta 是最容易漏的那个。 它给的是 partial_json——一段不完整的 JSON 文本:
1 | "{\"location\": \"San " |
因为 JSON 是一点点生成的,每个碎片单独拿出来都不是合法 JSON,必须自己累加(json_accum += delta.partial_json),等整个块结束、JSON 完整了,再用 json.loads(json_accum) 解析成字典,然后才真正执行工具。
所以这里天然有一个阶段划分:流式过程中只能”展示”工具参数,不能”执行”工具。 执行必须等到那个 content_block_stop。如果你的代码在收到第一个 input_json_delta 时就想解析,会一直拿到 JSONDecodeError。
7. 签名存起来还不够
上一节说 signature_delta 要存下来。但”存下来”只是做完了一半——另一半是回传的时候必须原样、原地。
这是整篇里后果最严重的一个坑,因为它不是”这一条请求失败”,而是整个会话卡死。
要求是什么
当一条 assistant 消息里同时有 thinking 和 tool_use(也就是上面说的 interleaved thinking),下一轮请求里那些 thinking 块连同签名必须一字不差地回传:
- 不要改文本。 有项目在存的时候顺手对思考内容做了
trimEnd(),去掉了结尾的换行——签名是对原始文本算的,改一个字节就报Invalid signature in thinking block。 - 不要重排顺序。 签名是和块的位置绑定的。把 thinking 块和 tool_use 块拆成两个数组再拼回来,顺序一变就失效。
- 不要只过滤
type == "thinking"。 还有一类redacted_thinking块(内容是加密的data字段),它同样要原样带上。只匹配"thinking"会把它静默丢掉。 - 位置也别动。 thinking 块必须在 assistant 消息里 text / tool_use 之前。
违反之后会怎样
报错是这样的:
1 | The content[].thinking in the thinking mode must be passed back to the API |
或者:
1 | blocks in the latest assistant message cannot be modified. |
这类 400 是”不可重试”的。 更麻烦的是:一旦一条被改坏的消息进了历史,之后每一个请求都会失败——连你想发一条”你好”去诊断都发不出去,因为坏消息还在历史里。只能清掉会话或者换模型。
正确做法
官方建议是 pass thinking blocks back exactly as received,并且明确说了 don’t interpret or parse 那个签名。
落到代码上就是:别把流式收到的内容”整理”成自己的结构再还原。把 API 返回的块序列原样存一份(顺序 + 签名都不动),下一轮请求时原样放回去。§1 说的那道”压扁再撑开”的工序,在这里要留个例外——这几块不要翻译,做搬运。
只在带工具的时候才必须回传;不带工具的对话可以省掉。但”什么时候必须”这个判断本身也容易判错,存着不动比”判断该不该丢”安全得多。
这不是 Anthropic 独有的坑。 Gemini 的 functionCall part 上也挂着一个 thought_signature,要求一模一样:把模型的回复原样带回去,不要拆开、不要合并带签名的 part,否则推理链断掉、请求直接失败。凡是模型输出的加密签名,都当成只能原样搬运的数据。
8. 为什么写成 async generator
1 | async for event in stream: |
yield 是这里的关键。每次 yield 都暂停当前函数,把事件交给调用方处理;调用方处理完了,执行权返回这里继续读下一个 SSE 事件。
这种协作式调度非常轻量,没有缓冲区管理的心智负担,天然就是背压友好的——消费端处理不过来,就不会回来要下一个,生产者那边自然就等着。
对比两种替代方案就很清楚:
| 做法 | 问题 |
|---|---|
| 回调 / 事件监听 | 逻辑被拆散在多个回调里,”累加 thinking””累加 json”这些状态得挂在外部变量上 |
| 一次性收完再返回 | 失去了流式的意义,用户要等整个响应结束才看到第一个字 |
写成 async generator,“累加各块状态”和”把增量交出去”这两件事就写在了同一个函数里、同一段循环里——上一节那些 thinking_accum += ...、json_accum += ... 之所以能写成局部变量,就是因为它在一个函数里从头看到尾。
这也接上了 python 异步编程那篇里的结论:async for 消耗的就是一个异步迭代器,而 yield 就是产生它的方式。
9. 异常翻译
最后一件事:别让 SDK 的异常类型漏到上层。
1 | except _anthropic.AuthenticationError as e: |
| SDK 异常 | 翻译成 | 上层该怎么反应 |
|---|---|---|
AuthenticationError |
AuthenticationError |
配置问题,重试没用,直接报给用户 |
RateLimitError |
RateLimitError |
可以重试,retry-after 头告诉你要等多久 |
APIConnectionError |
NetworkError |
网络问题,可以重试 |
APIStatusError |
LLMError |
服务端返回了非 2xx,带上状态码和消息 |
几个细节:
from e 不能省。 它保留了原始异常链,出问题的时候 traceback 会同时显示”我的 LLMError“和”底下的 APIStatusError“——不写就只剩前半截,排查时看不到真正的原因。
RateLimitError 那一支把 retry-after 头捞了出来。 这是唯一一个”知道该等多久”的异常,429 的重试逻辑全靠它。注意 e.response 可能为 None,所以要先判一下再取头。
为什么要多这一层翻译。 三个理由:上层不需要 import SDK 就能处理异常(换供应商时改动面小);自己的异常能带上领域信息(比如统一的重试策略标记);不同供应商的异常能收敛成同一套。代价是这层映射要维护——SDK 加了新的异常类型,你不映射就会漏到上层去。
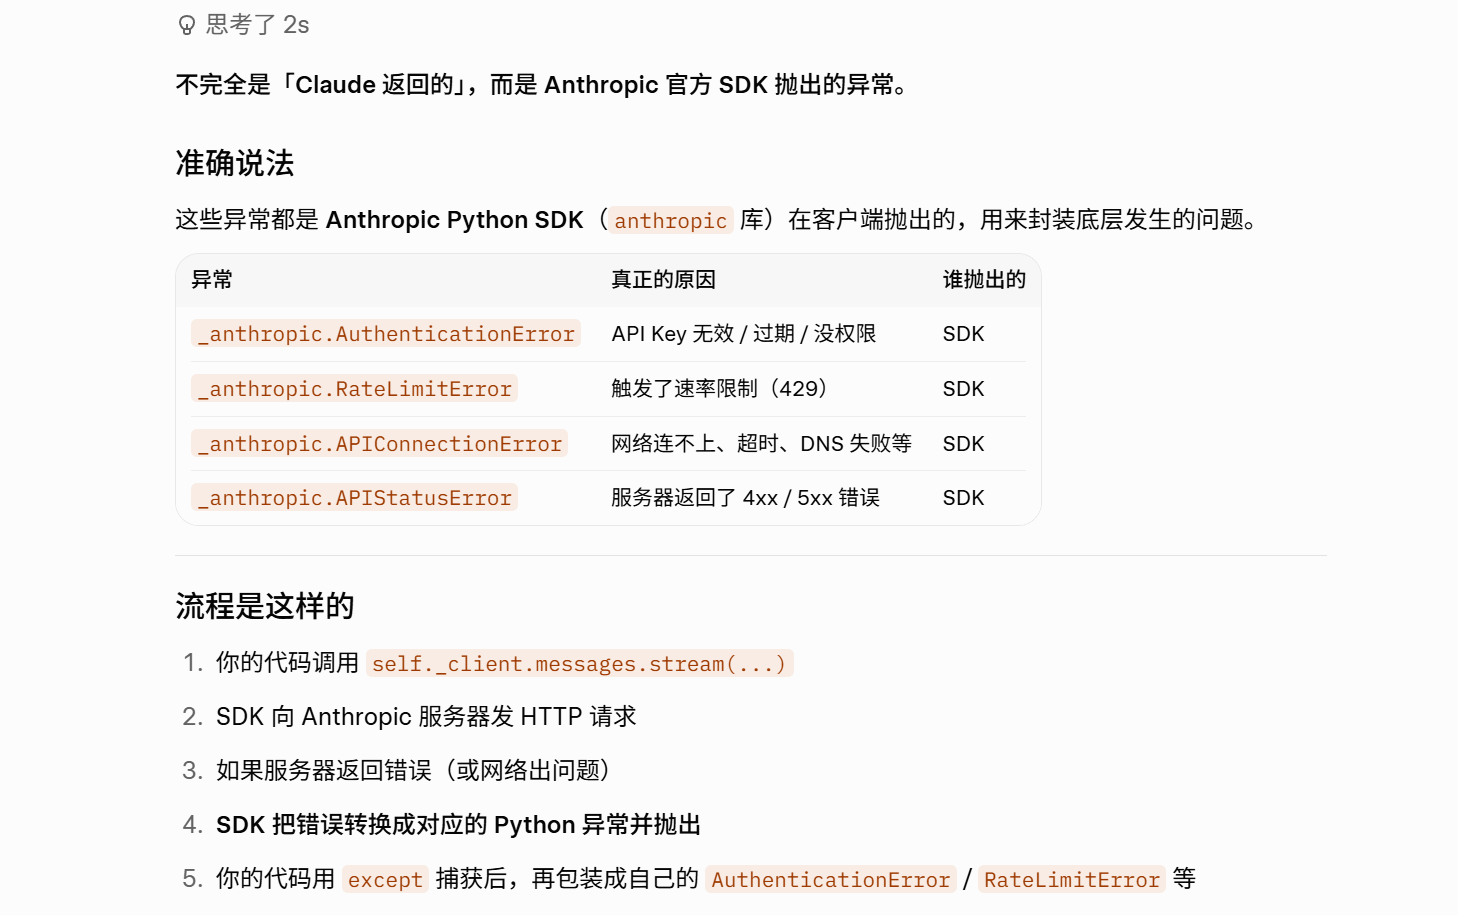
如果上层要对所有异常都兜一下,记得别把非重试的错误也重试:鉴权失败重试一百次也没用。按上表最后一列分类,是这个映射表真正的价值。
10. 小结
回到开头那次往返——这一层的全部工作,是把内部消息压成 API 要的样子发出去,再把返回的东西撑回来。四件事:
一、请求方向:内部消息压成 role + content。 最常错的是 tool_result 要当 user 发;报错说的是”角色必须交替”,根因在工具结果的归属。这套形状是 Claude 的——同样的概念在 OpenAI 叫 tool_calls / function_call,参数是 JSON 字符串,结果走 role: "tool",Gemini 又是另一套。
二、Thinking 在 Claude 5 上只剩 adaptive。 老的 enabled + budget_tokens 会 400,adaptive 也不能带 budget_tokens。display 默认是 omitted,要看思考内容得显式写 summarized——但不管怎么设,token 都照收钱。
三、响应方向:用 SSE 事件重建出那条完整消息。 六种事件、四种 delta,其中 input_json_delta 必须自己累加,工具要等 JSON 完整才能执行;终点必须和非流式返回的结构一致。
四、签名必须原样回传,不是存起来就行。 带工具的轮次里,thinking 块和签名不能改文本、不能重排、不能漏掉 redacted_thinking——违反了会让整个会话卡死,而且不可重试。
参考
- Messages API 请求与响应结构:https://platform.claude.com/docs/en/api/messages
- 流式响应(SSE 事件与 delta 类型):https://platform.claude.com/docs/en/api/streaming
- Adaptive thinking:https://platform.claude.com/docs/en/build-with-claude/adaptive-thinking
- Extended thinking 与签名回传要求:https://platform.claude.com/docs/en/build-with-claude/extended-thinking
- 工具使用(
tool_use/tool_result的角色与is_error):https://platform.claude.com/docs/en/build-with-claude/tool-use - 提示词缓存(
cache_control):https://platform.claude.com/docs/en/build-with-claude/prompt-caching