ReAct 与 Agent Loop
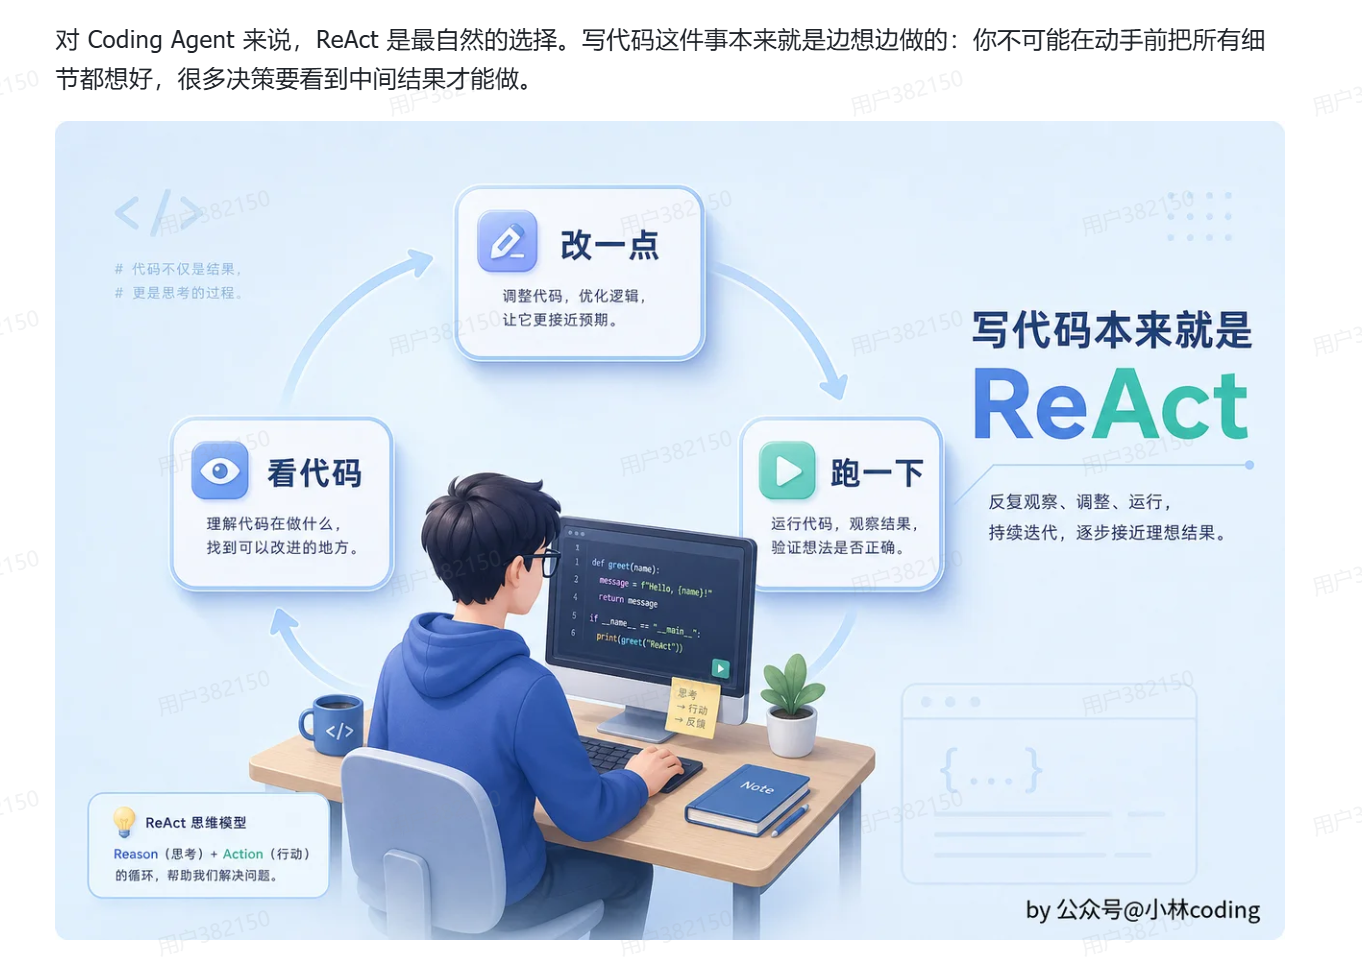
ReAct 是 Reason + Act 的缩写:让模型先想一步、再做一步、看看结果接着想——把推理和行动交替起来,而不是一口气把答案编完。
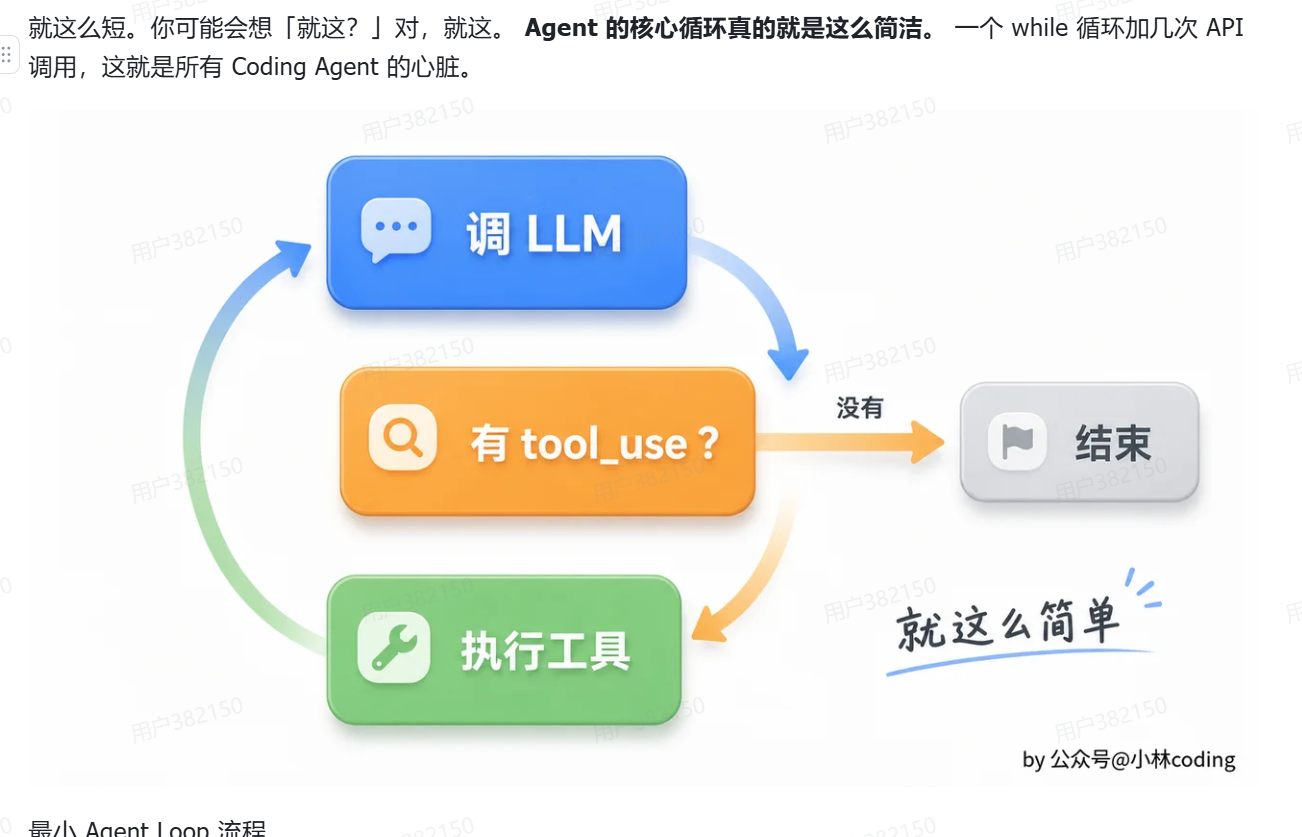
落地到代码,这个交替就是一个 while 循环:模型自己决定调几次工具、每次调哪个、什么时候停。这个循环通常叫 Agent Loop。
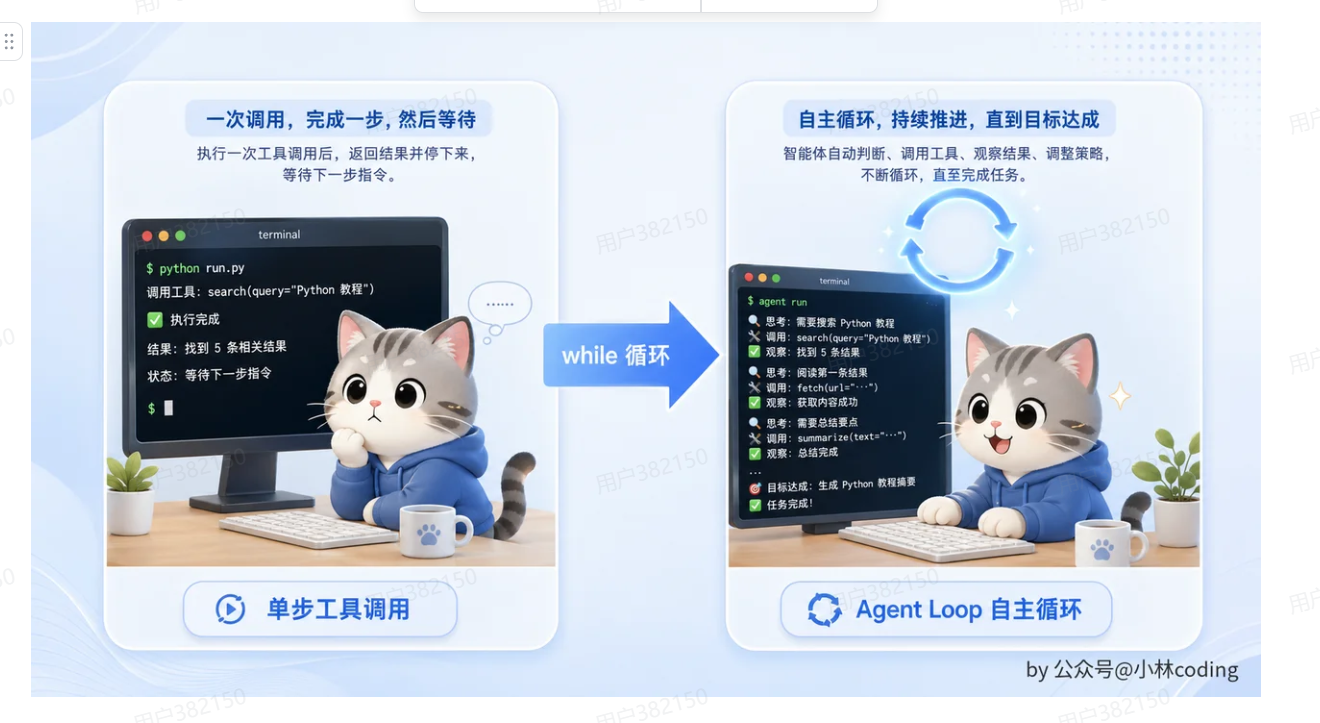
1. ReAct:先想,再做,看了结果再想
这个套路不是凭空来的。2022 年 10 月,Princeton 和 Google 的几位作者发了篇论文,把它命名为 ReAct。当时的背景是:推理和行动被当成两个独立的问题在研究。
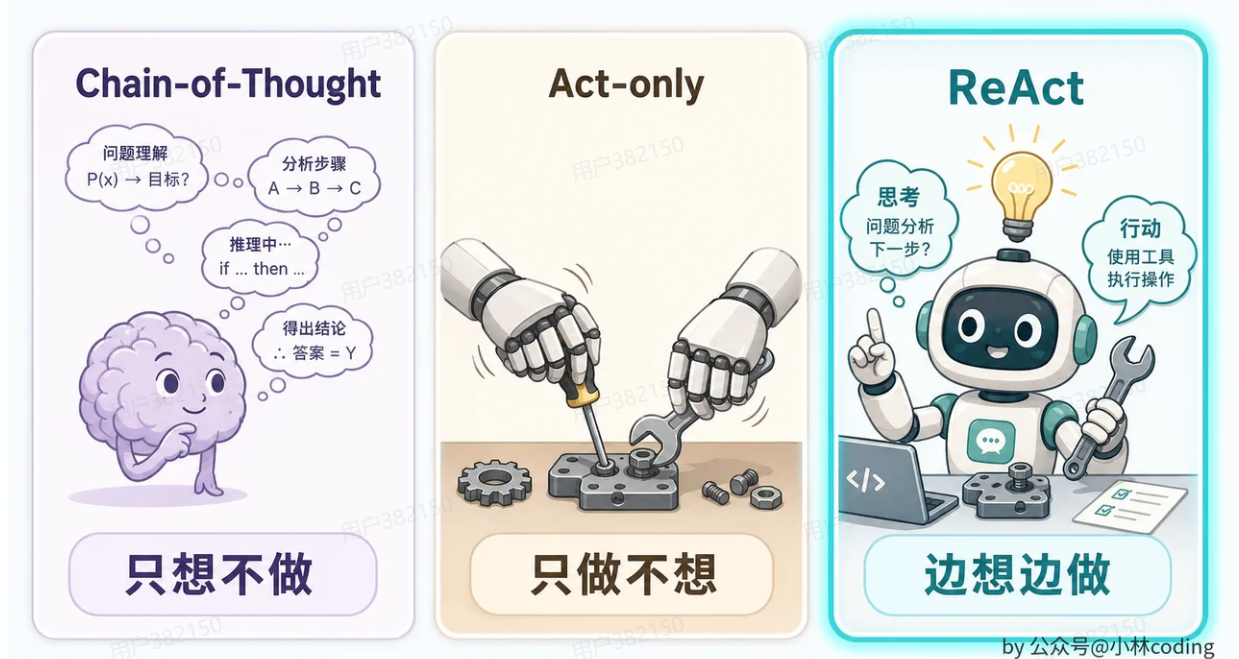
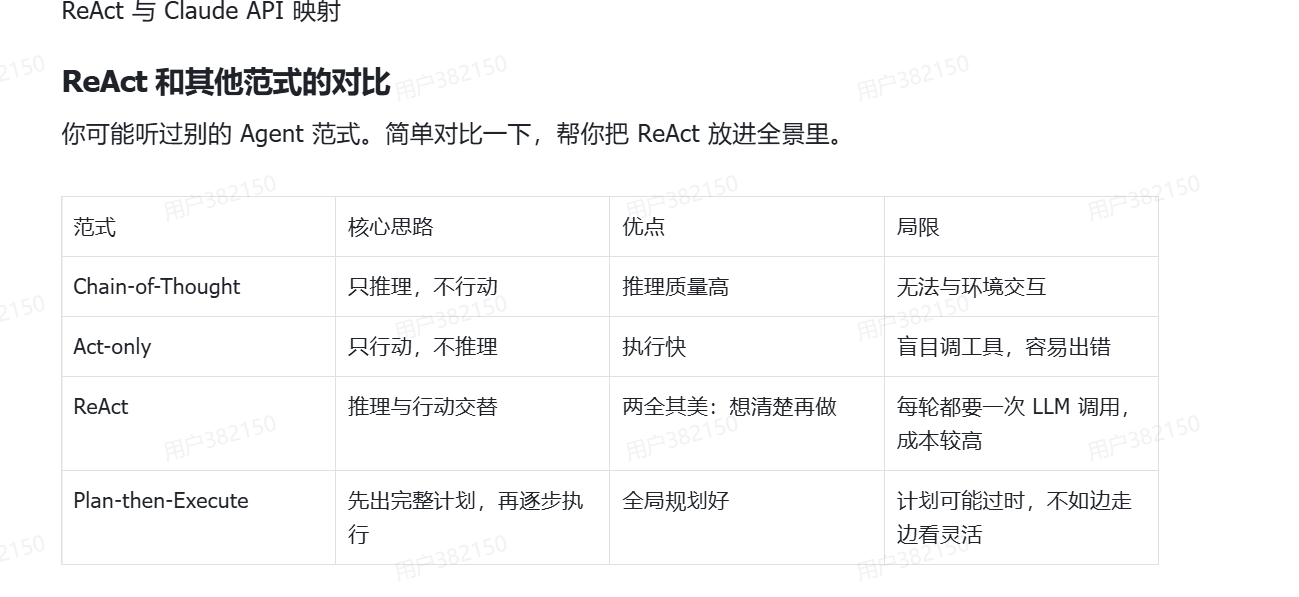
- 一边是 chain-of-thought:让模型把推理过程写出来,效果确实好,但它只能靠脑子里的知识——知识过时了、记错了,推理再顺也是错的,而且错误会一路传播下去
- 另一边是 action plan generation:让模型输出动作、去调外部工具。但它不”想”——拿到什么结果就用什么结果,不会根据结果调整策略
ReAct 把两件事交替起来:模型先写一段 Thought(自由文本的推理),再输出一个 Action(真正去调工具),环境返回 Observation(执行结果),然后进入下一轮 Thought。
论文里有两句话把这个分工说得很准:
- Thought 不改变环境。 它的作用是”归纳、追踪、更新计划,以及处理异常”
- Action 才改变环境。 它是模型和外部世界之间唯一的接口
效果(PaLM-540B,few-shot):
| 任务 | ReAct | 对照 |
|---|---|---|
| HotpotQA(多跳问答) | EM 27.4 | 纯 Action 25.7;CoT 29.4(但 CoT 是编的) |
| FEVER(事实核查) | Acc 60.9 | 纯 Action 58.9,高于 CoT 的 56.3 |
| ALFWorld(文字游戏) | 成功率 71% | 比模仿学习 / 强化学习高 34 个百分点,后者训练用了 10³~10⁵ 条数据 |
| WebShop(网页购物) | — | 比模仿学习 / 强化学习高 10 个百分点 |
ALFWorld 那行最值得看:ReAct 只用了一两个示例(写进 prompt 里),就打赢了用几万条数据训练出来的方法。
HotpotQA 那行则要连着看:CoT 的分数更高,但它没有外部依据——答对了可能是因为记住了,答错了你也看不出来。ReAct 分数低一点,但每一句都能追溯到一次搜索。论文的结论是两者结合最好(ReAct 检索完再让 CoT 总结,EM 35.1),内部知识和外部信息各管一段。
2. 从提示词约定到 API 的一等公民
ReAct 当年是纯提示词的:给了几个示例,模型照着格式往下写。harness 那一边干的事,说白了就是一个文本解析器——从模型输出里把 Action: 那一行抠出来,解析出工具名和参数,执行,再把结果拼成 Observation: 塞回上下文。
所以那时候最脆的地方就在解析:模型多写一个空格、换个措辞、把参数写成中文引号,整套就崩了。
tool_use 把这件事变成了 API 的一等公民。 同一个三件套,现在有了结构化字段:
| ReAct(2022,文本约定) | Claude Messages API(现在) |
|---|---|
Thought: ... |
thinking 块(开了 extended thinking 才有) |
Action: search[Apple] |
tool_use 块(name + input) |
Observation: ... |
tool_result 块(content) |
最大的变化是解析这一步消失了:input 直接就是解析好的对象(Anthropic、Gemini),或者一个规规矩矩的 JSON 字符串(OpenAI,自己 json.loads 一下)。
但有一个东西退回去了:可解释性。ReAct 论文专门强调 Thought 的好处之一是”人能看懂模型为什么这么做”。而现在 thinking 块能不能看到,取决于 display 参数——Claude 5 上它默认是 omitted,你拿到的只有签名,没有内容(上一篇 §4)。想看见得显式写 "display": "summarized"。
3. Agent Loop 的核心:一个 while 循环
伪代码长这样:
1 | function agentLoop(userMessage): |
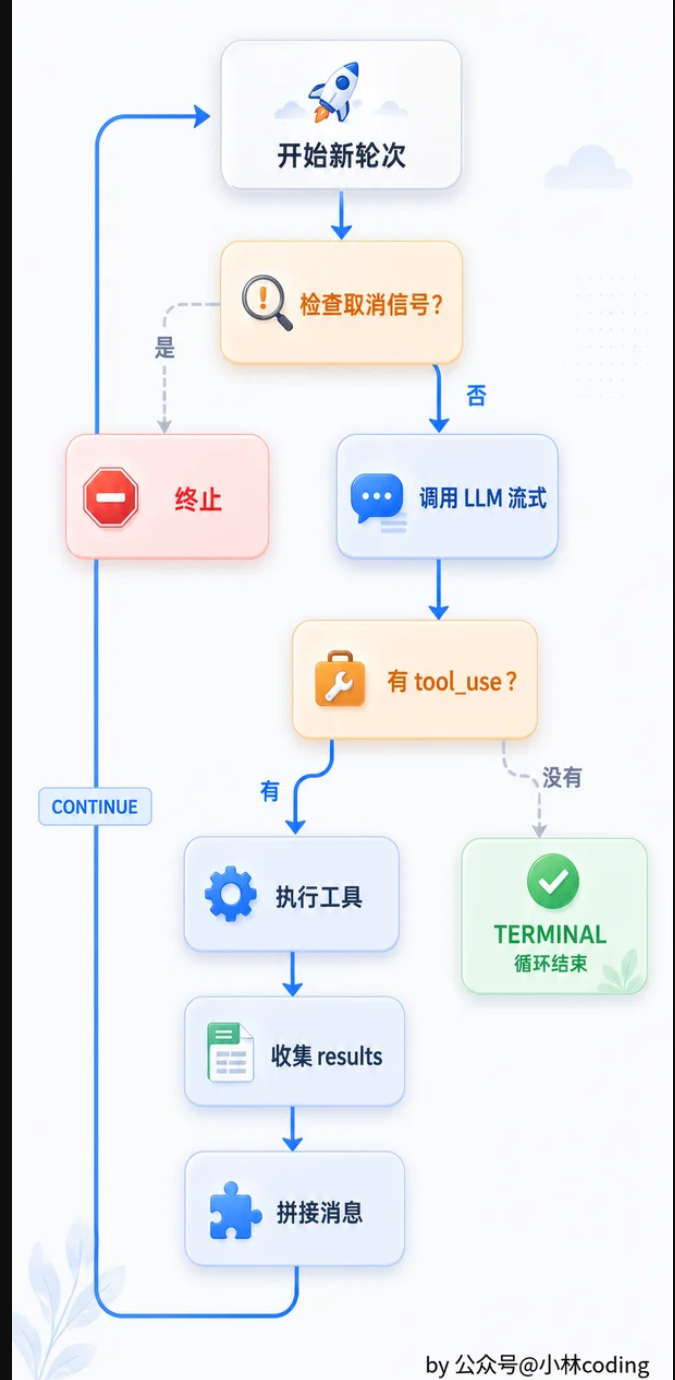
拆开看只有三件事:
- 调模型
- 没要工具就返回 —— 这是唯一的出口
- 要了工具就执行,把结果塞回
messages,回到第 1 步
写成真的代码:
1 | async def agent_loop(client, system, messages, tools, max_turns=20): |
对照着看,有四处在伪代码里看不出来,下面一节逐个说。
4. 这个循环里最容易写错的四件事
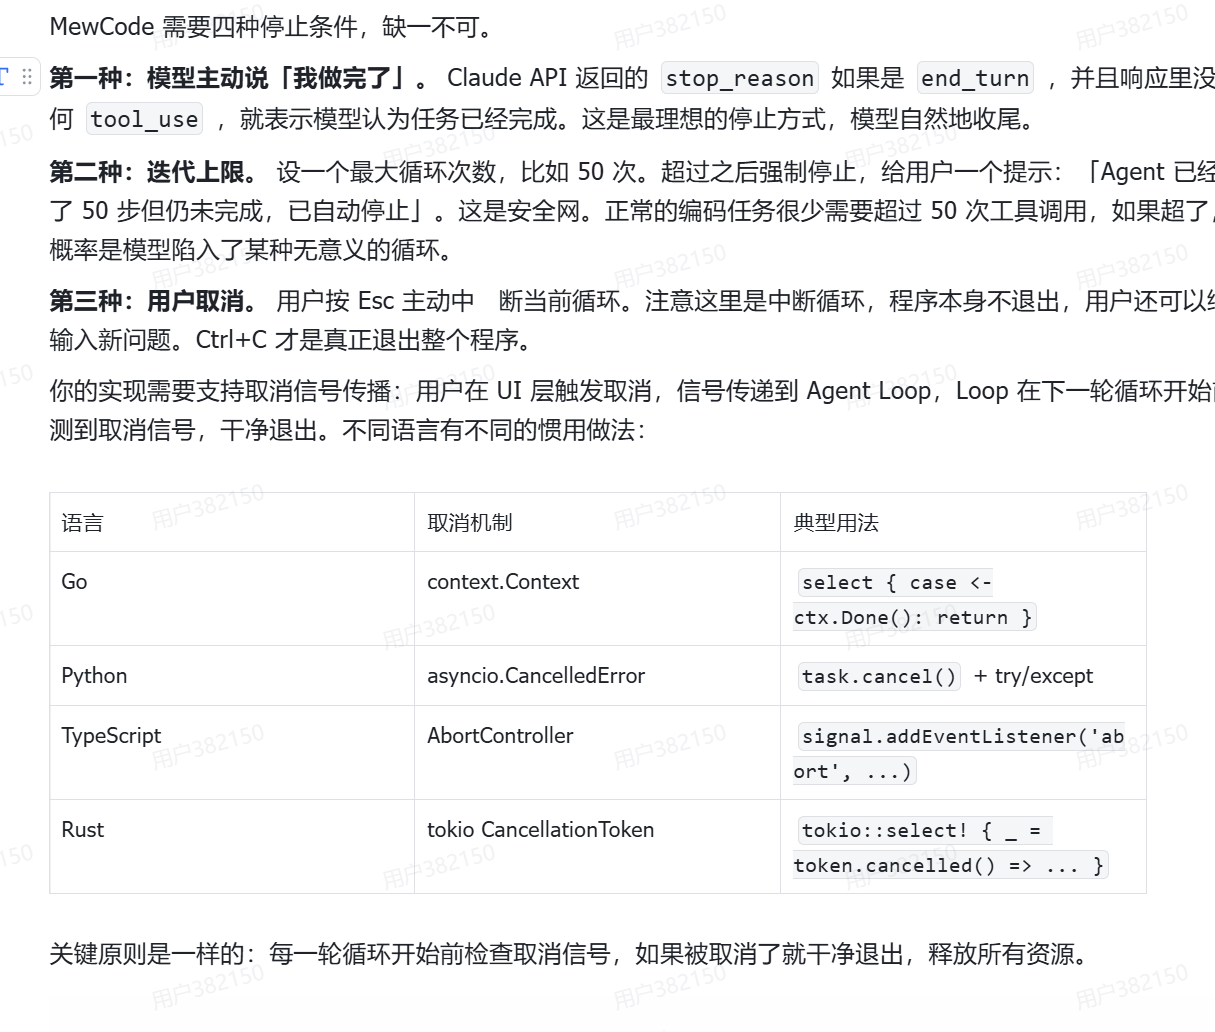
出口条件只有一个:没有 tool_use
循环的终止不看执行了几轮、也不看模型说了什么话,只看这一轮的 content 里还有没有 tool_use。
这带来一个反直觉的结论:模型可能”什么都没干”就结束了。 它返回一段文字、没有工具调用,循环立刻退出——哪怕你的任务压根没完成。
循环不判断”任务做完了没有”,它只判断”还要不要调工具”。 任务完成与否是语义判断,代码层面看不到;只能靠提示词和工具设计去引导。这也是为什么 Agent 的”我帮你做完了”经常不可信——它说这话的依据只是”我不打算再调工具了”。
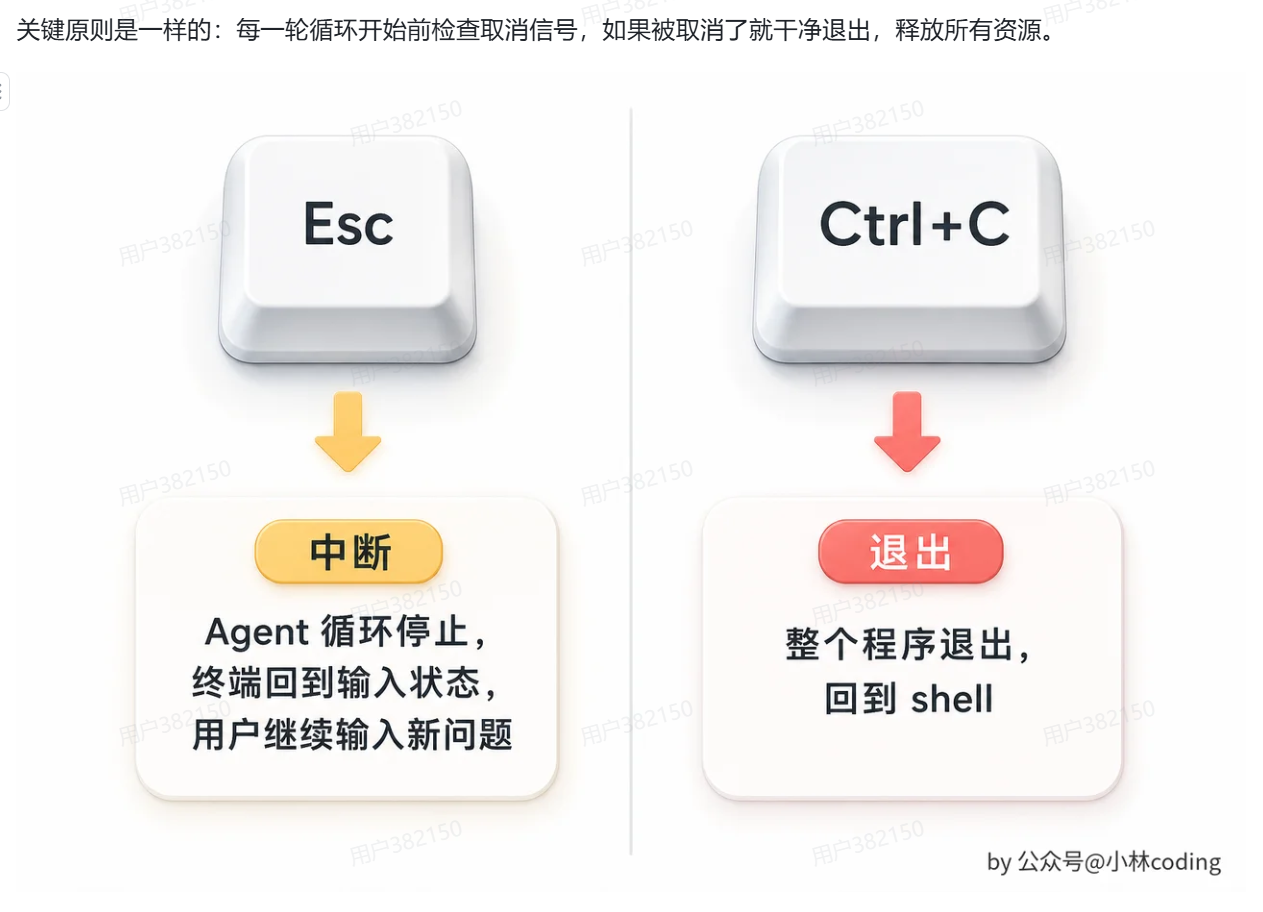
轮数上限不是可选项
while true 加一个会判断失误的模型,就是无限循环。每转一圈都是一次完整的 API 调用,烧的是钱和时间。
上限设多少看任务,常见的是十几到几十轮。触顶之后有两种处理:
- 直接抛错 —— 简单,但用户只拿到一个异常
- 把”我已经试了 N 轮”作为一条消息喂回去,让模型收尾 —— 多花一次调用,但用户至少拿到一句交代
第二种体验明显更好,尤其是上限本来就是”正常情况够用、异常情况兜底”的数字。
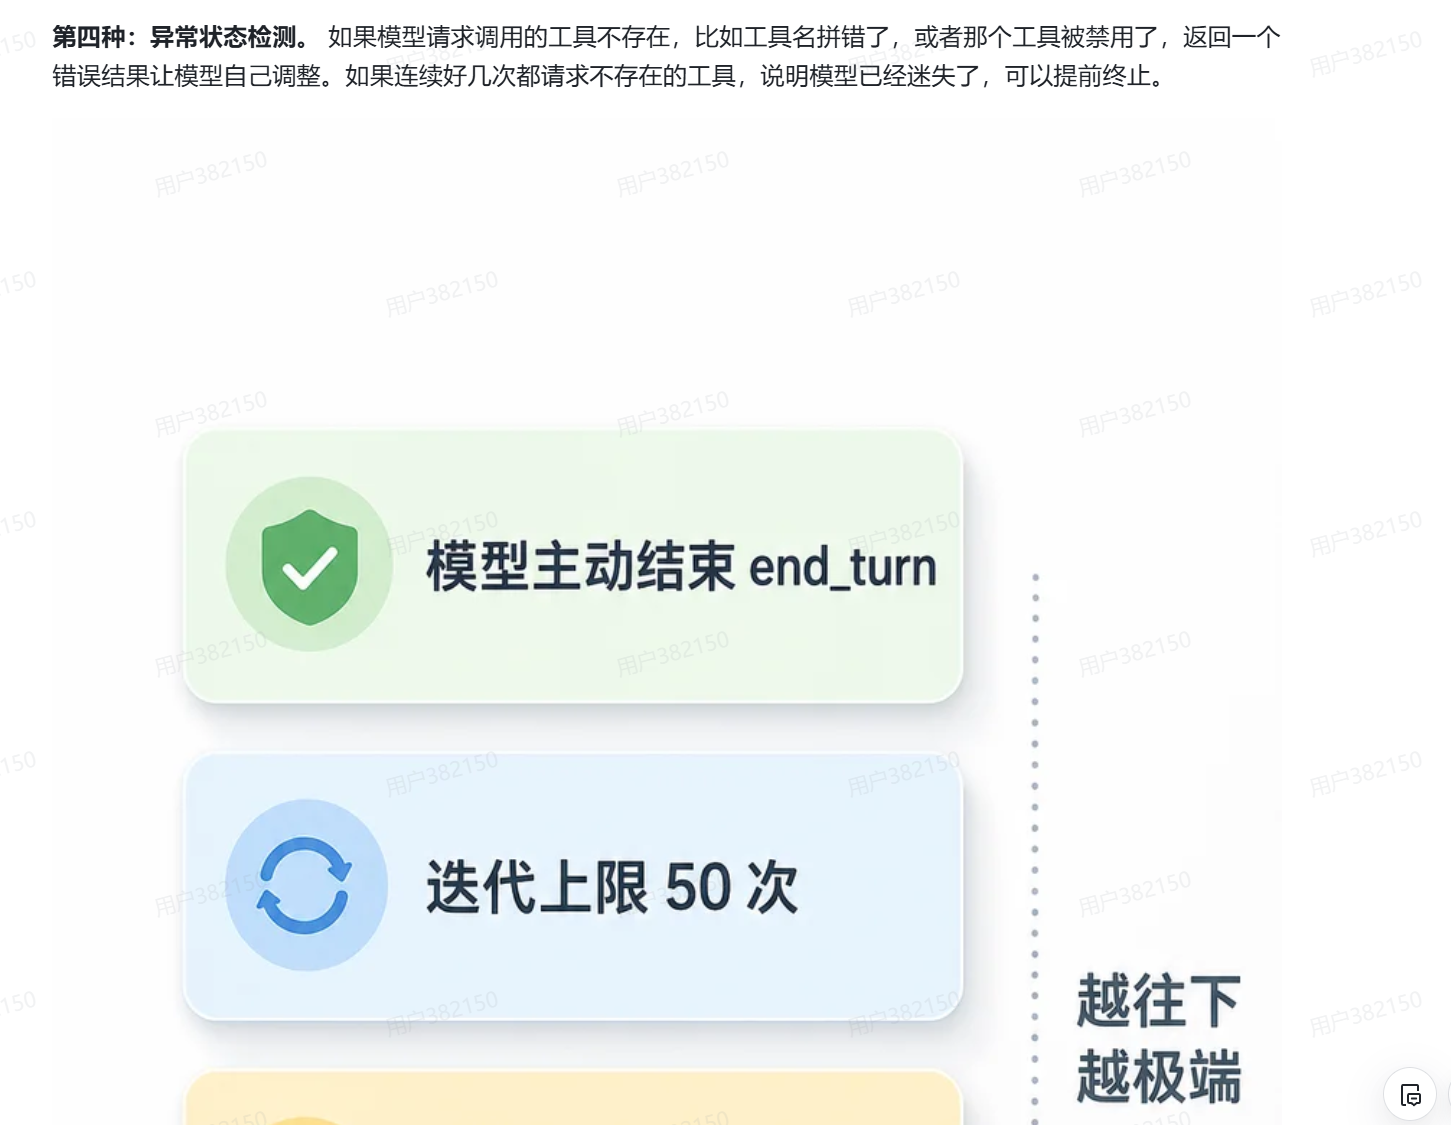
工具失败不要抛异常
tool_result 有一个 is_error 字段,就是为这件事准备的。工具执行失败时,正确做法是把它当成一次成功的结果回传,只是把 is_error 置为 true:
1 | except Exception as e: |
为什么?因为模型看到错误才有机会自己纠正——文件不存在就换个路径去找,参数写错了就改参数,命令报权限不足就换一条。要是你在 execute_tool 里直接把异常抛出去让整个循环崩掉,模型连”我错在哪”都看不到,什么也学不到。
「让模型知道失败」比「让程序知道失败」更重要。 异常是给人看的,is_error 是给模型看的——两条通道都要有。
一轮里的多个工具要一起回
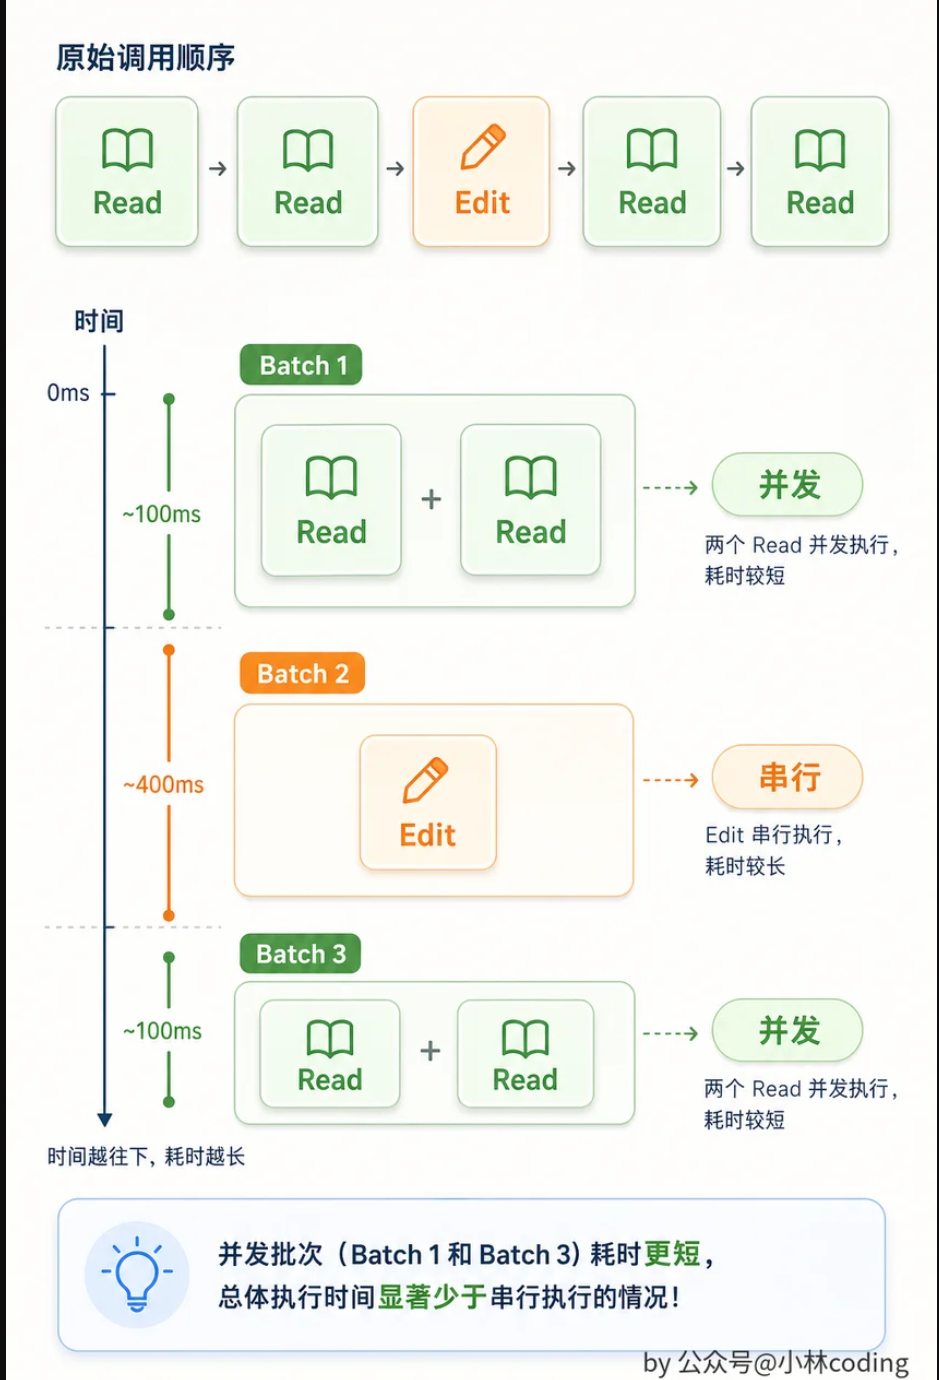
模型可能一次返回多个 tool_use(并行工具调用)。这时候有三个约束:
- 所有结果放在同一条
user消息里。 一条结果发一条user消息,就会变成user、user连在一起,直接撞上上一篇 §3 那个”角色必须交替”的报错 - 每个结果的
tool_use_id必须对上各自的tool_use.id。 模型可能同时要查三个城市的天气,配错一个它就拿着北京的天气回答上海的问题 - 执行顺序可以自己定(并发跑也行),配对靠的是 id 不是位置
5. 上下文为什么越滚越长
messages 是一直往后追加、从不清空的。跑到第 10 轮时,这个数组里躺着:
- 前 9 轮所有的 assistant 消息(含
thinking块和签名) - 前 9 轮所有的工具结果
- 加上这一轮新加的
而且每一轮都要整个发一遍——API 是无状态的,它不记得你上一轮发过什么。 你看到的”对话”,从头到尾都是你自己在维护的一个数组。
这就是 Agent 项目里 token 消耗曲线的形状:不是线性的,是每一轮都比上一轮更贵的平方级。 一个跑了 30 轮的 Agent,第 30 轮的输入 token 可能是第 1 轮的几十倍——不是因为模型变啰嗦了,是因为历史一直在那儿。
缓解手段有四条,代价各不相同:
| 手段 | 做法 | 代价 |
|---|---|---|
| 提示词缓存 | 在 system 和历史前段挂 cache_control |
要求前缀完全稳定——改一个字整段缓存失效 |
| 截断旧工具结果 | 把早期冗长的工具输出换成一句摘要 | 模型可能”忘了”自己看过什么,开始重复劳动 |
| 压缩上下文 | 到阈值时让模型总结前文,替换掉历史 | 细节丢失,而且总结本身要花一次调用 |
| 子 Agent | 把探索型任务丢给子 Agent,只把结论带回来 | 架构复杂度上一个台阶 |
第一条有个连带约束值得单独拎出来:提示词缓存和”原样回传 thinking”是同一个方向的——缓存要求你别改历史的前缀,签名要求你别改 thinking 块。两件事都在说同一句话:
历史一旦写进去,就当它不可变。
6. AgentEvent:为什么不直接把模型事件往上抛
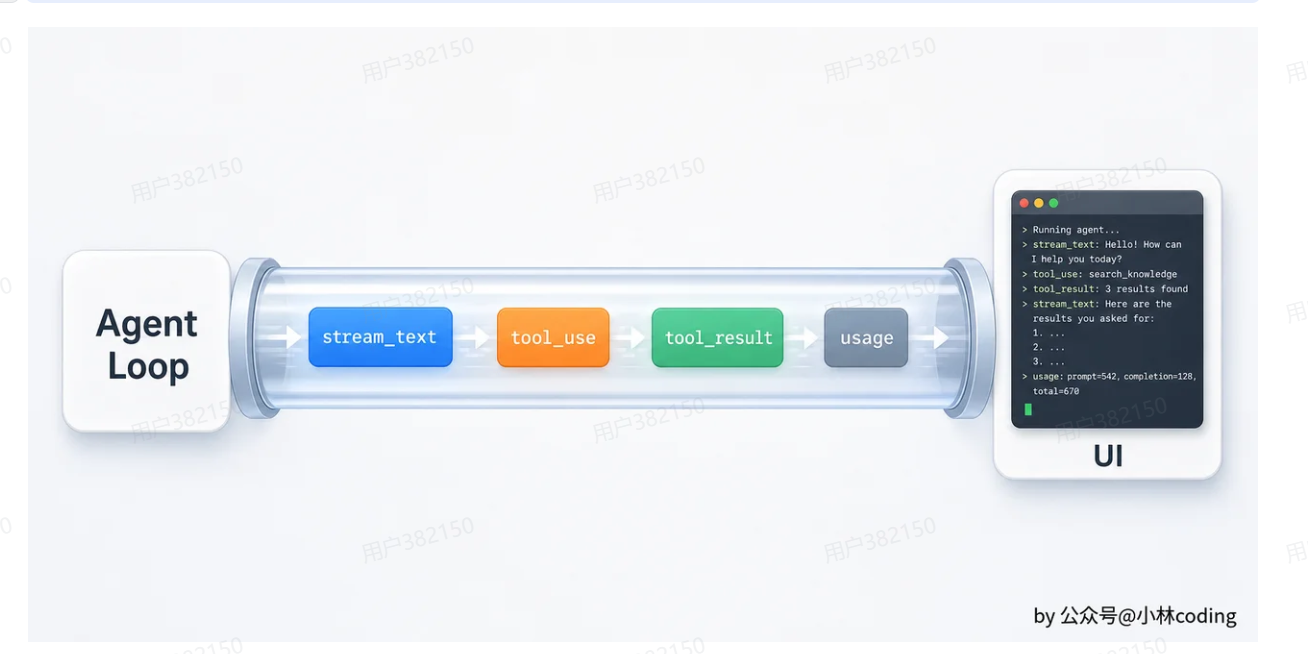
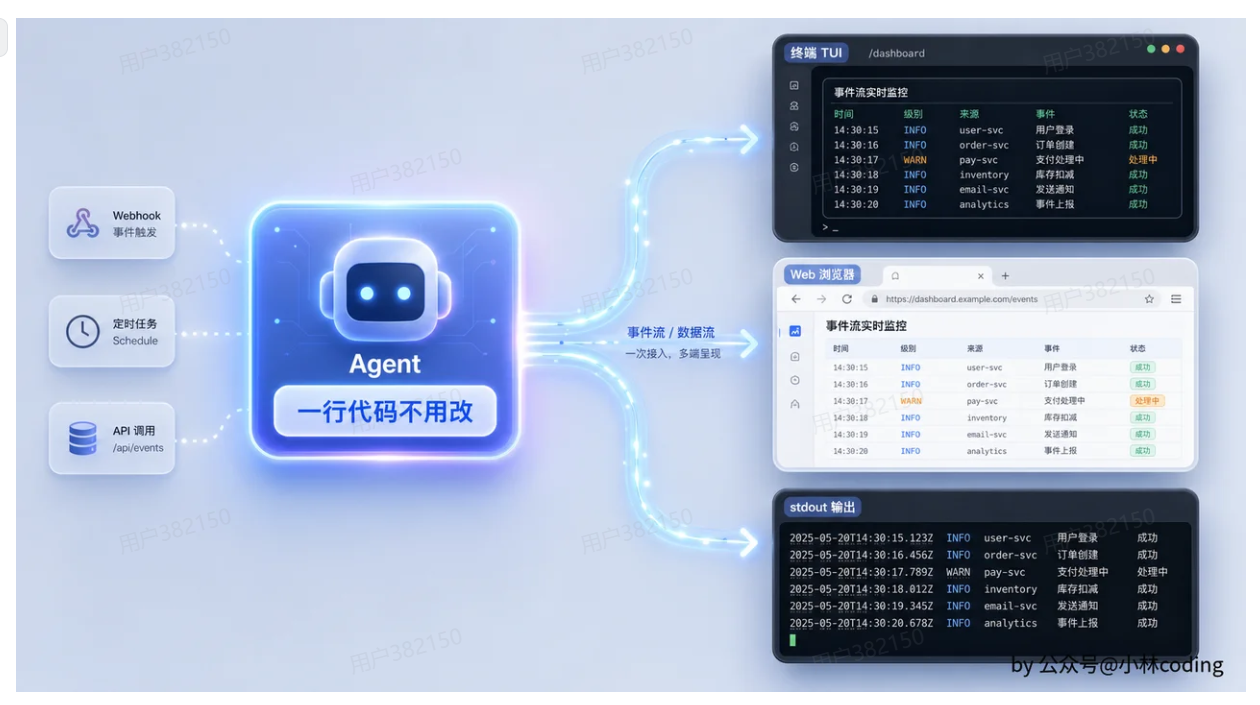
上一篇的流式部分停在”把碎片拼回一条完整消息”。但站在 UI 的角度,它要的恰好不是一条完整消息——它要的是”现在有字出来了,先显示出来”。
所以模型事件和 UI 之间要再加一层:把 LLM 客户端的原始事件,翻译成上层能理解的 AgentEvent。
1 | 模型原始流 ← SDK 给的 SSE 事件 |
两层事件的分工:
| StreamEvent | AgentEvent | |
|---|---|---|
| 对应的东西 | 一次 API 响应 | 一整轮 Agent 循环 |
| 谁产生的 | 模型(供应商定义的形状) | 你自己(领域定义) |
| 粒度 | 碎片 | 语义 |
| 换供应商 | 全变 | 不变 |
为什么不省掉这一层,让 UI 直接消费 StreamEvent。 三个理由:
一、StreamEvent 是供应商的形状。 里面全是 content_block_delta、partial_json 这种 Anthropic 的说法。UI 一旦认了这些字段,换一家模型就要改 UI——把供应商的词汇表挡在客户端这一层,是这层最重要的职责之一。
二、StreamEvent 是碎片的,AgentEvent 是语义的。 一次工具调用在上游是 content_block_start + 二十个 input_json_delta + content_block_stop,到下游应该只剩有意义的那几个:工具调用开始 / 开始执行 / 执行完成。
三、有些事件模型根本不知道。 轮次开始、轮次结束、工具执行完成、整个任务结束、错误——这些不是模型发的,是你的循环产生的。它们只能在这一层补。
一张对照表(接上一篇 §6 那四种 delta):
| 上游 StreamEvent | 下游 AgentEvent |
|---|---|
text_delta |
文本增量 |
thinking_delta |
思考增量 |
signature_delta |
不往上抛,只在客户端内部存着 |
input_json_delta |
工具参数增量(或者干脆等拼完整,一次性抛”工具调用”) |
content_block_start / stop |
块开始 / 块结束,也可以合并成轮次开始 / 轮次结束 |
| — | 工具开始执行(上游没有这个) |
| — | 工具执行完成(上游没有这个) |
| — | 任务结束 / 错误 |
两个设计要点:
signature_delta 不该往上抛。 它是给下一轮请求用的,UI 拿它一点用没有。这类”只在 API 之间搬运”的数据要拦在客户端内部——漏到上层,只会让别人以为它是什么重要的东西,然后开始小心翼翼地存它、传它、最后在某处改坏它。
「工具开始执行」必须自己补一个事件。 上游只告诉你”模型想调这个工具”,真正去执行的是你的循环。不补这个事件,UI 就会停在”模型说要调”和”结果出来了”中间空白几秒——看起来就是卡住了,而实际上它正在老老实实地跑。
7. 完整的数据流
把这一篇和上一篇接起来,一次 Agent 请求从头到尾是这样流的:
1 | 用户输入 |
三条线在这里汇合,各自对应一类问题:
- 消息的线 ——
messages只增不减,每轮整个发一遍 → 上下文管理和成本 - 事件的线 —— SSE 碎片 → StreamEvent → 收集 → AgentEvent → UI → 实时渲染
- 控制的线 ——
while循环 + 出口条件 + 轮数上限 → 什么时候停
8. 小结
一、ReAct 的核心是交替,不是并行。 Thought 不改环境,Action 才改——当年靠提示词约定 + 文本解析,现在 thinking / tool_use / tool_result 是 API 的一等公民。
二、Agent Loop 就是一个 while 循环,出口只有一个。 判断依据是”这一轮还有没有 tool_use“,不是”任务做完了没有”。轮数上限必须有。
三、工具失败要回传,不要抛出。 包成 is_error=True 的 tool_result——让模型知道失败,比让程序知道失败更重要。
四、上下文是平方级增长的,因为 messages 只增不减、每轮全发。缓存、截断、压缩、子 Agent 是四条路,代价各不相同。历史和签名指向同一个约束:写进去就别改。
五、AgentEvent 是给上层的语言。 上游是供应商的碎片,下游要是语义的事件;签名这类搬运数据拦在客户端内部,工具的执行开始 / 结束要自己补。
参考
- ReAct 原论文(Yao et al., ICLR 2023):https://arxiv.org/abs/2210.03629
- 上一篇:https://wywzixin.github.io/agent/llm-request-streaming/
- 工具使用(
tool_use/tool_result/is_error):https://platform.claude.com/docs/en/build-with-claude/tool-use - 提示词缓存(
cache_control):https://platform.claude.com/docs/en/build-with-claude/prompt-caching - Adaptive thinking 与
display:https://platform.claude.com/docs/en/build-with-claude/adaptive-thinking
ReAct 与 Agent Loop