(一)旅行助手的微调数据是怎么来的:从场景生成到工具调用轨迹

背景: 这是我自己的一个旅行项目——一个跑在本地的旅行助手 Agent,基座是 Qwen3-0.6B(RTX 4060),能查攻略(Milvus + RAG)、查天气(和风天气)、查路线(高德地图)。它靠提示词也能调工具,但调用并不稳定,所以我正在基于这个项目做微调。这篇讲数据那一环:训练用的对话轨迹是怎么造出来的。

大模型微调最容易被误解的地方,是把“训练数据”理解成一堆问题和答案。对 Agent 来说,真正要学的是一条可执行的轨迹:什么时候应该追问,什么时候应该调用工具,工具参数如何组织,工具返回后怎样继续工作,最后怎样把结果说给用户。
阅读更多

(二)LoRA 是怎么接进旅行助手的:Qwen3-0.6B 微调脚本拆解

背景: 这是我自己的一个旅行项目——一个跑在本地的旅行助手 Agent,基座是 Qwen3-0.6B(RTX 4060),能查攻略(Milvus + RAG)、查天气(和风天气)、查路线(高德地图)。它靠提示词也能调工具,但调用并不稳定,所以我正在基于这个项目做微调。这篇拆的是训练代码本身。

上一篇文章讲了旅行助手的微调数据如何生成。这篇继续往下看训练代码,专门拆解项目中的 train_qwen_lora.py:模型怎样加载,LoRA 适配器怎样插入,哪些 token 会参与 loss,Trainer 怎样完成训练,以及训练完成后如何使用 LoRA。

阅读更多

(三)旅行助手中的大模型微调:从 Qwen3-0.6B 到可调用工具的本地 Agent

背景: 这是我自己的一个旅行项目——一个跑在本地的旅行助手 Agent,基座是 Qwen3-0.6B(RTX 4060),能查攻略(Milvus + RAG)、查天气(和风天气)、查路线(高德地图)。它靠提示词也能调工具,但调用并不稳定,所以我正在基于这个项目做微调。这篇是总览:从环境准备到本地联调的完整过程。

这次实践得到一个很明确的结论:微调负责让模型学会做事,RAG 负责提供知识,工具负责连接真实世界。 把三件事混成一件事,模型会变得难以调试;把它们拆开,旅行助手的每一步都能单独验证。

阅读更多

LLM 请求与流式响应

一个 Agent 项目里,LLM 客户端这一层看着只是”发请求、收回复”。但一次请求里到底发出去什么、收回来什么,是这一层所有代码的骨架——这件事没理清,后面每个函数都只能照着别人的代码抄。

所以先别急着分层,把一次往返从头走一遍。

阅读更多

ReAct 与 Agent Loop

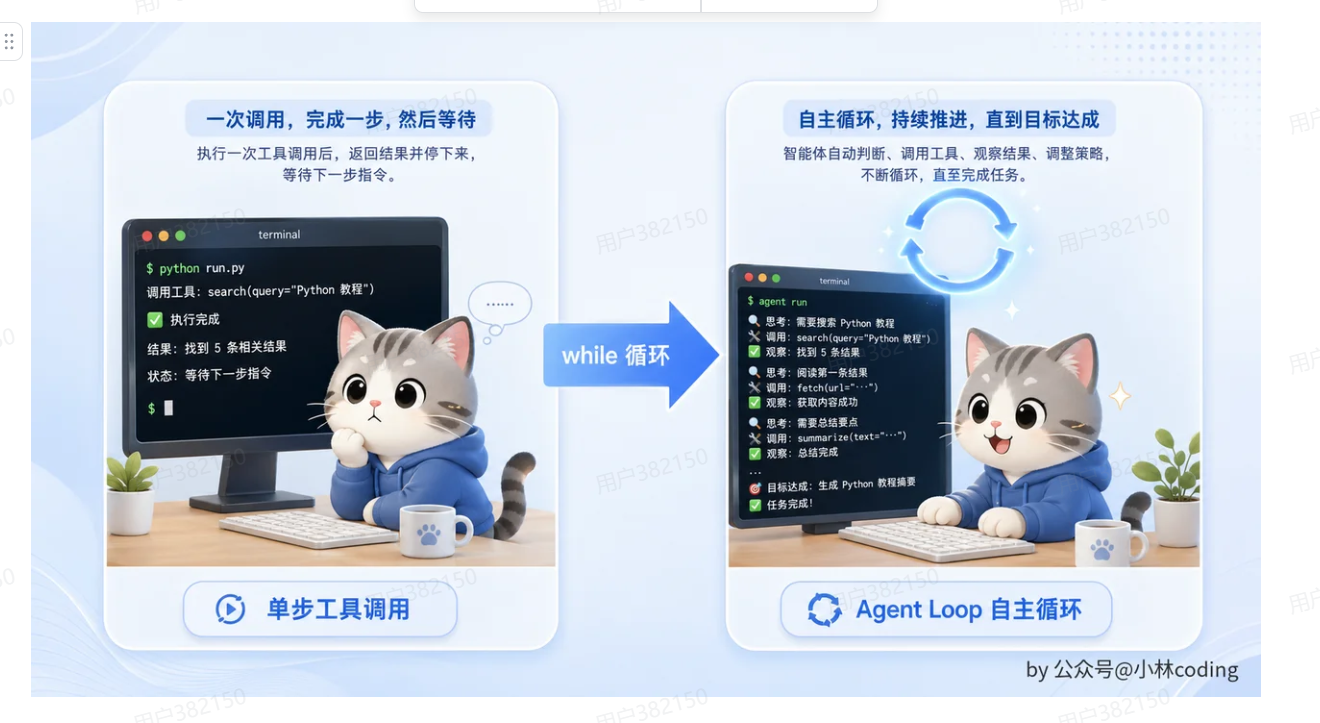
ReAct 是 Reason + Act 的缩写:让模型先想一步、再做一步、看看结果接着想——把推理和行动交替起来,而不是一口气把答案编完。

落地到代码,这个交替就是一个 while 循环:模型自己决定调几次工具、每次调哪个、什么时候停。这个循环通常叫 Agent Loop。

阅读更多

MCP 协议与工具接入

MCP(Model Context Protocol,模型上下文协议)是一套开放协议,用于规范 LLM 应用与外部工具之间的连接方式:应用侧实现 MCP 客户端(Client),工具侧实现 MCP 服务端(Server)。

它的直接收益是:”N 个应用配 M 个工具”所需的 N×M 段适配代码,收敛为 N+M 段。

具体来说:你想让 Agent 能查 GitHub、查数据库、发 Slack,得写三段适配代码(各一套认证、参数格式、错误处理);再写一个跑在 IDE 里的 Agent,又是三段,内容几乎一样;哪天工具那边换个实现,每个 Agent 里都得跟着改一遍——它们明明在做同一件事。

MCP 把这两个方向都解开了:换 Agent,工具侧不用动;换工具实现,应用侧不用动。两边甚至可以是不同的人、用不同的语言写的。

这篇讲这层协议长什么样:分了哪两层、有哪两种传输、一次连接要走哪三步,以及工具接进来之后怎么进到 Agent 的工具表里。

阅读更多

Function Calling介绍

Function Calling(函数调用)是模型的一项输出能力:模型不只输出自然语言,还能输出一段结构化的调用申请——“我要调用这个函数,参数是这些”。

这个名字起得有误导性,先说清楚最容易搞错的一点:

模型不执行任何函数。 它只是把”我想调什么”表达成一个 JSON 对象。真正去执行的永远是调用方——你的代码。

谁做 做什么
模型 决定要不要调、调哪个、参数填什么,输出成结构化数据
你的代码 接收这个申请,执行,把结果发回去

所以更准确的说法是”函数调用申请“。这个往返的完整形状(tool_use / tool_result 怎么配对)上一篇已经拆过了,这里只记住分工:模型负责开口,你负责动手。

阅读更多

上下文压缩与 Token 管理

Agent 的上下文管理分两层:便宜的那层先把大结果挪出上下文,贵的那层用一次 LLM 调用把历史压成摘要。

设计哲学四个字:能轻则轻。轻量手段能扛住的,绝不动用昂贵的全量摘要。

第 1 层:大结果存磁盘 第 2 层:全量摘要
信息损失 几乎为零 高
API 开销 零 高(多一次 LLM 调用)
定位 便宜的预防 贵但强的兜底

问题本身上一篇已经说清了:messages 只增不减、每轮整个发一遍,token 消耗是平方级增长(ReAct 与 Agent Loop §5)。而上下文窗口是个硬数字——200,000 就是 200,000,超了 API 直接拒绝。

所以不能等它涨到极限,得主动管。

阅读更多

Agent 记忆系统

Agent 的记忆分两层:工作记忆是上下文窗口,只活在当前会话里;长期记忆落在磁盘上,跨会话有效。

长期记忆有三种形态,区别在于谁写的:

形态 是什么 谁写的
项目指令文件 预先写好的项目知识和编码规范 人,写一次
会话持久化 每一轮对话的原始记录 系统,自动追加
自动记忆 从对话里提炼出的偏好、纠正、项目事实 Agent 自己,边用边攒

三种形态最后都变成一段文本,走同一条管线注入到请求里。它们不是三个独立的功能,是同一件事的三个来源。

上一篇讲的是上下文窗口装不下怎么办(上下文压缩与 Token 管理)。这一篇讲另一半:什么东西不该只活在窗口里。

阅读更多

RAG 检索增强生成

RAG(Retrieval-Augmented Generation,检索增强生成)是在生成之前先检索:拿用户的问题去知识库里捞出相关片段,把这些片段和问题一起拼成新的输入,再交给模型生成回答。

它结合了两件事:信息检索(Retrieval)负责从外部知识库找材料,文本生成(Generation)负责把材料组织成回答。

注意这里没有发生的事:没有训练,没有改模型的任何一个参数。 模型拿到的还是那一段文字,只是这段文字里多了它本来不知道的东西。

这是理解 RAG 的关键,也是它所有优点和缺点的来源。最后 §6 会回到这一点上:RAG 本质上是一次 prompt 重构。

阅读更多