北斗网格性能优化(七):Tile、缓存与资源回收
Tile 是一块可以独立加载、绘制和回收的空间数据,一个 Tile 可以包含成千上万个网格实例。 它把大区域拆成可管理的批次,让视口筛选、Worker 生成和 GPU Instancing 使用同一种处理粒度。
LRU(Least Recently Used)是一种优先淘汰最久没用过的数据的缓存策略。 地图浏览有很强的时间局部性 —— 刚离开的地方常常很快又要看;保留最近用过的 Tile,就能省掉重新生成和上传。
这套北斗网格的做法是:块离开活动集合后先尝试进缓存,进不去就直接销毁;缓存的准入同时受块数、网格数和层级三个维度限制,超出时按 lastUsedAt 淘汰最旧的;共享的单位立方体几何用引用计数,最后一个使用者退出才真正销毁。
分块决定一次工作有多大,缓存决定哪些工作可以复用,回收决定资源能不能长期保持可控。
为什么一个实例集合还不够
第二篇的 Instancing 已经解决了「每个格子单独提交」的问题。但如果把整个区域的所有格子装进一个巨大的实例集合,新的麻烦立刻出现。
假设一个区域有 100 万个格子,相机只看到其中很小一角。整个集合的包围体仍然可能与视锥相交,渲染器在集合这一层就没法把其余数据排除。相机移到另一边时,也没法只生成和替换相关部分。上传和回收同样受影响:一大块数据要一起准备,容易形成加载峰值;只想释放远处的一小片,又找不到合适的资源边界。
所以在实例化之上还要加空间分块。每个 Tile 保存自己的一批实例和包围体,公共立方体几何仍然共享。
1 | 区域中的全部网格 |
这时调度器面对的是几十到几百个空间块,GPU 在每个块内处理一批实例。管理粒度和绘制粒度之间有了清楚的分工。
块太大和太小各自坏在哪
块太大,单次生成、消息传递和 GPU 上传的峰值都上去,包围体也更粗 —— 可能因为一小部分进入视野就带入许多暂时用不到的网格。
块太小,队列项、消息数、渲染对象和命令数一起增加,缓存还要管更多条目,共用的调度开销被反复支付。
| Tile 大小变化 | 得到什么 | 付出什么 |
|---|---|---|
| 变大 | 管理对象与批次数量减少 | 单次工作变重,筛选变粗 |
| 变小 | 按需加载更细,单次工作更可控 | 消息、命令和缓存条目增加 |
分块没有一个脱离场景的最佳常数。L6 的数据量相对可控,可以按区域工作量反推块大小;L7 细化同时放大横向和高度两个方向,所以改用固定的微块加切片(第六篇)。层级不同,合适的分块方式也不同。
L6:从目标工作量反推块大小
_resolveTileGridSizeForArea 就是这件事的全部实现。它先估算区域在 baseLevel 下有多少格子,再决定一个基础 Tile 横向跨几格:
1 | // ViewportGridManager.ts |
拆开看是四步:
- 估算总量 = 列数 × 行数 × 高度层数 × 有效面积比例。
- 期望块数 =
clamp(ceil(总量 / 12000), 1, 64)。 - 每边单元数 =
sqrt(列数 × 行数 / 期望块数)—— 这里用的是平面格子数,不乘高度,因为块只在水平方向切。 - 钳到最小 8 个单元。
有效面积比例是天真的「多边形面积 ÷ 包围盒面积」会被很细长的区域压得过低,所以钳在 0.25 到 1 之间:
1 | return Math.min(1, Math.max(DEFAULT_MIN_FILL_RATIO, polygonArea / bboxArea)); |
注意这里和第 1 步的 zCount 有个不对称:高度进入了总量估算(所以高瘦的区域会被认为工作量大、块会切得更细),但不进入每边单元数的计算(因为块不切高度)。结果是高度越大的区域,水平块反而越小 —— 这是对的,一块的总量才受高度影响。
举个具体例子。包围盒 64×64 个 L6 单元,高度 33 层,有效面积比例 0.5:
- 总量 = 64 × 64 × 33 × 0.5 = 67,584
- 期望块数 = ceil(67584 / 12000) = 6
- 每边单元数 = ceil(sqrt(64×64 / 6)) = ceil(sqrt(682.7)) = ceil(26.1) = 27
按 27 个单元的步长切割,横纵各需要 3 块,形成最多 9 个候选位置,再保留与多边形实际相交的那些(GridTileIndex 里的 turf.booleanIntersects)。
所以 12000 是估算目标,不保证每块恰好拥有这个数;64 限制的是期望块数,区域形状和边界切割还会影响最终块数。这些常数都是量级参考,不是硬性配额。
L6 基础块覆盖区域的完整高度范围,没有像 L7 那样再按 32 层切高度 —— 这一点在第六篇对比过,是两者最直观的区别。
缓存为什么必须同时限制块数和网格数
不同 Tile 的数据量可以差一到两个数量级。一个满的 L7 切片有 8192 个实例,区域边缘被裁过的块可能只有几十个。
只设「最多缓存 100 块」,块数达标了,内存早就超了;只限制网格总数,又会留下一大堆很小的块,白白增加渲染对象和管理开销。所以缓存的准入同时看两个维度,而且每个层级还各有一套:
1 | // ViewportGridManager.ts —— _tryMoveToCache |
示例配的额度是:
| 范围 | 缓存块数上限 | 缓存网格上限 |
|---|---|---|
| 全局 | 340 | 400,000 |
| L5 | 60 | 80,000 |
| L6 | 80 | 120,000 |
| L7 | 200 | 200,000 |
层级预算的用途很具体:防止 L7 把缓存挤满。 如果没有 L7 那 200 块 / 20 万格的上限,近景浏览产生的几百个细块会占掉全部容量;相机一拉远,需要 L5、L6 的粗块时,缓存里全是被淘汰后重新生成的份。源码默认值里没有层级配置(?? maxCachedTiles 会退回全局额度),所以这是示例特意加上去的。
淘汰的顺序也有讲究:先在本层级内部腾,再在全局腾。 一个新 L7 块进来时,优先淘汰最旧的 L7 块,不去动刚加载好的 L5。
放不进去就不放
_tryMoveToCache 返回 false 的那条路径值得单独说:腾完空间还是放不下,这个块就不进缓存了。
调用方拿到 false 之后直接销毁:
1 | // ViewportGridManager.ts —— _deactivateEntry |
这是一种「准入」思路,而不是「先塞进去再想办法」。一个块如果大到单块就超过预算,把它留在缓存里只会让淘汰循环永远在临界点上抖动 —— 每来一个新块就要赶走好几个旧块,命中率反而更差。不如让它走完整生命周期:需要时重新生成。
这也说明缓存的容量配置不是「越大越好」的调参题。单块规模超过容量上限时,该改的是分块参数(让它切小一点),而不是把容量调大。
淘汰是 O(K) 的线性扫描
LRU 的核心是找 lastUsedAt 最早的那个。项目直接扫:
1 | // ViewportGridManager.ts |
时间复杂度 O(K),K 是缓存块数。几百个块的规模下,线性扫描足够快,而且比哈希表配双向链表更好写、更好调 —— level 参数这种「只在某一层里找最旧」的过滤,在链表结构里要额外维护每层的子链表。
如果缓存条目涨到几万个并且频繁淘汰,再考虑换成 O(1) 的维护方式。现在这个规模不值得。
更新 lastUsedAt 的地方有两个:激活一个块时设成当前时间,以及相机仍在看某个已激活的块时刷新:
1 | private _touchActiveEntry(cacheKey: string, now: number): void { |
「从缓存移除」和「销毁」是两件事
缓存这一层最容易写错的地方是资源释放。项目把它们拆成了两个方法:
1 | // ViewportGridManager.ts |
_removeCacheEntry 只动账本 —— 从 Map 里摘掉、把计数减回去。它不碰 GPU 资源,因为「不在缓存里」和「不该存在」完全是两回事。
命中缓存时走的正是这条路径:
1 | private _restoreFromCache(cacheKey: string): void { |
块还是那个块,primitive 和它已经上传的 GPU 缓冲原封不动,只是账从「缓存」挪到了「活动」。这就是缓存能省下时间的全部原因 —— 省掉的是重新生成、重新传输、重新上传。
_destroyEntry 的第二个参数也有讲究:removeFromScene = true 时强制从 scene.primitives 移除;false 时先问一句 contains(),避免对一个已经不在场景里的 primitive 重复移除。这类防御在「同一个 entry 可能从多条路径被清掉」的代码里是必要的。
活动预算按距离,缓存淘汰按时间
这两个判断经常被混成一件事,其实服务的对象完全不同。
活动预算管的是「这一帧要画什么」。 超过 maxActiveGrids 时,循环 deactivate 距离最远的 entry,直到总网格数回到预算内。判断依据是相机距离 —— 因为远处的东西对当前画面最不重要。
LRU 管的是「以后还要不要用」。 缓存内部按 lastUsedAt 决定保留谁,判断依据是时间。
一个块可以因为「太远」而退出活动集合,却因为「刚刚还在看」而留在缓存里。反过来,一个很久没碰过的近处块也可能在缓存紧张时被淘汰。两者分别服务当前视图和后续复用,不是同一套排序。
共享几何要等最后一个使用者退出
多个 Tile 共用单位立方体的顶点和索引,这些资源不能随着任意一个 Tile 的淘汰就销毁 —— 否则其他块还引用着它,接下来的绘制就会出问题。
第二篇提到的 _sharedBuffersByContext 是按 (context, geometry) 键控的共享表,用引用计数管理:
1 | // BeiDouGridPrimitive.ts —— _acquireSharedBuffers(节选) |
1 | // BeiDouGridPrimitive.ts —— _releaseSharedBuffers |
配套的还有一处容易被忽略的设置:
1 | // 关键:摘掉 VertexArray 对这些 buffer 的所有权 |
Cesium 的 VertexArray 默认会认为自己拥有这些 buffer,销毁顶点数组时顺手把它们也销毁。但这里是共享的 —— 一个 Tile 的顶点数组被销毁,不该带走其他 Tile 还在用的几何缓冲。vertexArrayDestroyable = false 就是把这层所有权摘掉,交给引用计数来管。
各资源的归属关系是这样的:
| 资源 | 归属 | 释放时机 |
|---|---|---|
| 单位立方体顶点、索引 | 多个 Tile 共享 | 引用计数归零 |
| 实例矩阵、颜色缓冲 | 对应 Tile 独占 | Tile 真正销毁 |
| 拾取资源 | 对应实例或 Tile | 对应数据不再保留 |
| 引擎缓存的 Shader | 引擎管理共享引用 | 使用者归还引用 |
Shader 走的是 ShaderProgram.fromCache,即使来自引擎缓存也要按引擎约定归还引用。共享意味着需要协调释放,不意味着永远不释放。
同样的坑在 Three.js 里也有:移除 Mesh 和 dispose Geometry、Material 是不同动作;共用 Geometry 时更不能在移除一个对象后立刻 dispose。API 不同,判断所有权的思路是一样的。
隐藏一个块不等于释放一块显存
缓存里的 Tile 持有 CPU 数组、GPU Buffer、顶点数组和拾取资源。_deactivateEntry 做的第一件事是 entry.primitive.show = false —— 这只是停止显示,不会自动删除任何资源。
这正是缓存能变快的原因:已经做过的准备工作还在。代价则是即使相机看不见它,内存也仍然占着。
同一个热缓存会话里的两个视角能看出这种分配:
| 视角 | 活动网格 | 缓存网格 | 两者合计 |
|---|---|---|---|
| L5 总览 | 20,708 | 223,038 | 243,746 |
| L7 近景 | 132,814 | 110,932 | 243,746 |
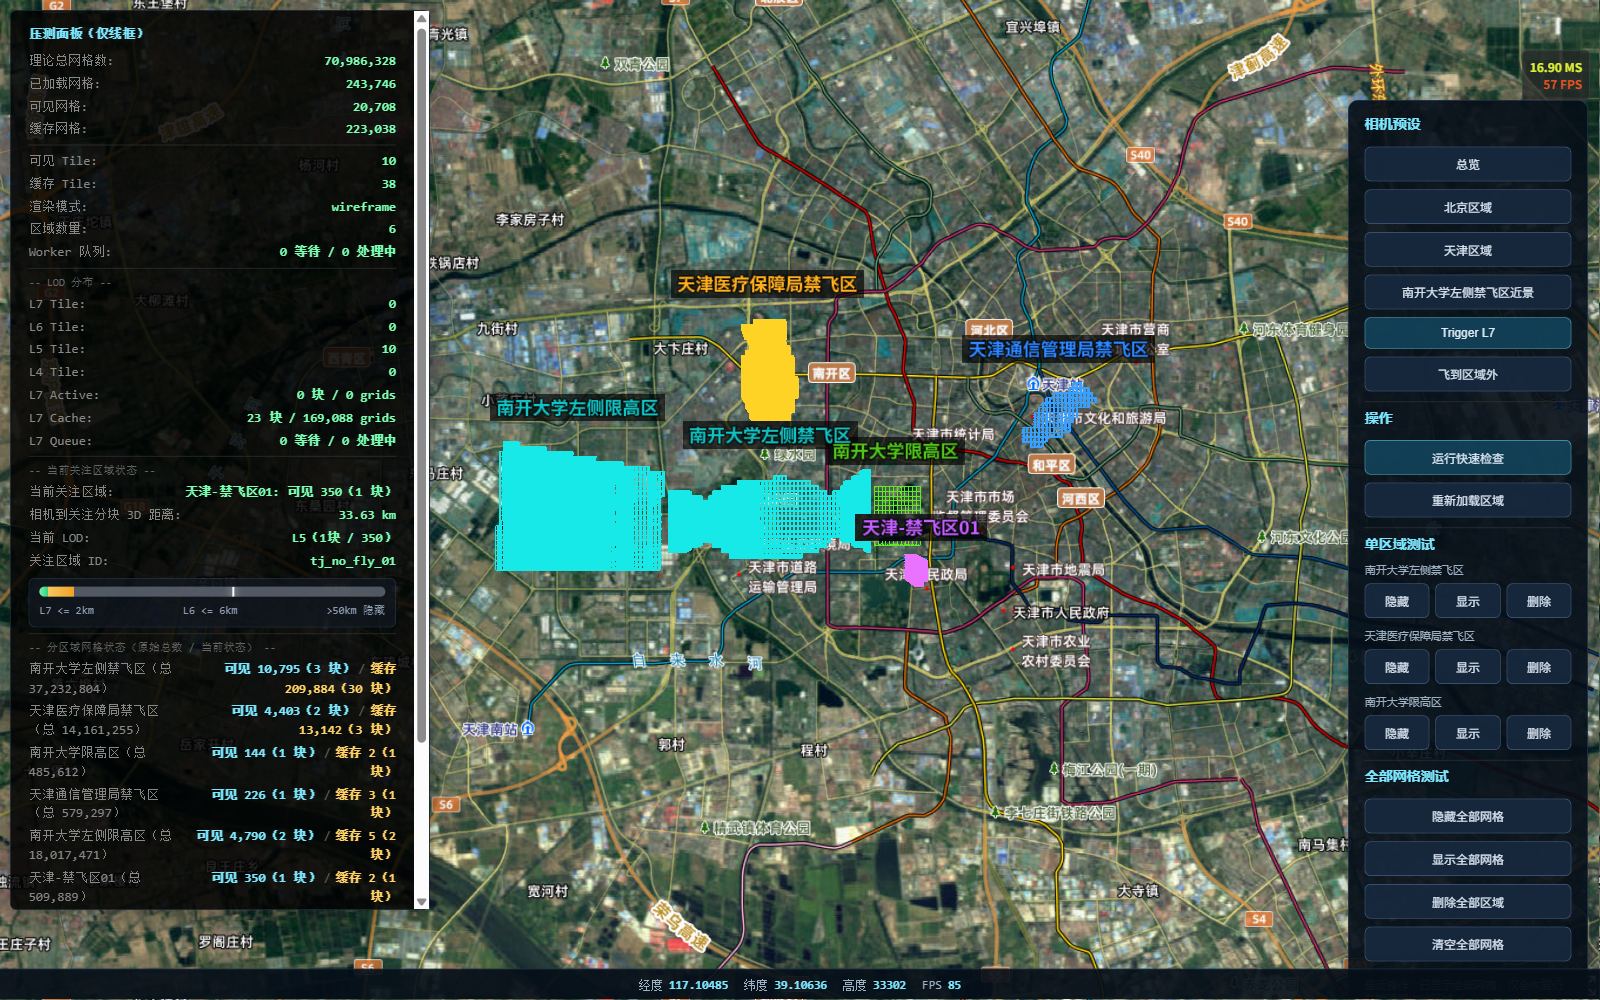
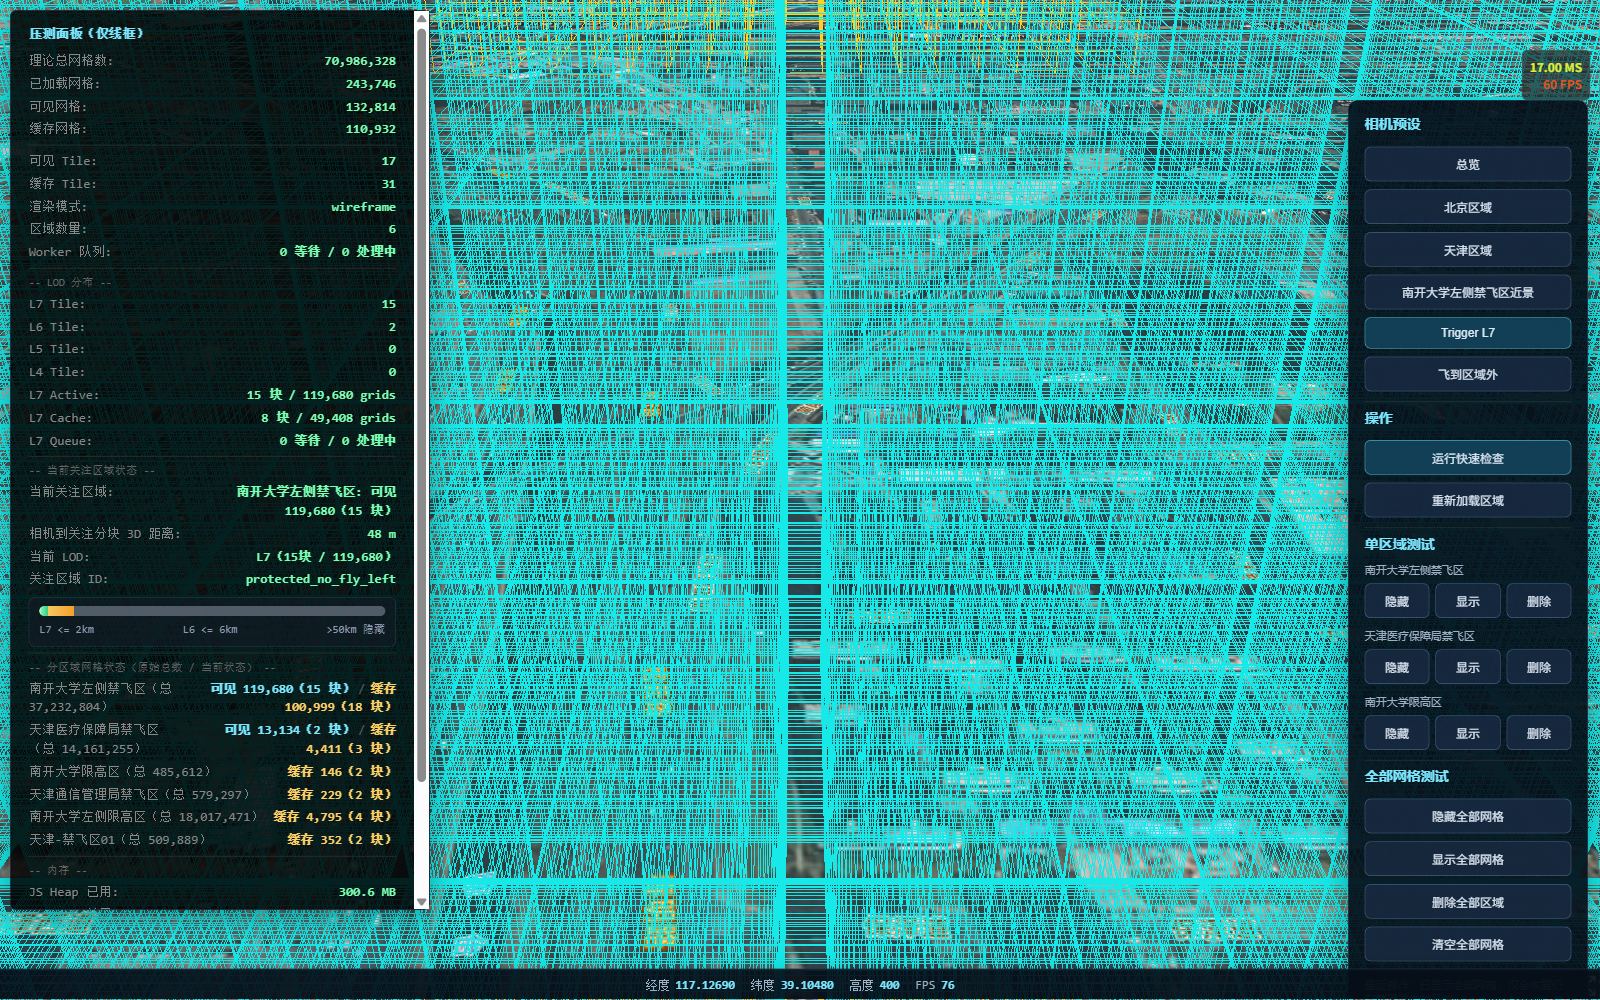
两张图来自同一个已有缓存的运行会话,画布均为 1600×1000。它们用于观察活动与缓存的状态变化,不是冷启动和热启动的性能对照。
相机变化后,活动和缓存的分配整个换了一遍,总数却基本不变 —— 这个观察支持「块在两种状态之间迁移」,但不能仅凭总数相同就推断每个新活动块都命中了缓存。要量化复用效果,还得记录命中次数和重新生成次数。
另外,这里用的是块数和实例数这两个易于维护的尺度,不是字节数。每个网格的编码字符串、辅助数组、拾取资源,以及 GPU 资源是否已经创建,都会影响真实内存。要严格按内存做预算,需要额外统计这些成本 —— 那是另一套账。
怎样判断缓存是真的有效
适合观察缓存的方式是沿固定路线 A → B → A 浏览。同样的视口、层级和显示模式下,比较第一次和第二次进入 A:
- 有多少块直接恢复,有多少块重新生成。
- 首批画面出现需要多久。
- GPU 上传是否减少,集中上传是否仍会造成停顿。
- 活动量和缓存量是否符合预算。
- 多次往返并触发淘汰后,资源占用是否逐渐稳定。
这些指标分别对应命中、延迟、上传和容量。只看内存比刚启动时高,判断不出泄漏 —— 缓存本来就在保留资源;只看再次进入很快,也会忽略容量一直增长的问题。
显存释放还可能经过驱动和正在执行的命令,监测值未必在删除对象的那一刻立刻下降。更值得关注的是多次完整加载、缓存、淘汰周期之后的趋势。
还有一个正确性上的坑:缓存键属于正确性的一部分。如果区域标识没变,但边界、高度范围或生成条件变了,必须清理对应旧缓存,或者把数据版本纳入键。否则命中的是旧结果,速度再快也不符合新的业务需求。项目在移除区域时一次性清掉该区域的所有缓存条目和相交缓存,走的正是这条路。
系列读完了
七篇下来,整条链路是这样的:
- 总体架构 —— 七千万个格子和十八万的活动预算,问题从这里来。
- GPU Instancing 与 DrawCommand —— 一批格子怎么变成一次绘制,每实例 80 字节。
- LOD 与视锥剔除 —— 哪些块值得生成,哪些格子不需要那么细。
- Web Worker 与 Transferable —— 生成搬到别的线程,四个 buffer 零拷贝回来。
- RTE 与局部坐标系 —— 大数减大数在 CPU 双精度里做完,GPU 只碰小差值。
- L7 的水平微块与高度切片 —— 512 倍怎么在三个方向上被拆开。
- Tile、缓存与资源回收 —— 块怎么产生、复用、以及最终怎么归还。
每一篇都指向同一件事:不要让七千万同时存在。 不是把格子画得更快,而是让每一刻真正存在的,只有当前这一眼需要的那十几万个。
北斗网格性能优化(七):Tile、缓存与资源回收
https://wywzixin.github.io/beidou-grid-performance/07-tiles-cache/