北斗网格性能优化(一):总体架构
背景: 我国正在发展低空经济,我们做的是飞行服务(飞服)项目,要把低空空域划成能计算、能查询、能下发的单元。选的是北斗网格:按经纬度和高度把地理空间编码成一个个三维盒子,一个编码对应一块确定的空间范围。在 Cesium 里加载 L5、L6、L7 三档网格,给一个多边形和一段高度范围,就能把落在里面的格子填出来,得到一块禁飞区或管控区。三档的水平格边长依次约 123.7、61.8、7.73 米:比 L5 粗的看不出区域形状,比 L7 细的在这个业务尺度上没有意义。
原因: 麻烦来自多出来的那个方向。二维地图只要横向铺满,三维还要按高度一层层堆;而且高度步长不是独立参数,它由水平步长推出来,水平细一倍、高度也跟着细一倍。L6 到 L7 每边 8 倍,三个方向乘起来就是 512 倍 —— 换一档不是画得密一点,是同一片空间里的格子数量直接乘 512。
压测示例用了六个真实的天津、北京管控区,它们在 L7 下的理论总量是 70,986,328 个格子;而视口配的活动预算上限是 180,000,也就是任何一帧最多允许约 0.25% 的格子存在。剩下那 99.75% 必须永远不落地 —— 因为瓶颈不在光栅化,在生成:这些格子还没开始画,光实例矩阵和颜色就是 7000 万 × 80 字节 = 5.68 GB。
所以整套方案的目标不是把格子画得更快,而是让每一刻真正存在的,只有当前这一眼需要的十几万个。
用到的技术: GPU Instancing 共享一份盒子几何,按实例画一批格子;自定义 DrawCommand 把填充和线框接进 Cesium;RTE 在近景保住米级精度;视锥剔除 加上距离选层,挡住视野外和够不着的细节;L6 按工作量分块,L7 再切水平微块和高度切片,把单次任务压到大约 8192 个实例;Web Worker 把生成搬出主线程;LRU 缓存 让刚看过的块能直接复用。
后面六篇会拆开写。这篇先把整条链路过一遍,懒得往下翻的话,看完这篇也对每项技术有个印象。
数量是怎么爆的
二维地图只算横向,三维网格多了一个可以自由伸缩的高度方向,数量按体积走。
L6 的经纬度步长是 2 角秒,L7 是 0.25 角秒,水平每边细化 8 倍。高度步长不是独立的参数,而是从水平步长推出来的:
高度步长 = 水平经度步长 × 40075017 / 360。
所以水平变细时高度也跟着细。L6 到 L7,水平 8 倍、高度 8 倍,三个方向乘起来:
8 × 8 × 8 = 512。
「再细一档」不是让同样的盒子画得密一点,而是让同一片空间里的格子数量直接乘 512。六个区域在 L7 下的理论量:
| 区域 | 高度范围 | L7 列×行×层 | 理论网格数 |
|---|---|---|---|
| 南开大学左侧禁飞区 | 0–2000 m | 793×263×260 | 37,232,804 |
| 南开大学左侧限高区 | 0–600 m | 670×402×79 | 18,017,471 |
| 天津医疗保障局禁飞区 | 0–2000 m | 212×373×260 | 14,161,255 |
| 天津通信管理局禁飞区 | 6–200 m | 303×203×27 | 579,297 |
| 天津-禁飞区01 | 0–3000 m | 36×60×390 | 509,889 |
| 南开大学限高区 | 100–200 m | 182×197×14 | 485,612 |
| 合计 | 70,986,328 |
这七千万不是数出来的,是估出来的:列数 × 行数 × 层数 × 有效面积比例,最后一项是「多边形实际面积 ÷ 包围盒面积」,扣掉包围盒里空出来的部分。表里第一个区域的 37,232,804 是示例写死的枚举值(KNOWN_GRID_COUNTS),其余五个是运行时估算的 —— 用同一套算式去估算第一个区域会得到 37,337,939,和写死值只差 0.28%。这个精度足以支撑「先估算、再决定要不要生成」的调度策略,后面会看到整个调度器就是靠估算在生成之前做取舍的。
有一点要提前说清:估算函数在三个轴上都用了 ceil(跨度 / 步长) + 1,这是偏保守的高估(表里的列数、行数、层数都是这么来的);而引擎实际切片时用的是 floor(...) + 1,比估算少一个。两者的差别在第六篇会具体到那一层上。
看这张表,最值得注意的一对是最后两行。南开大学限高区平面覆盖 182×197 格,但高度只有 100–200 米,才 14 层;天津-禁飞区01 平面只有 36×60 格,比前者小 16 倍,但高度拉到 3000 米,要切 390 层。结果后者总量反而更多:509,889 对 485,612。高度范围是业务给的,引擎没法替你收敛 —— 一块地图上几乎看不见的地皮,只要高度拉得够高,总量就能追回来。
一个口径说明:这一系列的数字都来自压测示例
example/only3d/stressTestCustomZonesL7Poc(1).html,不是源码默认值。示例对viewportGrid做了整体覆盖(比如maxActiveGrids默认 150,000、示例配 180,000;lodThresholds默认最远一档是「不加载」、示例配到 L4)。后面几篇提到「示例配置」时,指的都是这个示例。
一次性生成会同时压住好几段:编码、多边形裁剪、矩阵打包、主线程接结果、GPU 上传,最后每帧还要画。所以后面所有技术,都是在回答同一件事:不要让这七千万同时存在。
高空看过去,活动量可以压到两万左右,大部分结果躺在缓存里:
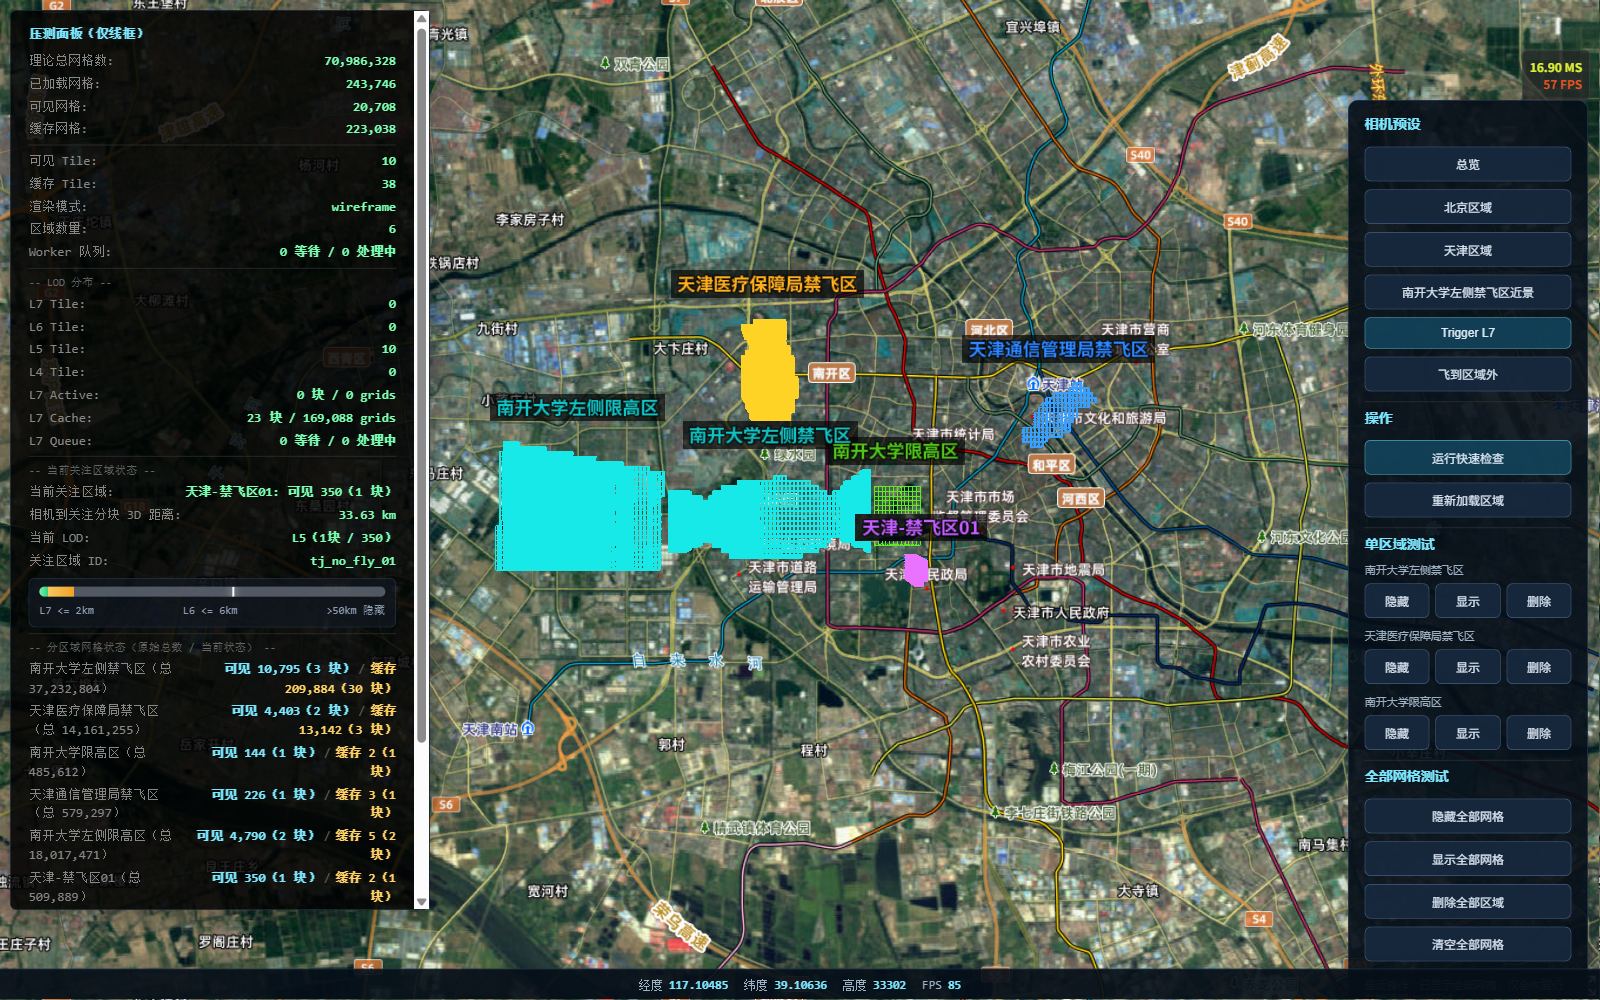
实际示例截图,画布 1600×1000,已有缓存的会话。此时活动网格 20,708 个,分布在 10 个 L5 Tile;223,038 个网格处于缓存中。面板「可见网格」统计的是参与活动管理的实例数,不等于屏幕上逐个可见的格子数。
GPU Instancing
GPU Instancing 是一种批量绘制技术:多个物体共享同一份几何,每个物体只提供自己的变换、颜色等实例属性,GPU 用这一份几何按实例属性重复绘制,一批物体对应一次绘制提交。Three.js 的 InstancedMesh 就是这项技术。
当前视口里可能有十几万个网格盒子,它们的几何完全相同,差异只在位置、尺寸和颜色。如果每个盒子是一个 Cesium Entity 或一个 Mesh,对象数量就等于格子数量,引擎要按对象分别组织绘制,提交次数随格子数量线性增长。
所以这些盒子用 Instancing 画。项目按 Tile 分组:一块内的格子共享一份中心在原点的单位立方体几何,每个格子提供一份变换矩阵和一份颜色,整块做一次实例化绘制。不同块分开提交,因为剔除、显示和缓存都以块为单位。
它减少的是绘制提交次数和重复的几何存储,不减少要画的实例数 —— GPU 仍要逐实例处理顶点变换。实例数由后面的视锥剔除、层级选择和活动预算控制。
自定义 DrawCommand
DrawCommand 是 Cesium 对一次绘制任务的描述,指定用哪份几何、哪些顶点属性和实例属性、哪个着色器,以及深度测试、颜色混合等渲染状态。Cesium 每帧执行的就是一个 DrawCommand 列表;Entity 和 Primitive 最终也会被引擎转换成 DrawCommand。
Instancing 解决的是「怎么批量画相同几何」,要在 Cesium 里用上它,还得自己决定三件事:实例矩阵怎么按 Tile 上传、着色器里怎么用相对相机的坐标(就是后面要讲的 RTE)、填充面和线框能不能分开开关。这三件默认路径都给不了 —— Entity 面向少量独立物体,内置 Primitive 的坐标变换和渲染状态按引擎默认走。所以这里直接创建 DrawCommand 提交给渲染循环。
每个 Tile 最多两个命令:一个用三角形索引画盒子的六个面,走半透明 pass;一个用 12 条边的索引画棱,PrimitiveType.LINES。两条命令共用同一批 instance buffer,只有索引缓冲和着色器不同,所以只显示线框时不必重传任何实例数据。
线框还有一个容易被忽略的细节:它带一个随距离淡出的着色器 LOD。BeiDouGridPrimitive 里有 u_visibleDistance(视口侧传 10000),远处的线框会逐渐变暗,免得密集边线在远景糊成一片噪声。
RTE
RTE(Relative-To-Eye) 处理的是大世界坐标的浮点精度。Cesium 用 ECEF 地心坐标,单位是米,地表附近的分量达到几百万。32 位浮点在 640 万这个量级上,相邻两个可表示数大约相差 0.5 米 —— 而 L7 的格子才 7.73 米。0.5 米的舍入,在近景就是边线抖动、相邻块对不齐。
关键不在于用什么技巧,而在于把「大数减大数」挪到 CPU 的双精度里做。顺序错了就白搭:如果先转成 Float32 再相减,低位在相减之前就已经丢了,后面提高片元着色器精度也救不回来。
项目给每个 Tile 选一个参考中心,块内格子的实例矩阵只存相对该中心的 ENU 局部坐标(东、北、上),不存 ECEF 平移。CPU 每帧用双精度算「参考中心 − 相机位置」,作为 uniform 传给着色器;着色器只乘 czm_viewRotation 这个纯旋转矩阵 —— 平移已经在 CPU 那边减掉了,再乘一次完整视图矩阵会把相机位置减两遍。
好处是相机移动时只需要更新一个 vec3。一个 L7 切片有 8192 个实例,重算并上传 8192 份矩阵和更新一个 uniform,是完全不同的工作量。
RTE 的收益随块的大小递减:块跨得越大,块内的局部坐标本身越大,就越接近原来的问题。这也是分块要同时服务调度和精度的原因。
视锥剔除
视锥是透视相机的可见空间,由左、右、上、下、近、远六个平面围成。视锥剔除就是用简单包围体代替一整块数据的复杂几何,去和这六个平面比。
这是整条链路里唯一一个作用在生成之前的技术。GPU 自带的裁剪只作用于已经提交的图元 —— 等走到那一步,编码、矩阵计算、缓冲区上传都已经做完了。
项目分两层测。先用区域的 OBB(有向包围盒)和视锥比:完全在外就跳过整个区域,完全在内就直接接受它的所有子块、不必逐个再测,相交时才逐个测 Tile 的包围体。区域优先用 OBB 是因为地表区域往往狭长又倾斜,包围球会留出大量空白,视锥稍微碰到球就得继续往下查。
GridTileIndex.ts 里构造 OBB 用的是 Cesium.OrientedBoundingBox.fromRectangle(rectangle, minHeight, maxHeight),注释写明这么做的理由:为了正确剔除「水平方向在视锥外、但相机位于其球形包围体内」的 Tile。相机贴近地表时,包围球的球心可能落到地表以下,球体把相机整个包进去,于是永远和视锥相交 —— 这一条只有真的在地上跑过才想得到。检查本身也做了节流,间隔 DEFAULT_FRUSTUM_CHECK_INTERVAL = 200 毫秒。
进入视锥的块还要决定用哪一档网格。项目用相机到 Tile 中心的三维距离选层级,而不是只用相机高度,所以面前的块和几公里外的块可以不是同一档:
| 相机到 Tile 中心的距离 | 层级 |
|---|---|
| 不超过 1500 米 | L7 |
| 不超过 6000 米 | L6 |
| 不超过 50000 米 | L5 |
| 更远 | L4(示例中的配置) |
以块中心为参考,计算简单。代价是块中心越过阈值时整块一起切换,块边缘的格子实际距离会有偏差。
视锥剔除减少的是视野外的生成和绘制,它不处理遮挡 —— 被楼房、地形挡住的 Tile 仍然在视锥内,仍然要生成。深度测试只决定像素的前后关系,不会替主线程取消任务。
L6 分块
空间分块把一个大区域划成若干空间块(Tile),每块可以独立生成、绘制、隐藏和回收。Instancing 在块内批量绘制,视锥剔除按块测试,Worker 按块计算,缓存按块复用。
如果把一个区域的全部 L6 格子放进同一个实例集合,包围体就覆盖整片区域,只要一角进入视锥,其余数据也会被带上;相机移到另一侧时也没法只替换相关部分。固定边长的分块同样不合适 —— 区域有的接近方形、有的细长,高度层数也不同,同一套固定尺寸会让有的块过大、有的过碎。
所以 L6 按区域预估工作量反推水平块大小。先估算包围盒在 L6 下的列数、行数和高度层数,乘一个有效面积比例得到预估总量;以每块约 12000 个格子为目标算出期望块数,钳制在 1 到 64 之间,再开方得到每边的 L6 单元数,最小 8。有效面积比例本身也钳在 0.25 到 1,避免很细长的区域把估算压得过低。
12000 这个目标对应「一次 Worker 任务」和「一次实例化绘制」希望达到的规模:再大则单次峰值过高,再小则任务和绘制命令过多。
L6 只切水平方向,高度一次覆盖该区域的完整范围。这套块不适用于 L7 —— L7 在同样的水平范围内细了两个数量级,沿用它会让单次任务过大。
L7 分块
L6 到 L7 是 512 倍,所以 L7 要在水平和高度两个方向继续切。
水平方向,一个微块每边跨越 2 个 L6 步长。L6 到 L7 每边是 8 个单元,所以一个微块是 16×16 = 256 根竖直方向的网格柱。微块按固定经纬度间隔对齐,这样相邻的两个基础块看到同一片空间时会算出相同的行列编号,缓存、去重、重新加载都用同一个键。
高度方向,每根柱子按最多 32 个采样层分成一片。满片规模 16×16×32 = 8192 个实例,正好对应一次实例化绘制希望处理的数量。
以高度 0 到 2000 米、L7 高度步长 7.730520 米为例:总采样层数 floor(2000 / 7.730520) + 1 = 259,每片最多 32 层,需要 ceil(259 / 32) = 9 片 —— 前 8 片各 32 层,最后一片 3 层。相机在低空时,只需要加载附近的高度片,不必一次生成整根柱子。
相邻微块共用边界上的格子只归属一侧,避免重复实例。一块 L7 数据的标识由「区域、层级、微块行列、高度片编号」组成,Worker、活动集合和缓存都用这个标识。
L7 分块让细网格可以按水平和高度分别排队、占用预算和进入缓存,但它不取消活动上限 —— 近景 L7 仍受预算限制,视野中可能同时存在尚未细化的 L6:
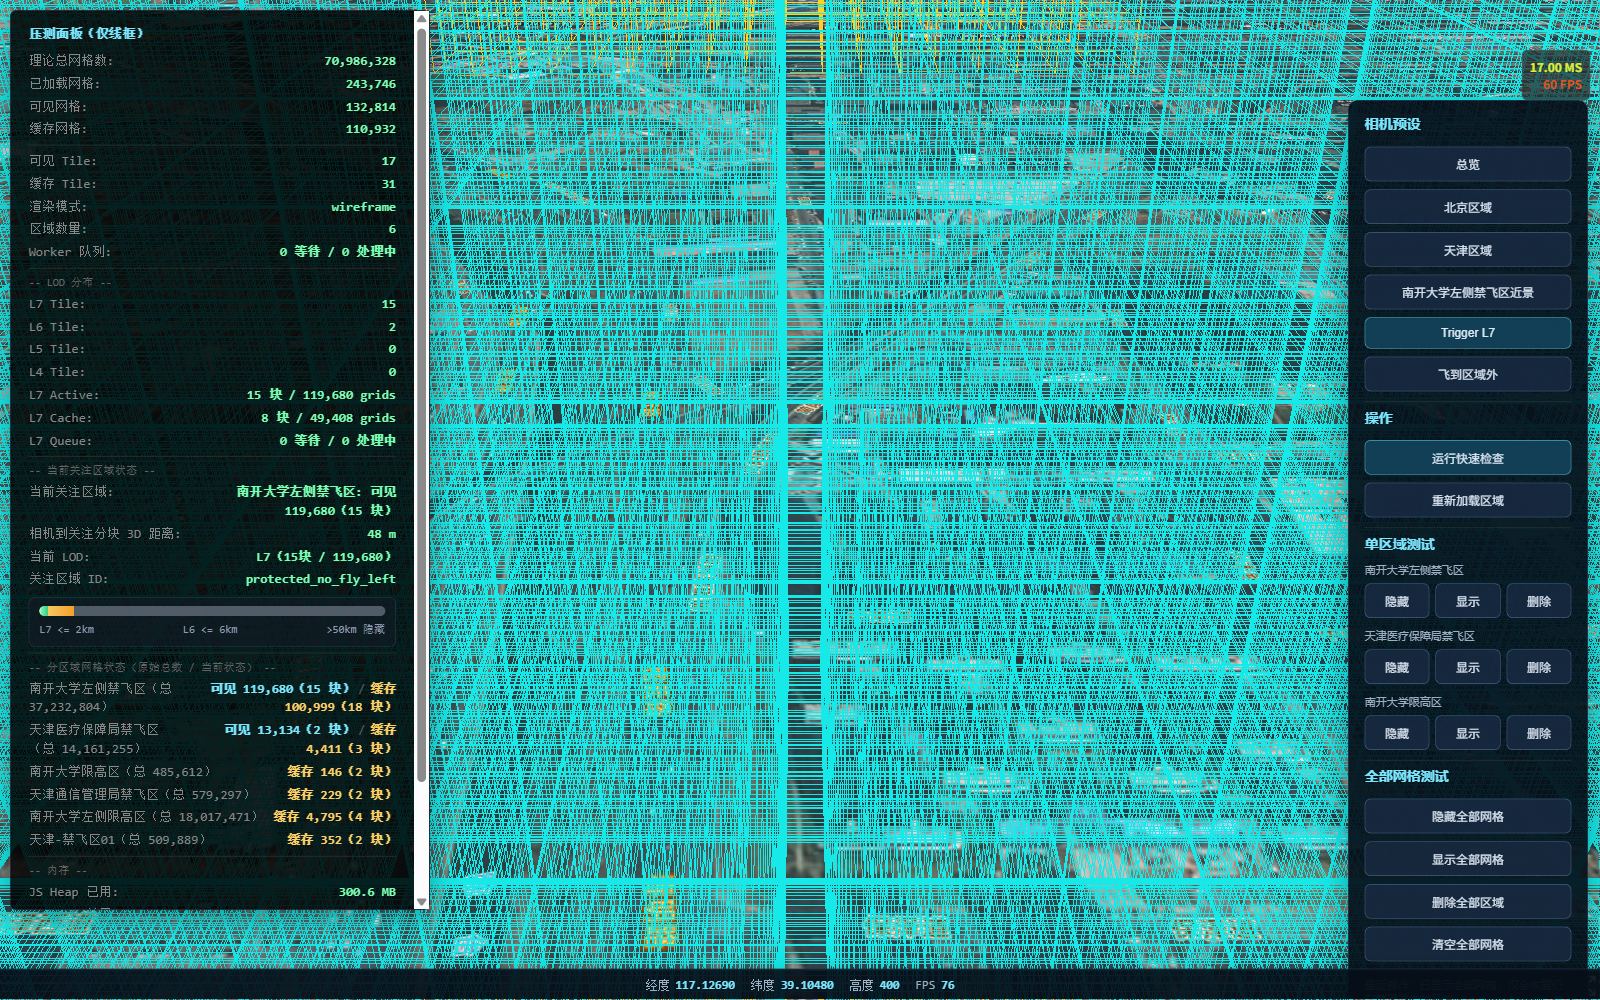
Web Worker
Web Worker 是浏览器里独立于页面主线程的 JavaScript 执行环境,主线程通过消息派任务、收结果;Worker 不能访问 DOM,也不能直接用 Cesium 的 WebGL 上下文。
已加载的网格可以画得很流畅,但相机进入没生成过的区域时主线程仍会卡顿 —— 网格生成是编码、裁剪、矩阵计算连成的 CPU 循环,占着主线程期间,相机拖动和下一帧提交都被推迟。把它放进 Promise.then 没用,那还是在主线程。
Transferable 用来在线程之间转移 ArrayBuffer 的所有权:缓冲区不复制,发送方失去访问权,接收方直接拿到这块内存。Worker 返回的四组类型化数组 —— 实例矩阵、颜色、网格索引、占用标记 —— 就是这么移交的。
项目只用一个 Worker(workerCount: 1,实现固定单 Worker),主线程前面配一个按距离排序的队列。用单 Worker 是为了避免两个副作用:每个 Tile 建一个 Worker 会有大量线程启动开销;多个任务同时完成会让主线程在同一时刻收到一大批数组并集中上传 GPU。队列这边有几道处理:同一时刻只发一个任务,等结果回来再发下一个;入队时按距离排序并去重;每轮更新把已经不再需要的任务剪掉;超过上限时从队尾丢 —— 也就是丢掉最远的那个。
它把生成搬出主线程,不减少计算量。GPU 上传仍然在主线程完成,Transferable 只免掉线程之间的复制,不会把数据直接变成显存。
LRU 缓存
LRU(Least Recently Used) 是一种缓存淘汰策略:容量不足时优先删除最久没被使用的数据,依据的是最近一次使用时间,而不是累计访问次数。
地图浏览有很强的时间局部性 —— 刚离开的地方常常很快又要看。如果块一离开视口就销毁,相机转回来就得重新生成、传输、上传一遍。
只限块数不够。一个满的 L7 高度片有几千个实例,区域边缘的块可能只有几十个,同样 100 个块,内存占用能差一个数量级;反过来只限网格总数,又会留下一大堆很小的块,白白增加对象和绘制命令开销。所以缓存同时使用块数上限和网格数上限,并且按层级分别限额,避免 L7 占满全部缓存后,切回远景时没有 L5、L6 可以复用。
再次需要某块时,缓存命中就直接恢复显示,已经创建的 GPU 资源继续用。超出任一上限时按 lastUsedAt 找最旧的淘汰 —— 这里是 O(K) 扫描,几百个块的规模足够直观,也方便结合层级和数量一起判。
淘汰必须真正释放该块的实例缓冲区。多个 Tile 共用的单位立方体几何用引用计数管理:一个块开始使用时加一,退出时减一,最后一个使用者退出才销毁,并顺手把 vertexArrayDestroyable 设成 false 防止顶点数组被误删。
缓存中的块仍然占用内存 —— 隐藏一个块不会自动释放 GPU 资源,只有走到淘汰路径上的显式释放才真正归还。这正是缓存能变快的原因:已经做过的准备工作还在。也正因为如此,估内存要按网格数而不是块数 —— 块数只是规模指标,真实字节数还得算上编码、辅助数组和拾取资源。
处理顺序
相机变化之后,各项技术按下面的顺序工作:
- 用视锥测试区域和 Tile,用相机到块中心的距离选 L5、L6 或 L7。
- L6 按工作量划分水平块;L7 再划分水平微块和高度切片。
- 按活动预算截取候选,近处优先;相机移动期间暂缓新增 L7。
- 缓存命中的块直接恢复显示。
- 未命中的块进入 Worker 队列,生成实例数组。
- 主线程用实例数据创建 DrawCommand,着色器按 RTE 计算相对相机的位置。
- 离开视锥的块进入 LRU 缓存,超出缓存预算后释放资源。
区域理论网格可以达到千万级。某一帧真正处于活动状态的,是预算限制下的十几万个实例。后面六篇按 Instancing 与 DrawCommand、LOD 与视锥、Worker、RTE、L7 切片、Tile 与缓存的顺序分别展开。