Three.js 如何解析 URDF 机器人模型
机器人可视化的第一步,是把一个 URDF 文件变成 Three.js 场景里能渲染、能动的东西。
这件事听起来像是「加载一个模型」,但 URDF 根本不是模型文件。它里面没有顶点、没有法线、没有材质贴图,只有一个 XML 骨架,描述机器人由哪些刚体组成、这些刚体怎么连起来。真正的几何体(STL、DAE)是另外的文件。
所以 Three.js 要做的,是把这套「关系描述」翻译成一棵 Object3D 树。这篇分两部分:先讲 URDF 到底描述了什么,再逐段拆 URDFLoader 的源码,看它每一步在干什么。
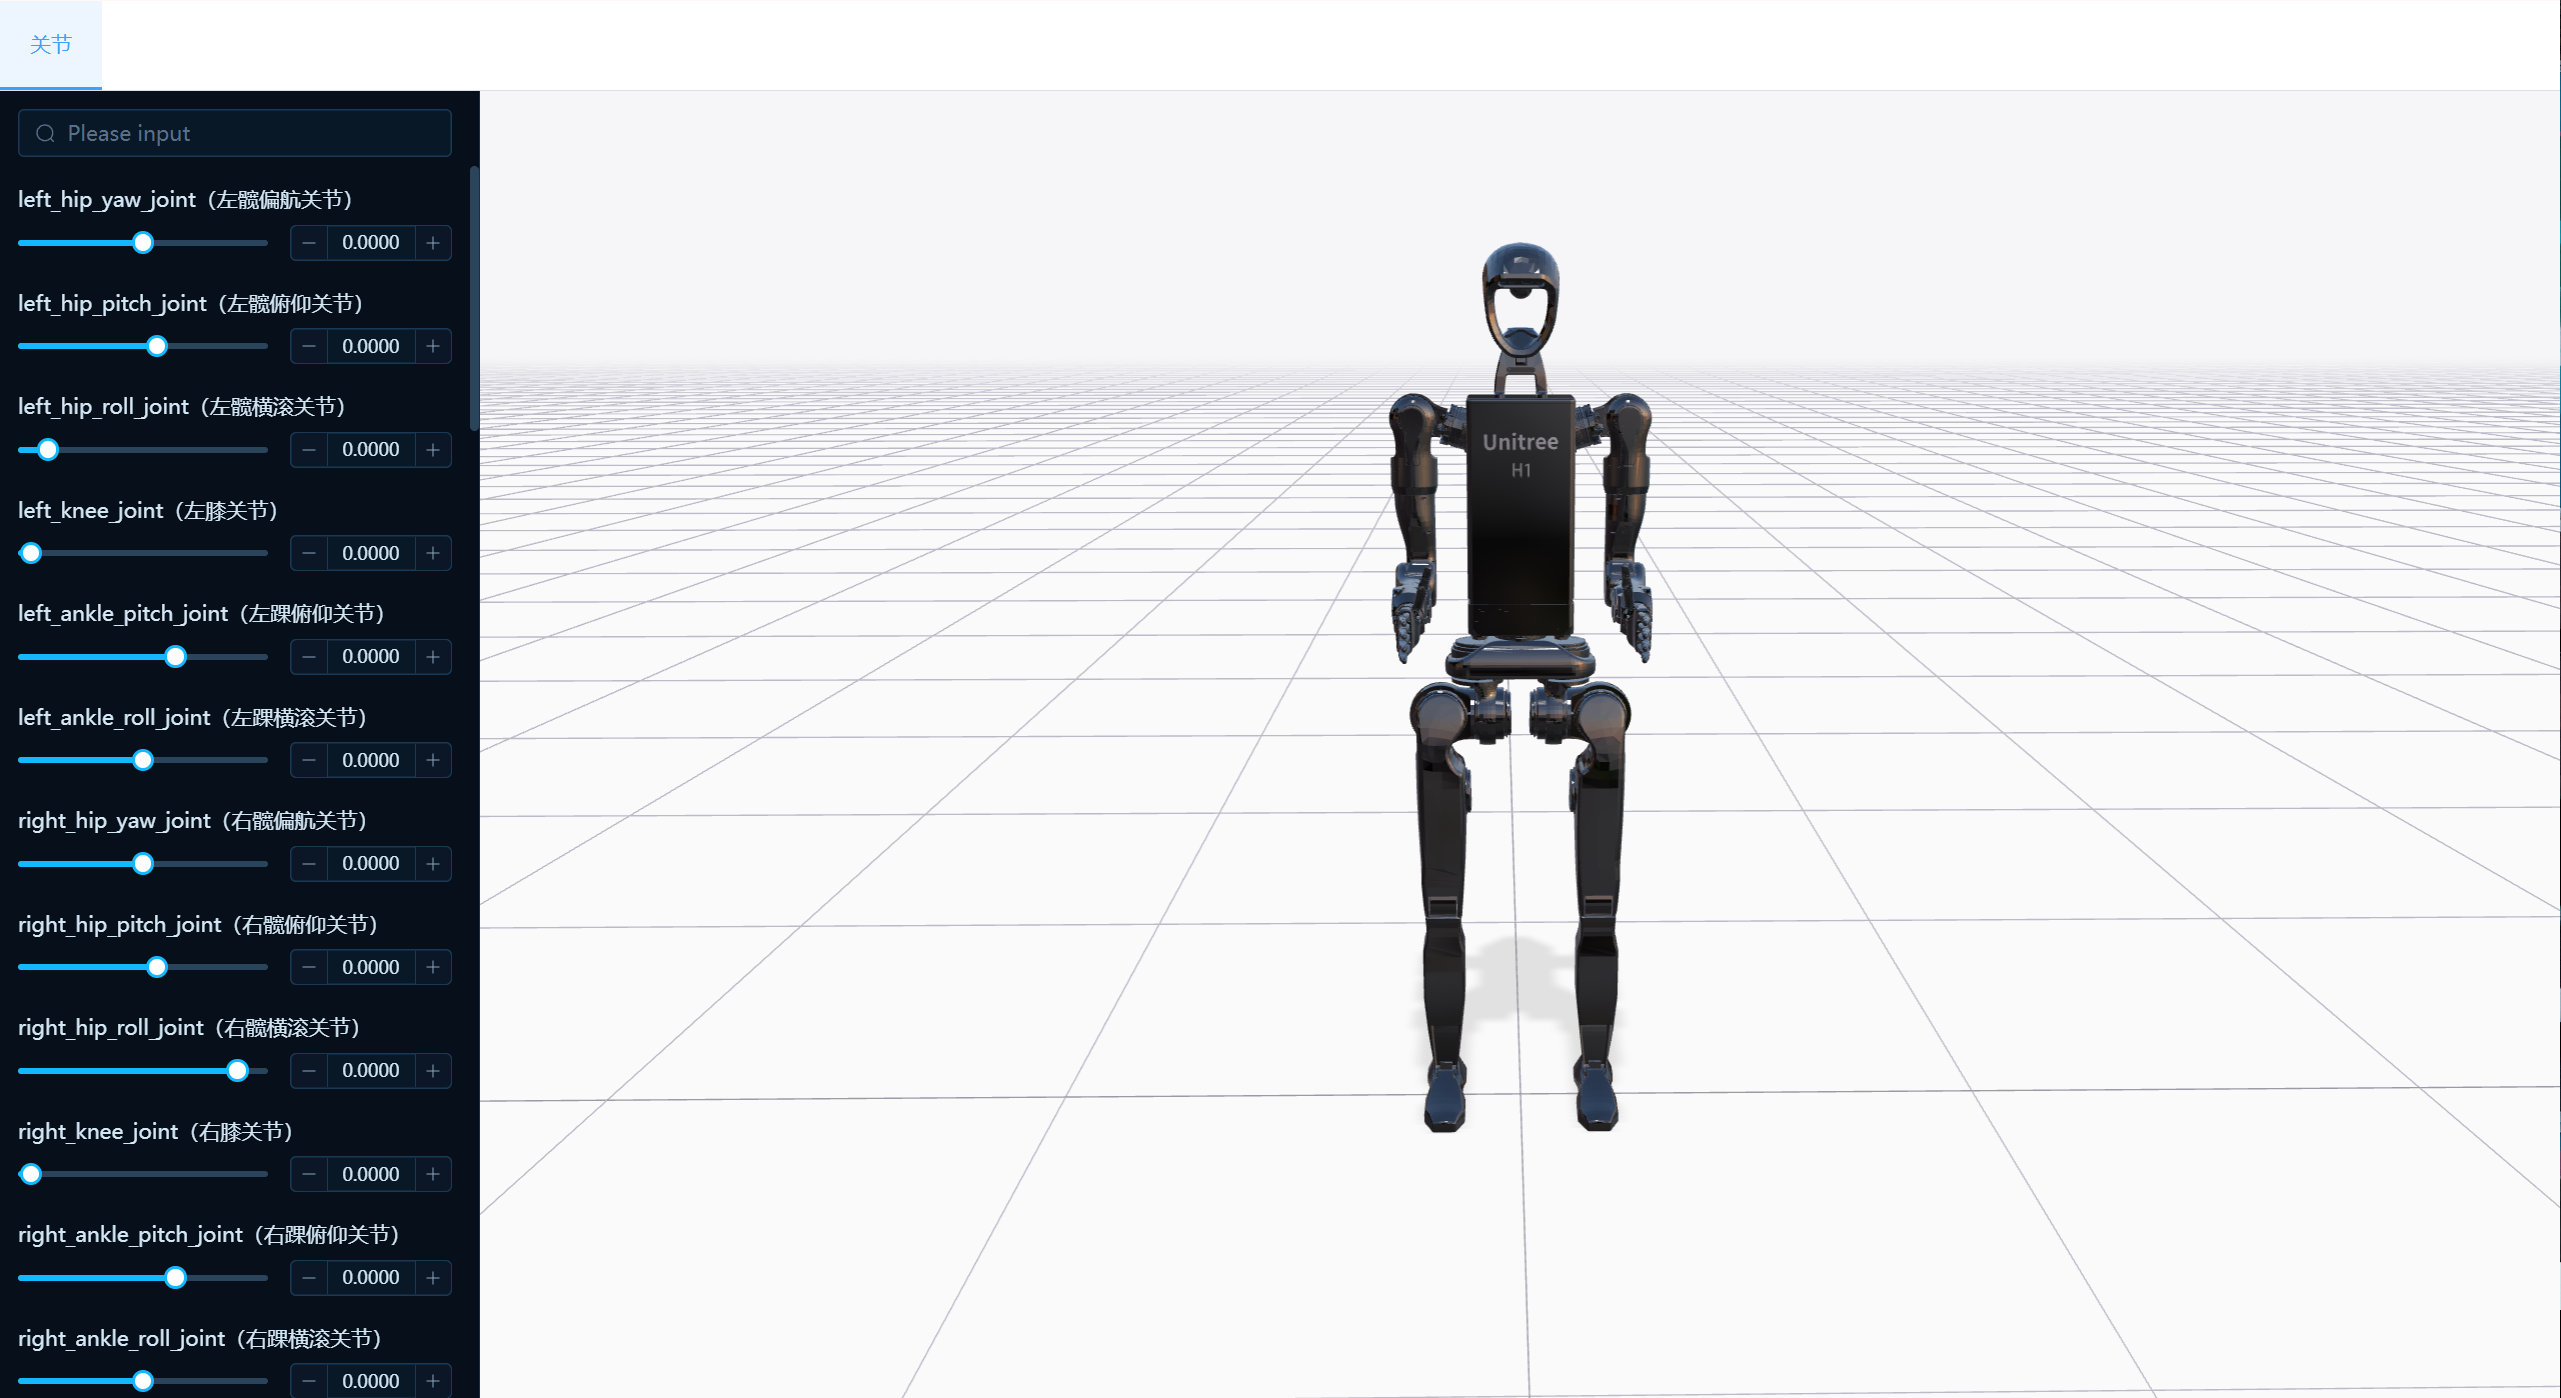
1. 什么是 URDF
URDF 全称 Unified Robot Description Format,是 ROS 里的机器人描述格式,本质就是一个 XML。
它只回答两个问题:
- 机器人身上有哪些刚体 —— 用
<link>描述 - 这些刚体怎么连、怎么动 —— 用
<joint>描述
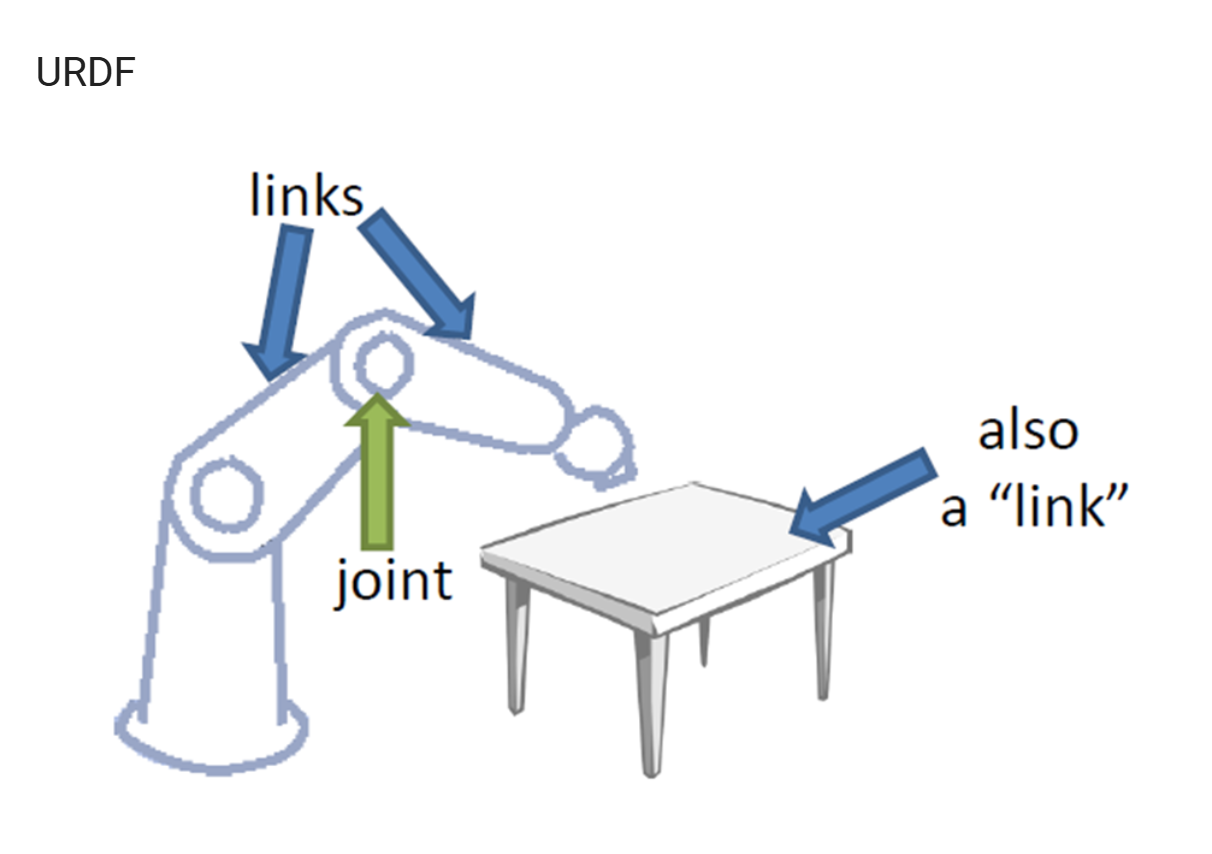
注意图里右边那张桌子,旁边也标了一句 “also a link”。这是很多人第一次看这张图会卡住的地方:link 不一定是机器人身上的零件。桌子、地面、相机支架,只要它参与坐标变换,就可以是一个 link。
一个真实的 URDF 文件骨架长这样(下面摘自人形机器人 h1_2.urdf):
1 | <robot name="h1_2"> |
<robot> 是根标签,里面就是交替出现的 <link> 和 <joint>。文件开头那个 <mujoco> 标签是给 MuJoCo 用的扩展,浏览器里的解析器不认识它 —— 后面会看到,解析器只用「认不认识 link / joint / material」来过滤,遇到不认识的标签直接跳过,所以它能安然待在那里。
2. link:一个刚体的三重描述
先从最小的单元看起:
1 | <link name="link_4"> |
link 标签中的 name 表示该连杆的名称,我们可以自定义。未来 joint 连接 link 的时候,会使用到这个名称。
<visual>:看上去是什么样
<visual> 描述机器人的外观:
<geometry>表示几何形状。这里用<mesh>调用了一个在三维软件中提前设计好的蓝色外观,也就是那个 stl 文件,看上去和真实机器人是一致的。<origin>表示坐标系相对初始位置的偏移,分别是 x、y、z 方向上的平移,和 roll、pitch、yaw 旋转。不需要偏移的话,就全为 0。
<collision>:碰撞时算成什么
第二个部分 <collision> 描述碰撞参数。里边的内容似乎和 <visual> 一样,也有 <geometry> 和 <origin>,看似相同,其实区别还是比较大的:
<visual>重在描述机器人看上去的状态,也就是视觉效果;<collision>则是描述机器人运动过程中的状态,比如机器人与外界如何接触算作碰撞。
在这个机器人模型中,蓝色部分是通过 <visual> 来描述的。在实际控制过程中,这样复杂的外观在计算碰撞检测时要求的算力较高;为了简化计算,我们把碰撞检测用的模型简化为了绿色框的圆柱体,也就是 <collision> 里边 <geometry> 描述的形状。
<origin> 坐标系偏移也是类似 —— 它可以描述刚体质心的偏移。视觉模型的几何原点未必在零件的旋转中心上,但碰撞体通常要摆在质心附近,两个 <origin> 就此分道扬镳。
还有一个 <inertial>
<link> 里其实还有第三块,上面那段示例没写,但真实文件里都有:
1 | <inertial> |
质量、质心位置、惯性张量。这是给物理仿真用的,渲染其实完全用不到。但可视化的时候把它画出来很有价值:你能一眼看出模型的质心在哪、惯量分布合不合理。
3. joint:把 link 连成一棵树
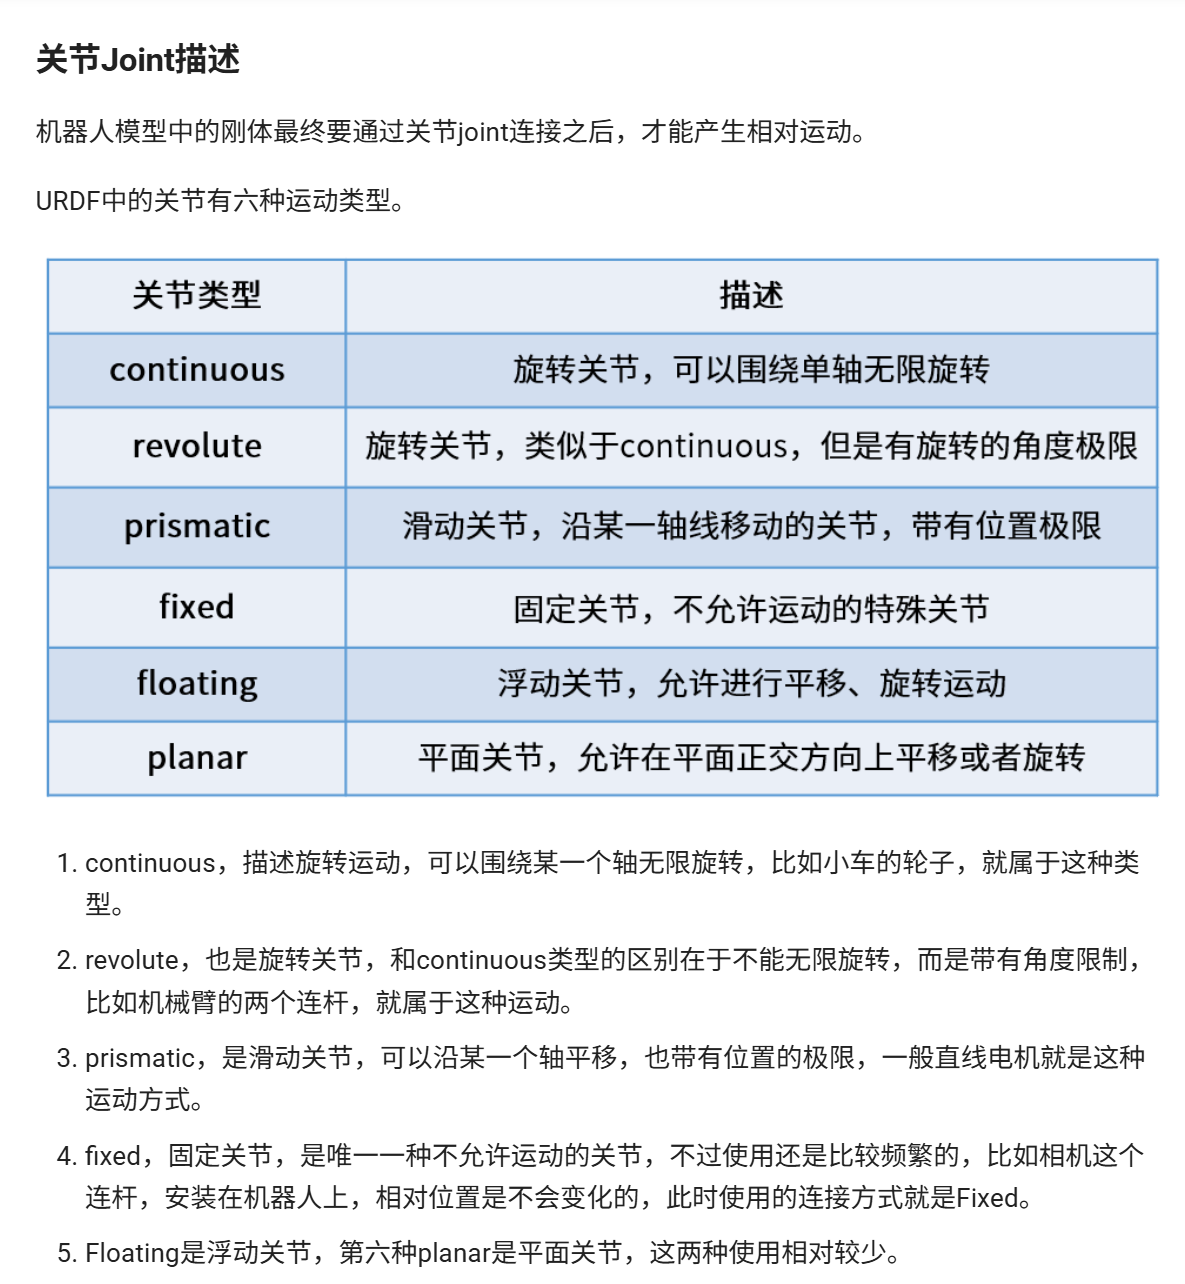
机器人模型中的刚体最终要通过关节 joint 连接之后,才能产生相对运动。
URDF 中的关节有六种运动类型:
| 关节类型 | 描述 |
|---|---|
continuous |
旋转关节,可以围绕单轴无限旋转 |
revolute |
旋转关节,类似于 continuous,但是有旋转的角度极限 |
prismatic |
滑动关节,沿某一轴线移动的关节,带有位置极限 |
fixed |
固定关节,不允许运动的特殊关节 |
floating |
浮动关节,允许进行平移、旋转运动 |
planar |
平面关节,允许在平面正交方向上平移或者旋转 |
对应到实际零件:
continuous描述旋转运动,可以围绕某一个轴无限旋转,比如小车的轮子,就属于这种类型。revolute也是旋转关节,和 continuous 类型的区别在于不能无限旋转,而是带有角度限制,比如机械臂的两个连杆,就属于这种运动。prismatic是滑动关节,可以沿某一个轴平移,也带有位置的极限,一般直线电机就是这种运动方式。fixed固定关节,是唯一一种不允许运动的关节。不过使用还是比较频繁的,比如相机这个连杆,安装在机器人上相对位置不会变化,此时使用的连接方式就是 fixed。floating是浮动关节,第六种planar是平面关节,这两种使用相对较少。
一个 joint 的完整写法:
1 | <joint name="left_hip_yaw_joint" type="revolute"> |
逐条看:
| 标签 | 含义 |
|---|---|
name |
关节名,后续代码里按名字设角度 |
type |
六种运动类型之一 |
<origin> |
关节相对父 link 的位姿 —— 关节长在父杆的哪个位置 |
<parent link> |
父连杆 |
<child link> |
子连杆 |
<axis> |
旋转/滑动的方向轴,在 joint 自己的坐标系里 |
<limit> |
lower/upper 是角度或位移范围,effort 是力矩上限,velocity 是速度上限 |
这里最关键的是 <parent> / <child> 的语义:joint 长在 parent link 上,child link 挂在 joint 下面。
也就是这样一条链:
1 | link (pelvis) |
形成一棵 link → joint → link → joint 交替的树。这个结构记牢,下一节会看到 Three.js 就是照着它建树的。
4. Three.js 解析 URDF
整个流程的入口是 load():取到 URDF 文本、交给 processUrdf 解析、再把结果回调出去。这里面有两行容易被看漏的 itemStart / itemEnd。
1 | load( |
这里没有用 FileLoader,而是直接 fetch + res.text() —— 因为 URDF 是 XML 文本,不需要任何额外的解析钩子。
值得注意的是手写的那对 manager.itemStart(urdfPath) / manager.itemEnd(urdfPath)。
LoadingManager 内部维护一个「还有几件事没做完」的计数器,平时是 FileLoader 自己调 itemStart / itemEnd。但这里用的是原生 fetch,LoadingManager 完全不知情。如果不手动补上这两句,会出现一个很隐蔽的问题:URDF 主文件还没下载完,manager.onLoad 就已经触发了(因为此刻计数器是 0),外部拿到一个还没建好的机器人。
补上之后,URDF 主文件和它引出的所有 STL/贴图,全都算在同一个计数器里,「全部加载完成」这个信号才准。这一点在 4.4 节讲 <mesh> 异步加载时会再回来看。
4.1 把 XML 变成 DOM
1 | processUrdf(data: string | Document | Element, urdfPath: string) { |
这里没有引入任何 XML 库,直接用浏览器原生的 DOMParser,MIME 类型指定 application/xml。
这是整个解析流程里最省事的一个决定。 一旦拿到 Document,后面所有的查找、遍历、取属性,都可以用现成的 DOM API —— querySelector、getAttribute、children。手写正则或者用 fast-xml-parser 反而要把这些重新发明一遍。
方法签名允许 string | Document | Element 三种输入,是为了让外部可以传入已经解析好的 DOM,避免重复解析。
filter(...).pop() 这一串是防御性写法:parseFromString 在某些浏览器上会在文档前插入节点,取最后一个匹配到的 robot 更稳;解析失败时返回的是一份带 parsererror 的文档,这里则返回 undefined,让调用方拿到 null 而不是崩溃。
4.2 对标签进行分类
1 | // 将<robot>中的一级子元素<link>、<joint>、<material> 归类 |
classifyNodeByName 在 utils.ts 里:
1 | function classifyNodeByName<key>(node: Element, names: key[]) { |
效果是把 <robot> 的直接子元素按标签名分到三个桶里。不在名单里的标签被静默忽略 —— 这就是开头那个 <mujoco> 能安然待着的原因,也是这个加载器能兼容各家厂商私有扩展的原因。
这里有两个细节:
node.children只返回元素节点,注释节点、文本节点天然被排除,所以不用额外判断节点类型。nodeName.toLowerCase()—— XML 规范里标签名是大小写敏感的,但实际文件里有写<LINK>的。统一转小写能容忍这种不规范。
分完之后,后面就是三趟独立的循环,互不干扰。
4.3 解析材质
三类里最先处理的是 <material>:
1 | const materialMap: Map<string, Material> = new Map() |
对应的是这样的 XML:
1 | <material name="steel"> |
processMaterial 是这一节的核心 —— 它把一个 <material> 元素翻译成一个 Three.js 材质对象:
1 | function processMaterial(materialNode: Element) { |
整个函数就一句话可以概括:先取一个默认材质,再拿 XML 里的字段往上覆盖。 但和 Three.js 结合的这四个点,每一个都有讲究。
一、基底是 createCommonMaterial(),不是 new Material()。
第一行先取一份默认材质,再往里填东西。这个默认材质是个三参数的 MeshStandardMaterial(color: 0xcccccc、metalness: 1、roughness: 0.1)。
这意味着即使 <material> 里只写了一个 <color>,最终出来的也是一个 PBR 材质,而不是 MeshBasicMaterial 那种纯色 —— URDF 只描述「什么颜色」,而 Three.js 拿到的是一套完整的 PBR 参数。
二、opacity 和 transparent 必须成对出现。
1 | material.opacity = rgba[3] |
在 Three.js 里单独设 opacity 是不生效的。 只有 transparent = true 时,材质才会进入透明渲染队列、开启混合。设了 opacity = 0.5 但 transparent = false,渲染出来还是完全不透明 —— 这是 Three.js 里最常见的「为什么我的透明没效果」之一。
那为什么不干脆无条件 transparent = true?因为透明物体要参与排序、通常还要处理深度写入,是有实打实开销的。用 rgba[3] < 1 判一下,只有真正需要透明的材质才付这个代价。
三、setRGB 传了三个参数,没做色彩空间转换。
Color.setRGB(r, g, b) 的第四个参数是 colorSpace,缺省时按 working color space(线性空间) 解释 —— 也就是不做任何转换。
而 URDF 里写的 rgba 值,惯例上是给人看的显示值(sRGB)。上面 h1_2.urdf 里的 rgba="0.1 0.1 0.1 1",按线性解释出来会明显比「看起来的 0.1」要亮。如果发现模型颜色比预期发灰发亮,这里是第一个该看的地方。
四、贴图那一支更微妙。
1 | const loader = new TextureLoader(manager) |
拆成三个点:
loader.load()是同步返回一个空的Texture对象的,图片之后才异步填进去。所以这一行不会阻塞,material.map立刻就有值,只是此刻image还是空的 —— Three.js 会在图片onload之后自动上传 GPU 并把needsUpdate置为true。模型先白几帧、贴图再「跳」出来,就是这个机制。TextureLoader传了manager,所以贴图也在加载计数器里,manager.onLoad会等它 —— 和 4.4 里 STL 的处理是同一个道理。colorSpace = SRGBColorSpace必须显式设。 Three.js 对贴图的默认假设是NoColorSpace,也就是「这是线性数据,直接用」。但 JPG/PNG 里存的像素值是 sRGB 编码的,少了这一句,未解码的数值会直接进光照计算,结果就是整体偏亮、对比度发灰。
注意三和四是两个相反的方向:setRGB 是把值当作线性用(不转换),texture.colorSpace 是声明「这来自 sRGB」(shader 里会解码)。同一个函数里两条路径的处理并不一致 —— URDF 的颜色语义本身没有严格规定,两边只能各自约定。
最后,material.name = materialNode.getAttribute('name') 把 URDF 里的名字带到了 Three.js 对象上。这不只是好看 —— 调试时能在 scene 树里一眼认出哪个材质是哪个,也方便后续按名字批量替换。
4.4 解析 link
1 | const linkMap: Map<string, URDFLink> = new Map() |
这段做三件事:建 URDFLink、判断它是不是根、调用 processLink 解析 <link> 内部。processLink 本体很短:
1 | function processLink(linkNode: Element, urdfLink: Group) { |
和 <joint> 的 switch 是同一个套路:按标签名分派。 但有个重要差别 —— processJoint 里的 switch 主要是收集数据(position、axis、limit 写进 userData),而这里三个分支都是往 urdfLink 上挂子节点。
也就是说,一个 <link> 解析完之后,在 Three.js 里长这样:
1 | urdfLink (URDFLink / Group) |
数量关系值得记一下,这是 URDF 规范规定的:
| 子标签 | 一个 link 里能有几个 | 挂上去的是什么 |
|---|---|---|
<visual> |
任意多个 | 每个一个 LinkVisual |
<collision> |
任意多个 | 所有碰撞体共用同一个 Group |
<inertial> |
最多一个 | 质心球 + 惯性盒子两个辅助对象 |
<collision> 那行是唯一一个「多个 XML 节点合成一个 Three.js 对象」的写法 —— 对比 <visual> 是来一个建一个。这个不对称是刻意的:运行时往往要整体开关碰撞体显示、整体换色,合成一个 Group 比一堆散落的 Mesh 好用得多。
还有一点:这三个分支挂上去的东西都挂在 urdfLink 这一层,共享同一个坐标系。它们各自的 <origin> 只是把自己再挪一下。所以「视觉模型在原位、碰撞体偏到质心」这类差异,靠的是各自的 <origin>,而不是挂到不同的父节点上。
其中最常打交道的 <visual> 是这样解析的:
1 | function processVisual(visualNode: Element, urdfLink: Group) { |
四行做四件事:取材质(按 <material> 的 name 查 materialMap,查不到就用默认材质)、建一个 LinkVisual 容器、把 <origin> 和 <geometry> 解析进去(4.7 的 processOriginAndGeometry)、挂到 link 上。
注意 LinkVisual 只承载 <origin> 的位姿,几何体是挂在它下面的 Mesh。所以一个带两个 <visual> 的 link,是「两个容器各带一个 Mesh」,而不是「一个容器里两个 Mesh 各带偏移」—— 这样每块几何体的 <origin> 互不干扰。
再往里一层:<geometry> 怎么解析
<visual> 和 <collision> 内部都交给同一个函数 processOriginAndGeometry(4.7 展开),它把子标签分成 origin 和 geometry 两路。<geometry> 这一路的入口是:
1 | function processGeometry( |
<geometry> 里只允许有一个子标签,所以直接取 children[0],再按标签名分派。又和 <link>、<joint> 是同一个套路 —— 这个加载器里到处都是「取 children,按 nodeName 分发」。
其中 box、sphere、cylinder 是同步的:
1 | // 解析<box size="0.224 0.08 0.071"/> |
三个函数长得出奇地一致,都是同一个套路:
1 | 读属性 → new 几何体 → new Mesh(几何体, 材质) → parent.add(mesh) |
这就是 URDF 几何体到 Three.js 的全部桥接。 没有额外的包装类 —— Mesh 是 Three.js 原生的,BoxGeometry / SphereGeometry / CylinderGeometry 也是,解析器只是把 XML 属性翻译成了构造函数的实参。
对照着看参数:
| URDF | Three.js | 是否直接对应 |
|---|---|---|
<box size="x y z"> |
BoxGeometry(x, y, z) |
是 |
<sphere radius> |
SphereGeometry(radius, 8, 6) |
半径是,段数硬编码 |
<cylinder radius length> |
CylinderGeometry(r, r, l, 6) |
是,但要额外转 90° |
<mesh filename scale> |
STLLoader / ColladaLoader 异步加载 |
见下 |
radius 在 CylinderGeometry 里出现两次,是因为它的签名是 CylinderGeometry(radiusTop, radiusBottom, height, ...) —— 支持上下半径不同的圆台。URDF 的圆柱上下一样粗,所以两个参数传同一个值。
几个容易忽略的点:
球:URDF 只给 radius,Three.js 还必须给宽高段数。这里写死 8, 6,是相当低的多边形数 —— 因为 <sphere> 在这类模型里几乎只出现在碰撞体上,本来就不需要圆。
圆柱:径向段数同样只有 6,也就是个六棱柱。同样出于「简化碰撞检测算力」的考虑 —— 和 2. 节里说的「把复杂外观简化成圆柱体」是同一个动机的延伸。
圆柱还多转了一下:
1 | cylinderMesh.rotation.set(Math.PI / 2, 0, 0) |
因为两者的轴向不一样:URDF 里圆柱默认沿 Z 轴,Three.js 的 CylinderGeometry 默认沿 Y 轴。绕 X 轴转 90° 正好把 Y 轴映射到 Z 轴:
1 | 绕 X 轴 +90°: (0, 1, 0) → (0, 0, 1) |
注意这一句是加在 Mesh 上的,而不是像 4.7 那样加在外层容器上。这不矛盾 —— 两者管的是不同的事:
1 | 容器 Group ← 负责「摆在哪」,由 <origin> 决定 |
<origin> 描述的是这个几何体相对 link 的位姿,属于外部关系,所以设在容器上;圆柱的朝向修正是几何体自身的属性,所以设在 Mesh 上。两者相乘的结果恰好就是 URDF 的语义:先在局部坐标系里沿 Z 轴长出圆柱,再按 <origin> 摆到位。
盒子和球都不需要这一步,两边的轴向本来就一致。
<mesh> 是唯一的异步分支
前三种形状当场 new 出来就完事,<mesh> 不行 —— 它指向一个外部文件,得先下载。加载器把这部分做成了一张按后缀查表的注册表:
1 | meshParsers: { |
用文件后缀查表,意味着要支持新格式不用改 processMesh,往这张表里加一项就行。使用它的地方:
1 | // 模型文件的格式 |
几个点:
一、STL 和 DAE 的产物类型不一样。 STLLoader 只吐 BufferGeometry,所以这里得自己 new Mesh;ColladaLoader 吐的是完整的 dae.scene,一个 Group,还可能带层级,所以那边是 traverse 进去逐个 Mesh 换材质。下游代码不能假设 obj instanceof Mesh —— 这也是 parent.add(obj) 的形参类型是 Object3D 而不是 Mesh 的原因。
二、scale 用 multiply 而不是 set。 DAE 文件自带缩放(Collada 常以厘米为单位),set 会把它覆盖掉,multiply 才是叠加。
三、parent.add(obj) 发生在 Promise 里。
这就是时序问题的根源:processUrdf 从头跑到尾、把 urdfRobot 返回出去的时候,所有 mesh 都还没回来。外部 onLoad 回调拿到的是一个「骨架已经搭好、但身上还光着」的机器人。
回到第 4 节的引子 —— 现在能说清那对 itemStart / itemEnd 的真正价值了。上面每个 new STLLoader(manager) 都传了同一个 manager,所以每个 STL 的加载都会自动进出计数器;而 URDF 主文件由 load() 手动 itemStart。两件事加在一起,manager.onLoad 才真正代表「URDF 和它引出的所有网格都齐了」。
项目里的用法印证了这一点:
1 | const manager = new LoadingManager() |
onLoad 回调里用「暂存 Map」接住骨架,manager.onLoad 里才把机器人交给正式的表 —— 两级回调,正好对应两个加载阶段。
四、路径解析交给了 resolveSubPath。
1 | /*子路径解析方法,可在外部重写*/ |
默认原样返回。这个钩子存在的原因是:URDF 里的 filename 经常是 package://my_robot/meshes/arm.stl 这种 ROS 包路径,浏览器根本不认识;也经常是相对 URDF 文件自身的路径 ./models/h1_2_description/meshes/pelvis.STL,而 URDF 和网页并不在同一个目录下。
同一个文件在 ROS 里能被 rviz 正确加载、在浏览器里却 404,绝大多数情况都出在这里。把它做成可重写的方法,而不是写死一段路径拼接逻辑,就是让每个项目自己决定映射规则。
函数签名把参数写成 urdfLink: Group 而不是 URDFLink,因为 processLink 只把它当容器用,不关心具体是哪个子类。同理,4.7 里 <visual> 和 <collision> 共用的那个 processOriginAndGeometry,它的 parent 参数也是 Group —— 既能接 LinkVisual,也能接碰撞体的容器。
URDFLink 只是个 Group,没有额外能力:
1 | export class URDFLink extends Group { |
整个加载器里最漂亮的一行是那个 querySelector。
树的根是「没人把它当孩子」的那个 link。与其建完整棵树再回溯找根,不如换个角度问:这个 link 有没有在某个 <joint><child link="..."> 里出现过? 一次 querySelector 全库扫描就能回答,不需要递归、不需要拓扑排序。
代价是复杂度 O(n²):每个 link 扫一遍全文档。但机器人撑死也就几十上百个 link,这个量级下完全无所谓。
值得一提的是,<joint><parent link="..."> 里也有 link 属性,但选择器写的是 child[link=...],只匹配标签名是 child 的元素,所以不会被父节点干扰。
顺序上也有讲究:这里只把根 link 挂到了 urdfRobot 上,其余 link 此刻都是「孤岛」,还没进树 —— 它们要等 4.6 把 joint 挂成树时才被认领。
4.5 解析 joint
<joint> 是 URDF 里信息量最大的标签。逐段看 processJoint。
第一步:判断它是不是从动关节。
1 | function processJoint(jointNode: Element) { |
带 <mimic> 的创建 URDFMimicJoint,其余创建 URDFJoint。两个属性缺省时分别按 1 和 0 处理 —— 这是两个有意义的默认值:不写 multiplier 表示 1:1 跟随,不写 offset 表示零点对齐。它们描述的关系就是 从动角度 = 主动角度 × multiplier + offset,人手的三段手指、机械夹爪的两个爪片都是这个结构。
第二步:给关节挂上坐标系辅助对象。
1 | /* 创建辅助对象-关节坐标系 */ |
每个 joint 一个,用来把关节自身的坐标系画成三根彩色轴,长度 0.2,默认隐藏。
注意它的创建时机 —— 在遍历子标签之前。因为 jointObj.add(jointAxisHelper) 是把它挂成 joint 的子节点,后面无论 joint 被挂到哪个 link 下、怎么变换,这个辅助对象都自动跟随。这也是 4.6 要建立的树结构第一次发挥作用。
第三步:遍历子标签,分五路归档。
1 | const { userData } = jointObj |
五个分支各自归档了什么:
| 子标签 | 写到哪儿 | 用途 |
|---|---|---|
<origin> |
position / quaternion + userData.origPosition / origQuaternion |
关节相对父杆的位姿,存两份 |
<parent> |
树结构 | 见 4.6 |
<child> |
树结构 | 见 4.6 |
<axis> |
userData.axis |
关节的运动方向轴 |
<limit> |
userData.limit.lower / .upper |
角度或位移范围 |
五个分支里,<origin> 和 <axis> 是重点 —— 它们是关节能「动」的全部依据,也是整个解析里和 Three.js 绑得最紧的两处。
一、<origin>:同一个位姿为什么要存两份。
1 | jointObj.position.set(xyz[0], xyz[1], xyz[2]) |
同一个位姿写了两遍:一遍写进 Three.js 真正拿去渲染的 position / quaternion,一遍存进 userData 的 origPosition / origQuaternion。
为什么要留底稿? 因为关节动起来之后,位姿会被反复改写。驱动关节时,每次都从初始姿态重算新姿态,而不是在上一帧的基础上继续叠加:
1 | 新姿态 = 初始姿态 ⊕ 新角度 |
没有 origPosition / origQuaternion 这两个锚点,关节就只能做增量更新 —— 那样既会累积浮点误差,也没法从任意角度跳回任意角度。后面的时间轴回放,靠的正是这一点。
还要注意这四行的顺序:先 position.set,再 applyEulerZYX,最后才 copy 出 origQuaternion。抄底稿必须在旋转算完之后 —— 抄早了,存下来的就是旋转前的单位四元数,底稿等于没存。
applyEulerZYX 里那个 'ZYX' 是本节最大的坑,4.7 单独讲透。
二、<axis>:存的是「关节坐标系里的方向」。
1 | const axis = processTuple(jointChild.getAttribute('xyz')) as NumberTuple3 |
这里只是把三个数存进 userData.axis,没做任何坐标变换。这不是偷懒,而是对的 —— URDF 规定 <axis> 表达在 joint 自己的坐标系里,而 joint 的坐标系正是 position / quaternion 所定义的那个。Three.js 后续用到这个轴时,会自己把它带进当前坐标系:
- 旋转关节:
setFromAxisAngle(axis, n)直接用。因为构造出来的四元数本来就作用在 joint 的局部坐标系上,不需要额外转换。 - 滑动关节:
_tempAxis.copy(axis).applyQuaternion(this.quaternion)—— 得先用当前姿态把轴转到父坐标系,才能拿去做position的平移。
如果把 <axis> 当成世界坐标或父 link 坐标来处理,方向就全错了。 这是 URDF 里仅次于 rpy 顺序的第二个方向陷阱 —— 而且比 rpy 更隐蔽,因为轴错了往往只表现为「关节在绕一个奇怪的方向转」,不容易一眼看出是解析阶段的问题。
还有一个细节:<axis> 在 URDF 里是可选的。省略时按 (1, 0, 0) 处理 —— 这个默认值写在 URDFJoint 的 userData 初值里(axis: new Vector3(1, 0, 0)),所以这个分支不执行时,axis 也依然有值。
三、<limit> 只取 lower 和 upper。 标签上还有 effort(力矩上限)和 velocity(速度上限),但那是给动力学和轨迹规划用的,渲染用不上,直接忽略。而且这里是「有才赋值」的写法 —— lower && (limit.lower = ...),属性缺失时保留 userData 里的默认值 { lower: 0, upper: 0 }。
四、userData.type 最后才写。 遍历子标签时用不到类型,而驱动关节时要用,所以在对象完全建好之后一次性写入。
4.6 joint 如何长成场景树
这是全篇最关键的一步。
URDF 给的是关系(谁是谁的父、谁是谁的子);Three.js 要的是变换树(谁挂在谁下面)。4.5 里那个 switch 的 parent 和 child 两个分支,和其他三个不太一样 —— 它们不写数据,而是改结构。转换就靠这两行:
1 | case 'parent': |
翻译一下:
<parent link="pelvis"/>→pelvis.add(joint)—— joint 挂到父 link 下面<child link="left_hip_yaw_link"/>→joint.add(childLink)—— 子 link 挂到 joint 下面
对照 3. 节画的那条链,完全一致:
1 | URDF Three.js 场景图 |
为什么非要用这个结构? 因为 Three.js 的 matrixWorld 是沿父子链自动累积的。pelvis 一动,它下面所有子孙的世界矩阵全部跟着变;left_hip_yaw_joint 转 10 度,它下面整条腿跟着转。
换句话说,URDF 里「关节带动连杆」这个物理语义,被直接编码进了 Three.js 的树结构里。不需要任何额外代码去传播变换 —— 渲染管线自己就做了。
循环的写法上还有一点:这段 forEach 是在处理单个 joint 的子标签时用的 switch,也就是 <origin> / <parent> / <child> / <axis> / <limit> 各自走各自的分支,顺序无关。由于所有 link 都已在 4.4 里建好并写进了 linkMap,joint 之间谁先谁后也不影响结果。
4.7 <origin> 和 rpy:那个必须写 'ZYX' 的地方
关节的位姿从这里来:
1 | case 'origin': |
xyz 很直白,三个 float 塞进 position。rpy 就藏了个坑,看 applyEulerZYX:
1 | function applyEulerZYX(obj: Object3D, rpy: [number, number, number]) { |
四行,每一行都在和 Three.js 的数学类型打交道。 逐行拆开:
| 行 | 做什么 | 涉及的类型 |
|---|---|---|
tempEuler.set(r, p, y, 'ZYX') |
用 URDF 的 rpy 填一个欧拉角,并指定旋转顺序 | Euler |
tempQuaternion.setFromEuler(tempEuler) |
把欧拉角转成四元数 | Euler → Quaternion |
tempQuaternion.multiply(obj.quaternion) |
叠加上 obj 原有的旋转 |
Quaternion × Quaternion |
obj.quaternion.copy(tempQuaternion) |
写回对象 | Quaternion |
为什么中间要绕一下四元数,不直接把 rpy 赋给 obj.rotation?
因为 obj.rotation 是个 Euler,它自己也有一个 order 属性,默认就是 'XYZ'。如果图省事写成:
1 | obj.rotation.set(rpy[0], rpy[1], rpy[2]) // ❌ order 还是默认的 'XYZ' |
顺序照样是错的 —— 坑并没有绕着走,只是换了个地方。
所以要么额外记得设 obj.rotation.order = 'ZYX',要么就像这里一样:用临时 Euler 指定顺序、转成四元数再写回。后者的好处是只写四元数、不碰 rotation 的 order。
这背后是 Three.js 里的一个设定:Object3D 的 rotation 和 quaternion 是同一个旋转的两个视图,内部靠回调互相同步 —— 写 quaternion 会自动按 rotation 当前的 order 重新解算出对应的欧拉角。所以无论走哪条路,最终存下来的旋转是同一个;差别只在于「用哪个 order 去解释那三个数」。
tempEuler 和 tempQuaternion 是模块级的临时对象。
1 | const tempQuaternion = new Quaternion() |
定义在 utils.ts 顶部,而不是在函数里 new。这是 Three.js 代码里极常见的写法:几何变换在一帧里会被调用成百上千次,每次 new 两个对象就是上千次堆分配、上千次 GC 压力。复用两个模块级实例,代价是函数不可重入 —— 但在单线程的渲染循环里这不是问题。
关键在第四个参数 'ZYX'。
utils.ts 里紧挨着这段代码画了两张坐标系图:
1 | THREE.js ROS URDF |
URDF 的 rpy 是 roll、pitch、yaw,对应绕 X、Y、Z 三个固定轴依次旋转。按旋转矩阵写成:
1 | R_urdf = Rz(yaw) · Ry(pitch) · Rx(roll) |
注意左边的读法:矩阵连乘从右往左作用,所以 Rx(roll) 先作用,然后 Ry(pitch),最后 Rz(yaw) —— 这才是「依次绕 X、Y、Z 转」的意思。
而 Three.js 的 Euler 默认顺序是 'XYZ',对应:
1 | R_three_default = Rx(x) · Ry(y) · Rz(z) |
两者是反的。
Three.js 的 'ZYX' 顺序给出的才是 Rz · Ry · Rx,和 URDF 完全对上。所以这一句 'ZYX' 不是可选项 —— 不写就是用默认的 'XYZ',姿态直接算错。
那为什么很多模型看起来「没出问题」?因为只有一个轴有值的时候,两种顺序结果相同:
1 | Rx(r) · Ry(0) · Rz(0) = Rx(r) · I · I = Rx(r) |
rpy="0 0 0" 或者 rpy="0 1.5707963 0" 这类单轴值,怎么排都对。只有 roll、pitch、yaw 里两个以上非零,问题才会暴露 —— 而且是那种「模型没报错、就是姿态歪了」的暴露。前面 h1_2.urdf 里的碰撞体 <origin xyz="0.02 0 0" rpy="0 1.5707963 0"/> 恰好只有 pitch,属于安全的那一类。
第三行用 multiply 而不是 copy,而且顺序不能反。
1 | tempQuaternion.multiply(obj.quaternion) |
四元数乘法不满足交换律。a.multiply(b) 的结果是 a · b,tempQuaternion 装的是 origin 的旋转,obj.quaternion 是对象身上已有的旋转,所以这一行算出来是:
1 | q_结果 = q_origin · q_已有 |
新来的 origin 旋转在左边,意味着它作用在更外层的坐标系上 —— 先让对象带着自己原有的姿态,再整体套上 origin 的旋转。这正是 <origin> 的语义。
改写成 obj.quaternion.multiply(tempQuaternion)(顺序反了),旋转轴会跟着被转走;改成 copy 则直接把对象原本的姿态丢了。三种写法编译都不报错,只是结果不对 —— 这是四元数代码最难受的地方,出问题时只能靠摆一个已知姿态的模型去对。
<origin> 不只出现在 joint 上,<visual> 和 <collision> 里也有,走的是同一个函数:
1 | function processOriginAndGeometry(node, material, parent) { |
这里有个值得注意的写法:<origin> 的位姿设在了 parent 这个 Group 上,而不是设在那块 Mesh 上。拿 <visual> 举例,结构变成了:
1 | urdfLink (URDFLink) |
变换放在容器上,几何体本身保持不动。 这样一块几何体可以被多处复用而不用改它自己的属性,也避免了「多块 mesh 共用一个 <origin>」时反复设置。
5. URDF坐标系转成threejs坐标系
URDF 用的是 ROS 的坐标系:z 轴朝上(x 向前、y 向左、z 向上)。Three.js 默认 y 轴朝上。两者差一次旋转,转换在场景层完成:
1 | // 矫正z轴朝上的坐标系 |
把所有机器人和路径挂进一个 tfGroup,给 tfGroup 绕 x 轴转 -90°,再把 tfGroup 加进场景。整棵子树的局部 z 轴于是对齐世界的 y 轴。
URDFLoader 不做这件事 —— processUrdf 里没有任何一处改坐标轴,URDF 里 xyz 写多少就解析成多少。
参考
- URDF XML 规范(ROS 官方文档):https://wiki.ros.org/urdf/XML
- REP-103:ROS 的坐标系与单位约定(x 前、y 左、z 上):https://www.ros.org/reps/rep-0103.html
- Three.js
Euler的旋转顺序说明:https://threejs.org/docs/#api/en/math/Euler - Three.js
Object3D场景图与matrixWorld传播:https://threejs.org/docs/#api/en/core/Object3D - 本文源码:
08-animationBuffer/src/robot/URDFLoader.ts、URDFClasses.ts、utils.ts - 下一篇:Three.js 如何旋转和推拉关节 —— https://wywzixin.github.io/threejs/urdf-joint-motion/
Three.js 如何解析 URDF 机器人模型