Vue 解决 LLM 对话过长问题:使用 markstream
先看一张截图。
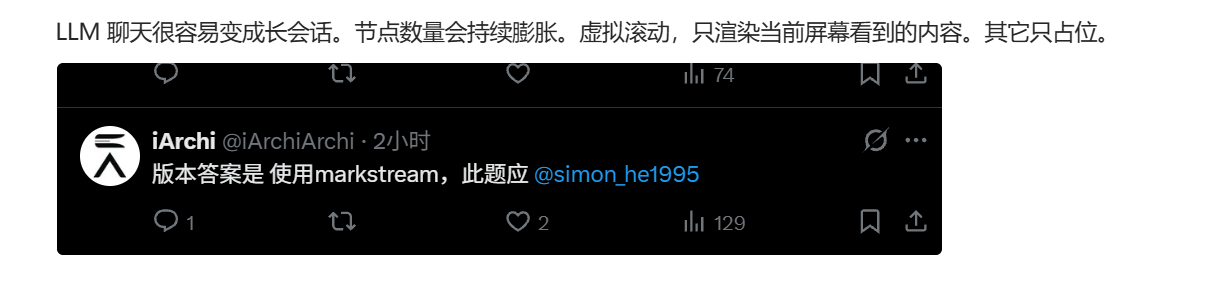
之前见过这个vue如何解决LLM对话过长问题,那条回复说的是答案:
LLM 聊天很容易变成长会话。节点数量会持续膨胀。虚拟滚动,只渲染当前屏幕看到的内容。其它只占位。
—— 版本答案是 使用 markstream,此题应 @simon_he1995
「虚拟滚动」这四个字在列表场景里是老生常谈,但把它搬到 LLM 聊天里,有一个前提条件会被打破。这篇就把这两句话中间的推理补上,再说怎么落地。
用到的组件是 markstream-vue,文档在 markstream.simonhe.me。示例项目是一个能跑起来的最小聊天 Demo:Vue 3 + Vite,消息列表交给 MarkstreamVirtualTimeline,正文交给 MarkdownRender。
1. 虚拟滚动,以及它为什么在聊天里不好用
虚拟滚动的原理很朴素:
1 | 可视区 |
屏幕外的消息不挂 DOM,只留一个撑到估算高度的空盒子,这样滚动条长度和滚动位置仍然是对的。DOM 节点数从「总消息数」降到「一屏能装下的条数」,跟对话有多长无关。
但它有个前提:得先知道每一项有多高,才能算出总高度、才知道当前该渲染哪几项。
| 场景 | 高度可预期吗 | 能不能直接套 |
|---|---|---|
| 等高的表格行 | 固定值 | 能,最简单 |
| 不等高的卡片列表 | 渲染一次量出来,之后不变 | 能,先量后用 |
| LLM 聊天 | 最后一条每帧都在长高 | 不能直接套 |
第三行就是聊天场景和普通列表的分水岭。你刚量出来的高度,下一个 token 就作废了。更麻烦的是流式那条消息的高度变化还会反过来影响滚动位置——一个 token 让消息高了几像素,如果不管,画面就会在底部不停地跳。
还有两个附带难题:
- 滚上去看历史的时候,底下还在流。 这时候不能无脑贴底,得判断「用户是不是还停在底部」,停了才跟,用户手动滚上去了就不能拽他回来。
- 长会话里 Mermaid、KaTeX、图片是异步渲染的,它们渲染完高度还会再变一次,虚拟滚动得能接住这种「迟到的高度变化」。
所以「虚拟滚动」这句话在 LLM 场景下不是随口一说。难点从来不在虚拟滚动本身,在高度不可预知。
2. markstream 把虚拟滚动和流式 Markdown 合在了一起
markstream-vue 提供两个东西,各管一半:
1 | MarkstreamVirtualTimeline MarkdownRender |
两者之间靠两个东西对接,都由 Timeline 通过作用域插槽发下来:
measureRef—— 绑到那条消息的根元素上,Timeline 才知道这条实际多高,才能用真实值替换估算值。高度变了它会自己重算总高度并补偿滚动位置。markdownProps—— 一串配好的渲染参数,直接v-bind给MarkdownRender,让内层和外层对同一条消息的认知保持一致。
数据怎么流:
1 | content += delta(token 到达) |
这解释了为什么虚拟滚动和流式渲染必须由同一个组件协调——分成两个库拼装,高度这条信息就断了。
3. 拆一个最小示例
先把跑起来的样子放在这里:
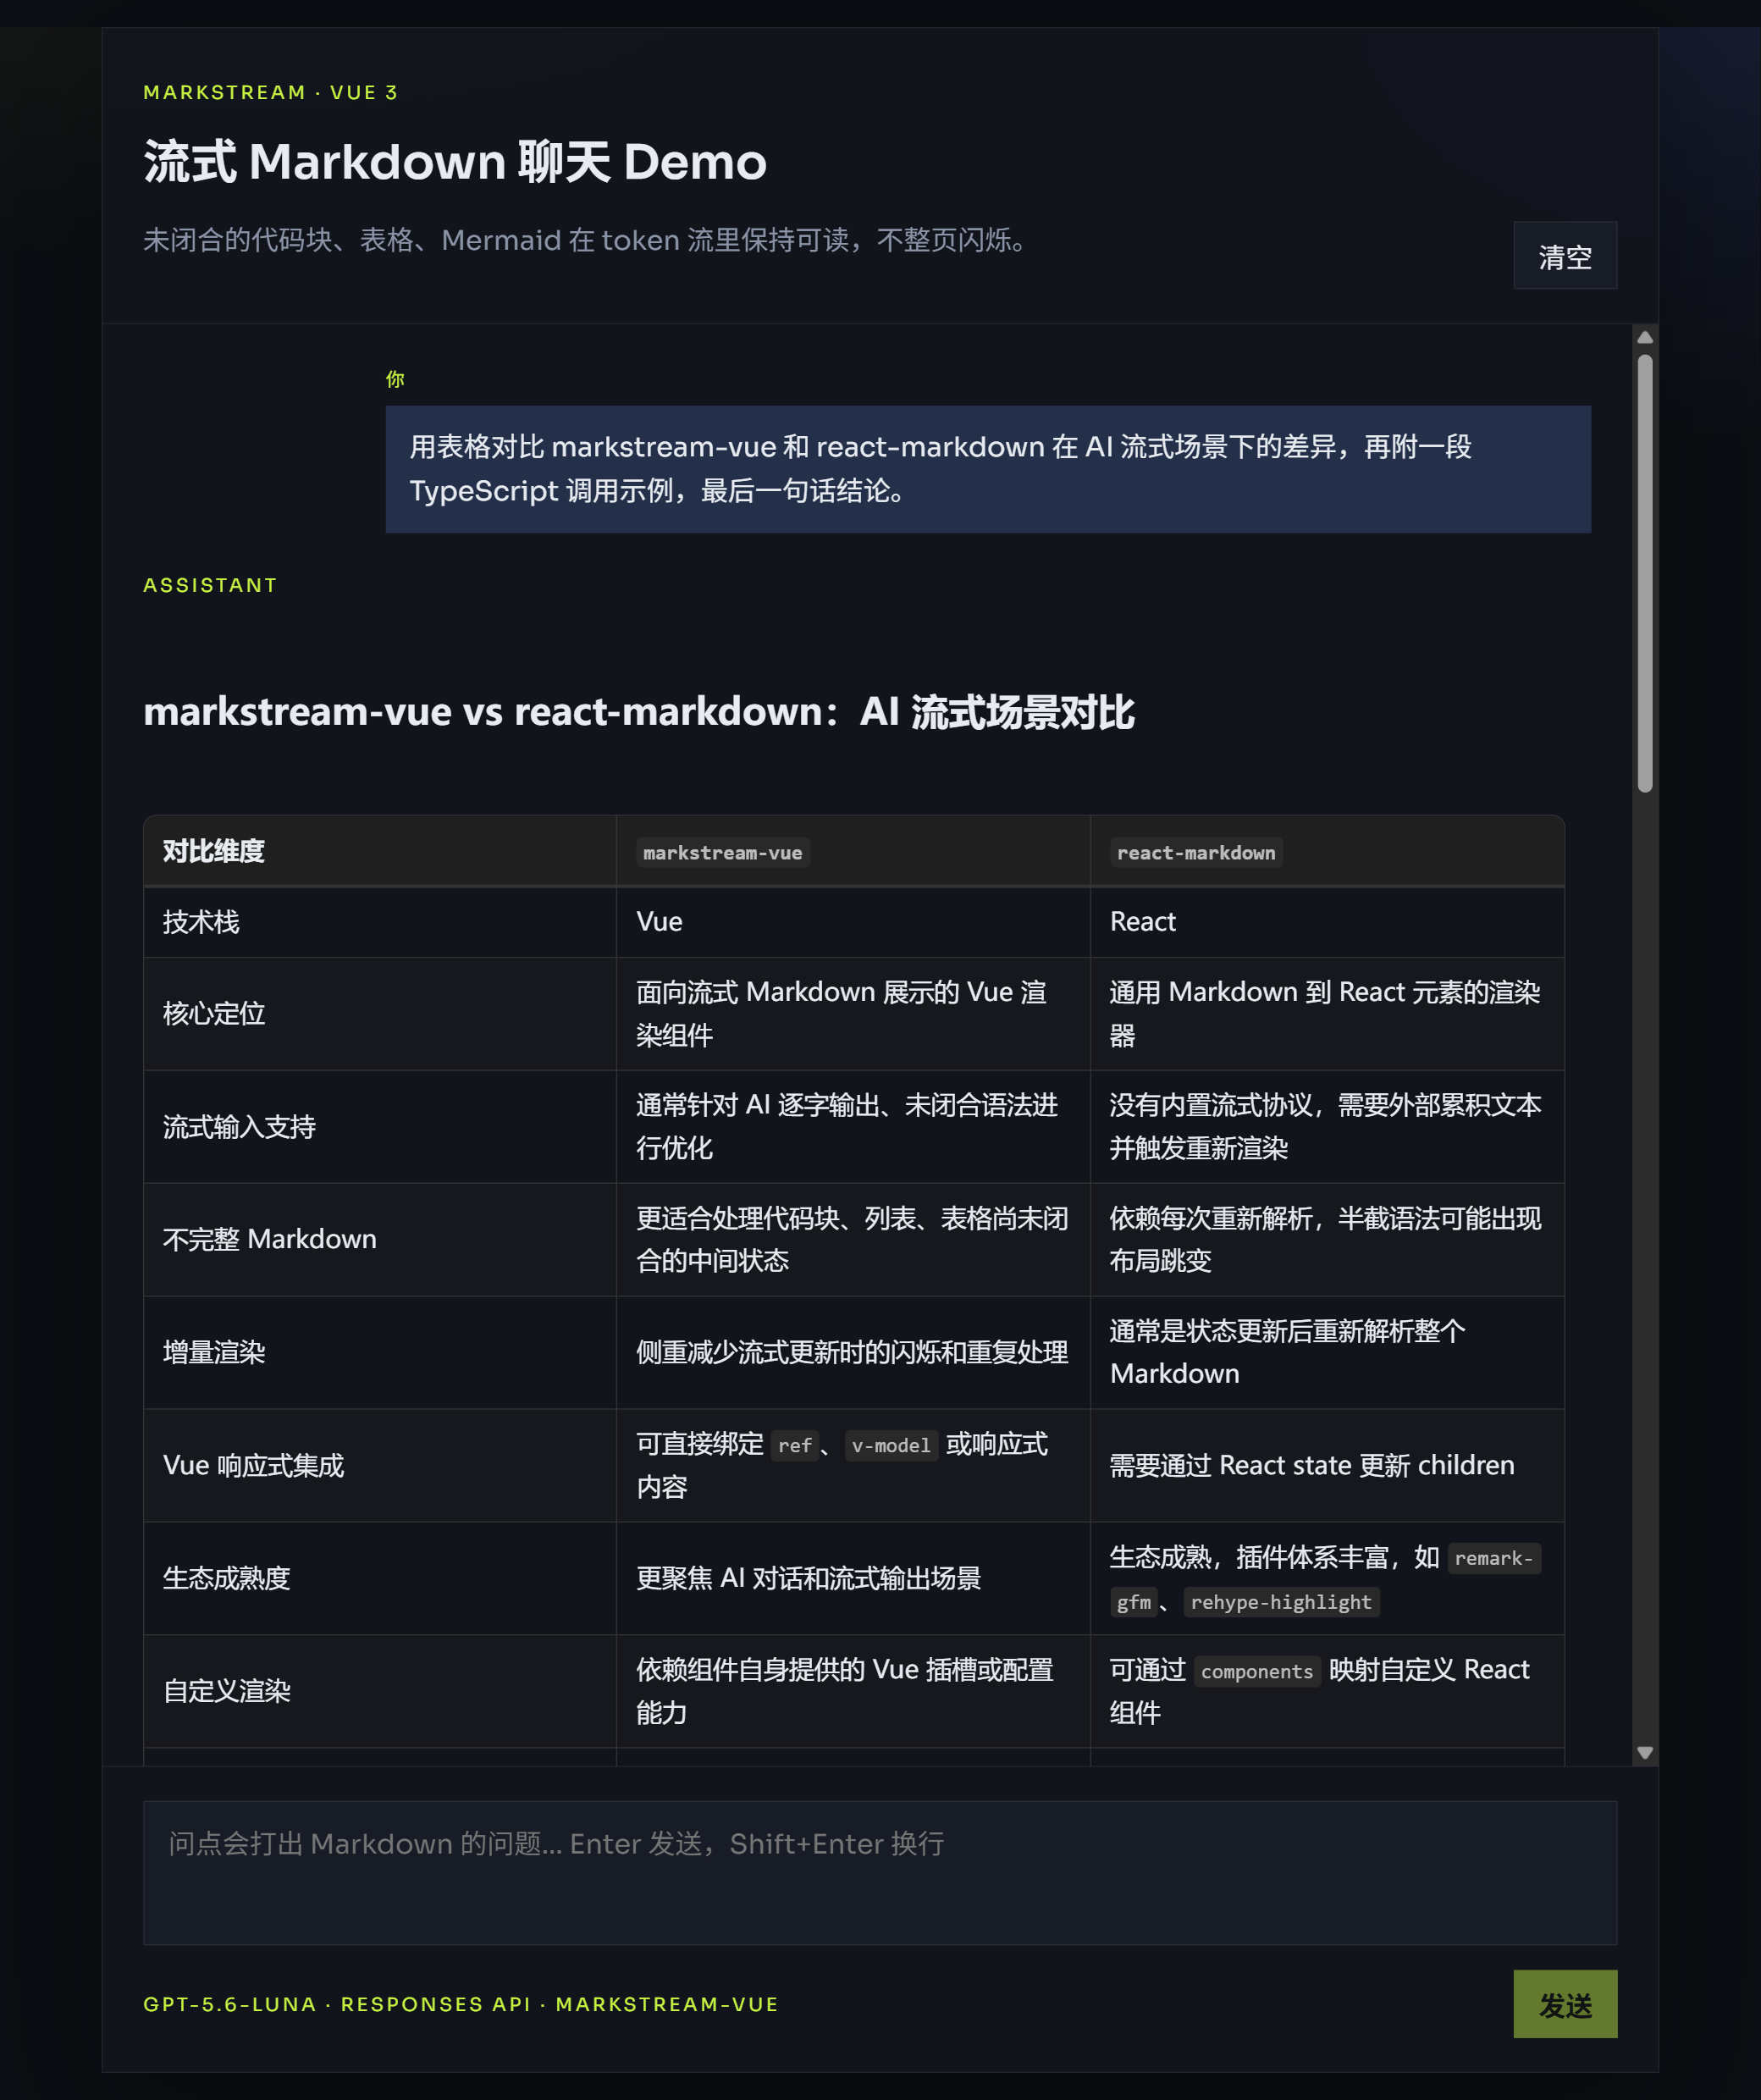
下面按这个 Demo 走一遍(Vue 3 + Vite 搭的最小聊天页)。结构很小:一个 App.vue 加一个 SSE 解析的 lib/openai.ts。
3.1 消息的形状
1 | interface ChatMessage { |
四个字段是给组件读的:
id—— 这一条的唯一标识,滚动锚点和高度缓存都挂在它上面,流式过程中不要改它。content—— Markdown 原文,流式时就是不断变长的那个字符串。final—— 这一条流完了没有。流式进行中是false,流结束翻成true;渲染器靠它在「跟得上」和「稳」之间换一套节奏。kind—— 宿主自己用来分叉的,用户气泡和 assistant 正文走不同的模板。
text 和 reasoning 是业务字段:前者存用户原始输入(避免被 Markdown 解析),后者存模型的思考过程。
如果你的数据结构跟这套字段名对不上,Timeline 也接受 getKey / getKind / getContent / getFinal 这几个函数,自己从 item 里取。
3.2 列表:交给 Timeline
1 | <MarkstreamVirtualTimeline |
几个点:
:ref="measureRef"必须绑在这条消息的根元素上。 绑错层级或者忘了绑,Timeline 就量不到真实高度,只能一直用估算值——症状是滚动条长度飘、滚到底部对不准、快速滚动时内容闪。stick-to-bottom="auto"是聊天该用的值。它在「贴底」和「不打断用户」之间做自动判断,含义是:用户本来就在底部就跟着新内容走,用户主动往上滚了就不要拽他回来。写死true会在用户翻历史时把他反复拉回底部。thread-key标识一个会话。切换会话时告诉 Timeline「换一批数据了」,它会切到对应的滚动状态,而不是把上一个会话的锚点套过来。markdown-mode="chat"和:markdown-fade="false"是给内层MarkdownRender的默认值。聊天要的是稳定节奏:流式过程中每来一个 token 都有节点进出,透明度渐显会变成反复重启的动画,也就是肉眼看到的「闪烁」。
3.3 正文:markdownProps 已经配好了
markdownProps 里装的是这一条消息该用的渲染参数(content、final、mode、maxLiveNodes、虚拟化状态等)。所以正文那一行最省事的写法是直接 v-bind:
1 | <MarkdownRender v-bind="markdownProps" custom-id="chat" :is-dark="true" /> |
custom-id 是给 setCustomComponents 用的作用域标识——如果之后要在 Markdown 里嵌自己的 Vue 组件,注册时用同一个 id 才能对上。这里先占个位。
mode 三种取值,含义是三种预设:
| mode | 面向 | 特点 |
|---|---|---|
chat |
AI 聊天、SSE 输出 | 轻量默认值,稳定节奏,不叠加透明度动画 |
docs |
文档站、长文档 | 更大的渲染批次,带 tooltip 和 fade |
minimal |
既不是聊天也不是文档 | 和 chat 一样的轻量默认值 |
别在同一条消息上因为 final 变成 true 就把 mode="chat" 切成 mode="docs"。 docs 会改变布局策略,中途切会让整条消息重排一次,正好在流刚结束的那一瞬间闪一下。mode 全程保持稳定,要调的是节奏和动画那几个 props。
3.4 流式那一侧:content += delta 就够了
1 | messages.value.push({ |
这里只有一件事要小心:必须改数组里那条对象的属性,不能让 content 本身是普通字符串然后整个替换。 因为 messages 是 ref 包着的数组,往 assistant.content 上追加,Vue 的响应式代理能追到;而 const assistant = ... 拿到的正是这个代理对象。如果写成重新构造一个对象再赋值回数组,等于每条 token 都换一次 item 身份,Timeline 会认成「来了一条新消息」,滚动位置和高度缓存全乱。
Demo 里还有两个细节:
- 请求发出去之前,先把 assistant 那条推进列表(内容是空字符串),再过滤掉它自己组 history。这样界面上立刻出现一个空的 assistant 气泡,用户知道「已经在生成了」。
AbortController存到abortRef上,stop()就一句abortRef.value?.abort()。中止后如果一条内容都没有,补一句_已停止生成。_,免得留一个空气泡。
4. 装起来
1 | pnpm add markstream-vue |
1 | import MarkdownRender from 'markstream-vue' |
最小用法:
1 | <template> |
三个容易踩的点:
CSS 导入顺序。 必须放在 CSS reset 之后(@tailwind base、@unocss/reset 之后),否则会被 reset 覆盖掉。用 Tailwind / UnoCSS 的话推荐带 layer:
1 | import 'markstream-vue/index.css' // 或 @import 'markstream-vue/index.css' layer(components); |
可选 peer 依赖按需装。 这三个都不在默认包里,装完还要显式启用:
1 | import { enableKatex, enableMermaid } from 'markstream-vue' |
stream-diffs—— 增强代码块(File / Diff 界面)。不装的话代码块按设计降级成普通<pre>,不影响功能。mermaid—— Mermaid 图表katex—— 数学公式
移动端根字号。 如果你的移动端会主动调大 html / body 的字号,改用 markstream-vue/index.px.css,避免组件的 rem 跟着根字号一起放大。
5. 什么场景用哪个模式
| 你的场景 | 渲染入口 | 关键参数 |
|---|---|---|
| AI 聊天 / SSE 输出 | MarkdownRender 或 MarkstreamVirtualTimeline |
mode="chat"、用 final 切换流式 / 定稿两套节奏 |
| 消息条数很多的长会话 | MarkstreamVirtualTimeline |
stick-to-bottom="auto"、thread-key |
| 单条就极长的文档 | MarkdownRender |
默认 max-live-nodes=320 虚拟化 |
| 文档站 / VitePress | MarkdownRender |
mode="docs" |
| 服务端已解析好 AST | MarkdownRender :nodes |
前端不再解析,水合一致 |
真正要记住的只有两件事:DOM 节点数要跟对话长度脱钩(虚拟滚动),流式渲染要能处理未闭合的中间态(流式 Markdown 渲染器)。前者是截图里那半句已经被说出的话,后者是它没说的那一半——而两件事必须由同一个组件协调,因为它们是靠「高度」这条信息耦合在一起的。
参考
- GitHub:https://github.com/Simon-He95/markstream-vue
- 文档 / 快速开始:https://markstream.simonhe.me/zh/guide/quick-start
- Vue 3 Playground:https://markstream-vue.simonhe.me/
- 渲染问题复现页(可生成分享链接):https://markstream-vue.simonhe.me/test
Vue 解决 LLM 对话过长问题:使用 markstream