MCP 协议与工具接入
MCP(Model Context Protocol,模型上下文协议)是一套开放协议,用于规范 LLM 应用与外部工具之间的连接方式:应用侧实现 MCP 客户端(Client),工具侧实现 MCP 服务端(Server)。
它的直接收益是:”N 个应用配 M 个工具”所需的 N×M 段适配代码,收敛为 N+M 段。
具体来说:你想让 Agent 能查 GitHub、查数据库、发 Slack,得写三段适配代码(各一套认证、参数格式、错误处理);再写一个跑在 IDE 里的 Agent,又是三段,内容几乎一样;哪天工具那边换个实现,每个 Agent 里都得跟着改一遍——它们明明在做同一件事。
MCP 把这两个方向都解开了:换 Agent,工具侧不用动;换工具实现,应用侧不用动。两边甚至可以是不同的人、用不同的语言写的。
这篇讲这层协议长什么样:分了哪两层、有哪两种传输、一次连接要走哪三步,以及工具接进来之后怎么进到 Agent 的工具表里。
1. 三个角色:Host、Client、Server
MCP 里只有三个角色,但它们不是一个进程里的三个东西:
| 角色 | 是什么 |
|---|---|
| Host | 跑着 Agent 的那个程序。管连接,也决定把哪些工具交给模型 |
| Client | Host 内部的一个对象,负责跟一个 Server 通信 |
| Server | 真正提供能力的一方。一个 Server 就是一组工具/资源的提供者 |
最容易搞混的是 Client:它不是”客户端程序”,而是 Host 里的一个连接对象,而且跟 Server 是一对一的。
所以”Host 里有一个 Client”这个说法是错的。正确的是:Host 里有一张 Client 的表——接了 5 个 Server,就有 5 个 Client 对象,各自管一条连接。
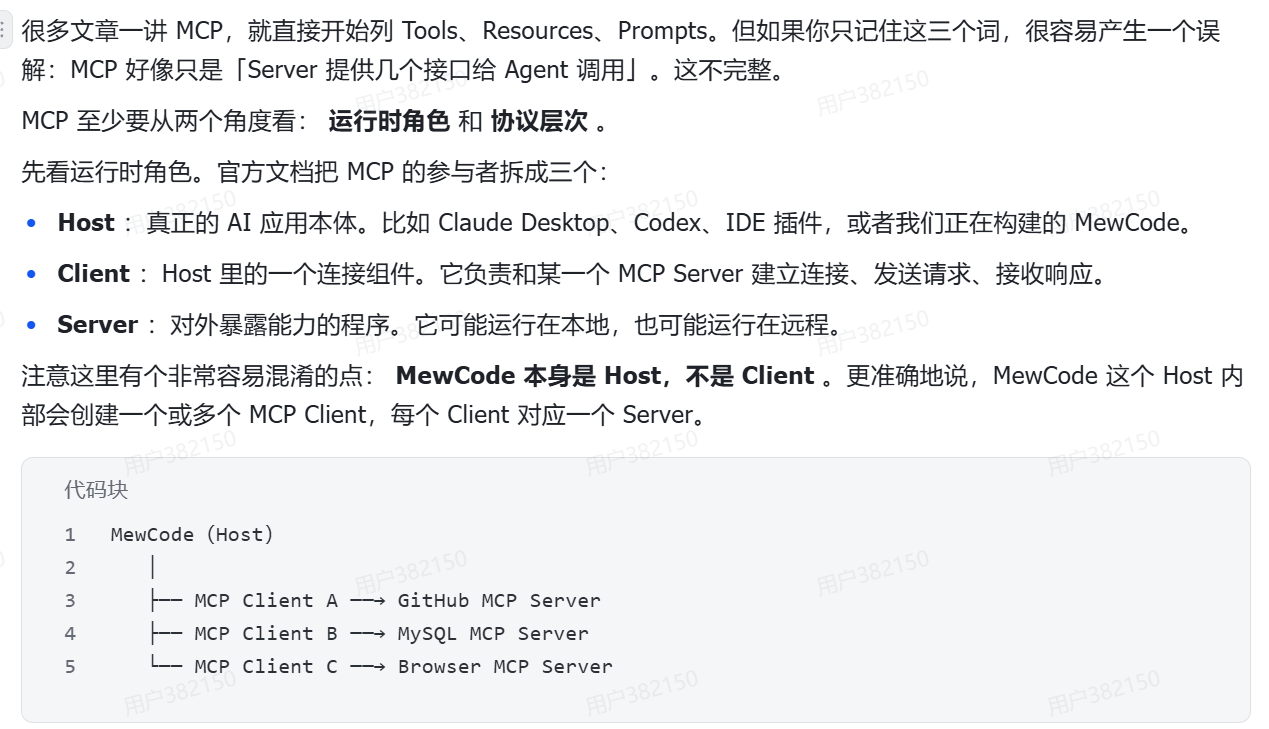
为什么要把 Client 单独拆出来,而不是让 Host 直接跟 Server 说话?因为这样”一个 Server 出问题”的影响范围就被限制在一个 Client 里了——它的连接断了、超时了、协议对不上,另外四个 Client 不受影响。这个设计在 §7 讲启动流程时还会用到。
2. 两层:消息是一层,怎么送是另一层
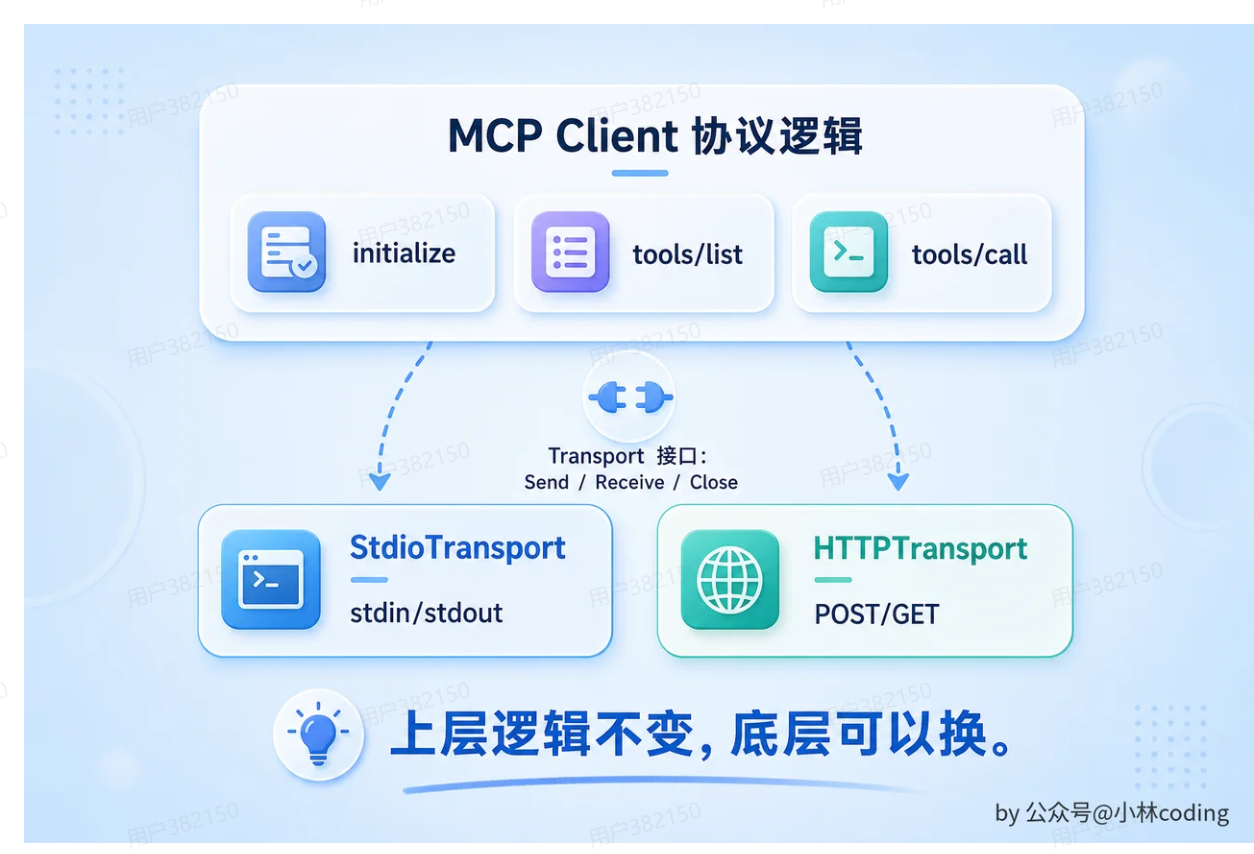
MCP 不是一个协议,是两个叠在一起的协议:
- 数据层:JSON-RPC 2.0 消息。规定请求、响应、错误各长什么样——说什么
- 传输层:stdio 或 Streamable HTTP。规定这些消息怎么从这边到那边——怎么送
打个比方:内容是信,传输是邮路。信的内容不变,运输方式可以换。
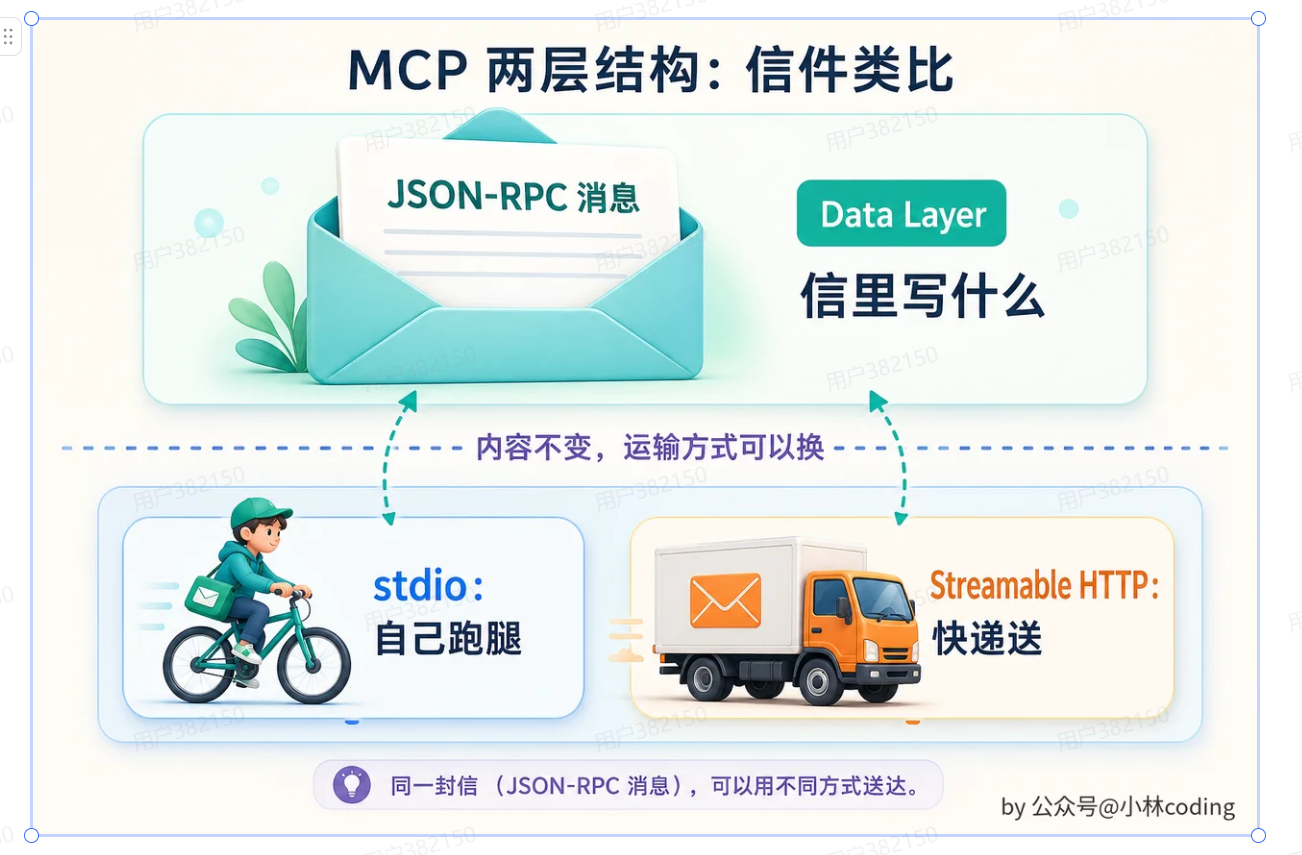
这个分层不是纸面上的——它是可以真的换的。同一个工具实现,本机跑的时候用 stdio,部署到服务器上换成 HTTP,JSON-RPC 那一层一个字都不用改。
两边各能提供什么
协议是双向的:握手时两边都要声明自己的能力。
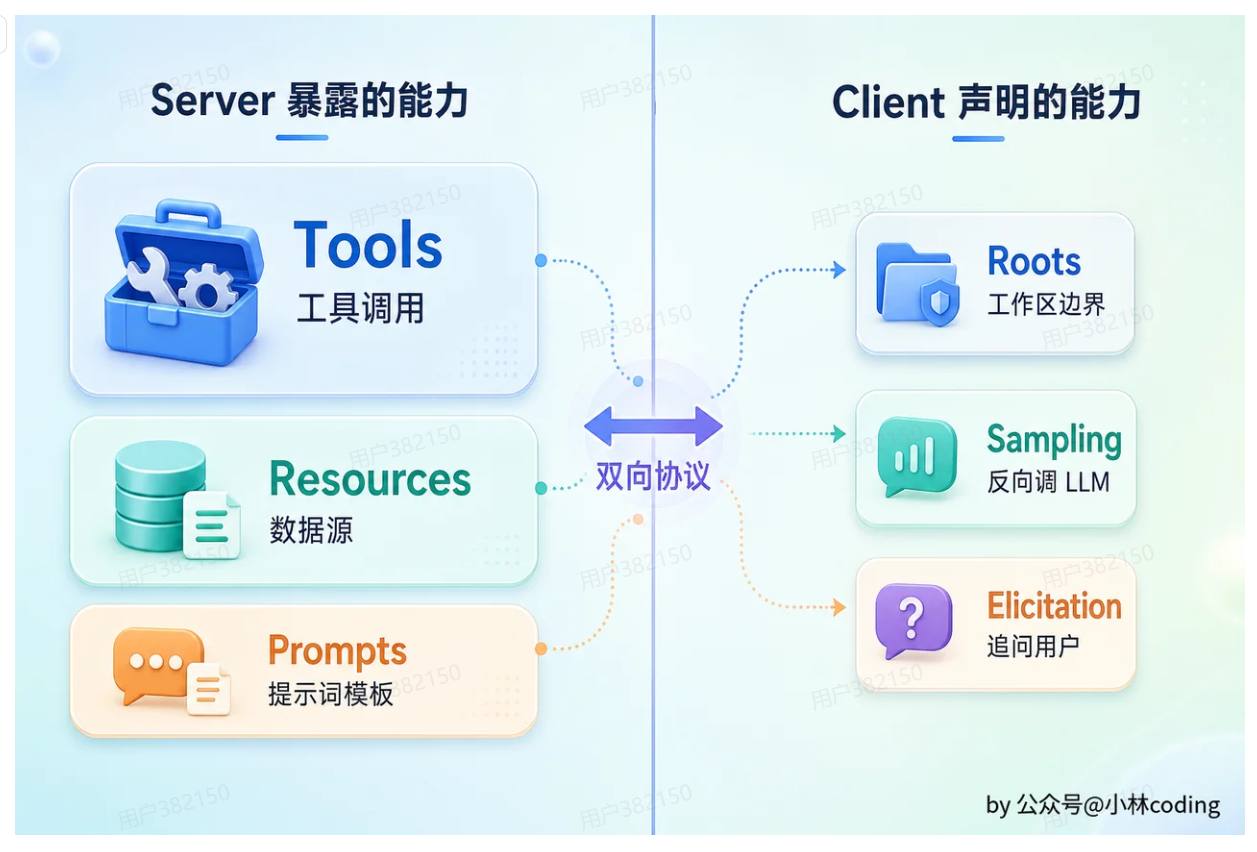
| 方向 | 能力 | 是什么 |
|---|---|---|
| Server → Client | Tools | 模型可以调用的函数(会被 LLM 当成工具列表) |
| Resources | 只读数据(文件、数据库记录),由应用决定读哪个 | |
| Prompts | 预置的提示词模板,由用户显式调用 | |
| Client → Server | Roots | 告诉 Server——我关心的范围是这些目录 |
| Sampling | Server 反过来请 Host 去调一次模型 | |
| Elicitation | Server 反过来找用户要一个输入 |
前三个词最容易被当成”三种类型的工具”,其实它们的区别在谁发起:
- Tools 是模型主动的 —— 模型决定调哪个
- Resources 是应用主动的 —— 代码决定往上下文里塞什么
- Prompts 是用户主动的 —— 比如斜杠命令,用户点了才用
记住”发起者不同”这一条,这三个词就分得开了。
3. 只有两种标准传输
截至 2025-11-25 版规范,标准传输只有两种:stdio 和 Streamable HTTP。没有 WebSocket,没有 gRPC,也没有”自定义 TCP”。
差别只有一句话:Host 和 Server 之间怎么通信。
先说一件容易被忽略的事:传输是 Host 和 Server 之间的事,跟模型完全无关。 模型看不到这一层——它只知道有个工具叫 mcp_github_search_issues,这个工具背后是管道还是 HTTP,它既不知道也不需要知道。
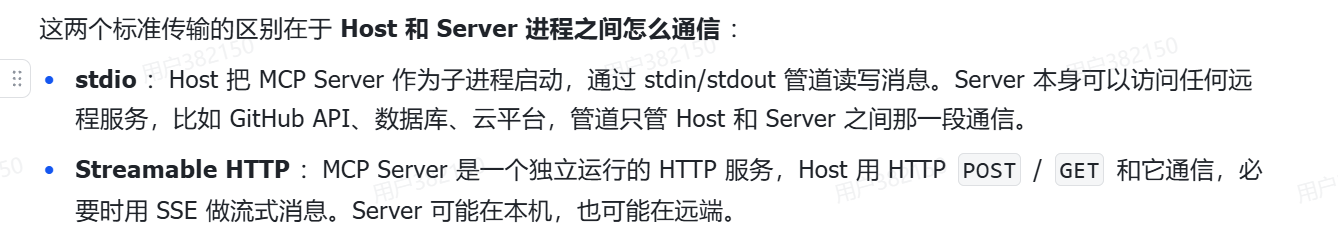
| stdio | Streamable HTTP | |
|---|---|---|
| 通信方式 | 父子进程的标准输入输出(管道) | HTTP 请求 |
| Server 怎么来 | Host 自己拉起子进程 | Server 已经跑在某个 URL 上了 |
| 认证 | 不需要——同一个进程树,密钥靠环境变量传 | 需要——HTTP 头里带 token |
| 服务范围 | 本机、这一个 Host | 可以服务多个 Host、多台机器 |
共同点两条:都跑 JSON-RPC 2.0,Client 那边的流程一模一样(下一节那三步对两种传输都成立)。
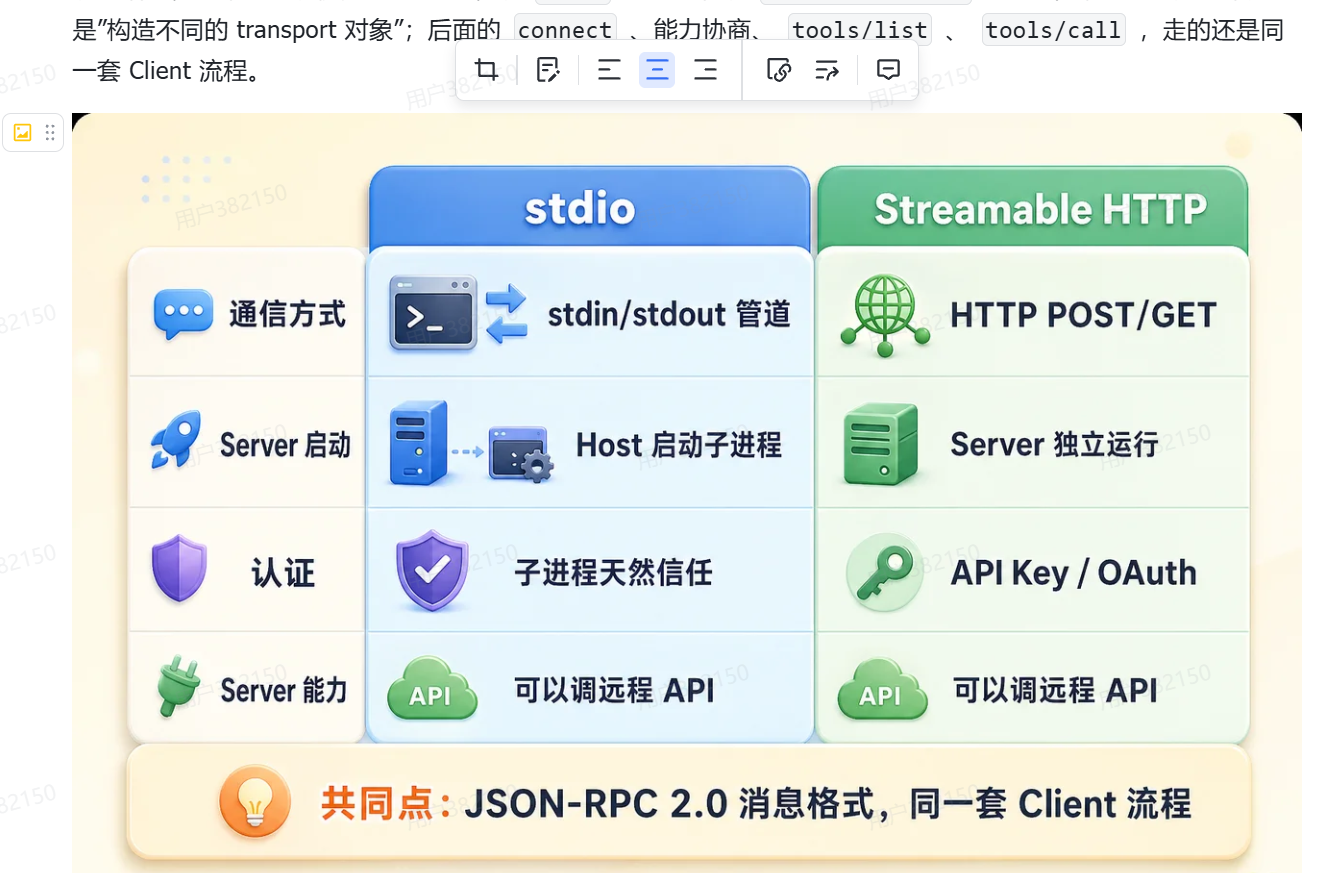
stdio:连网络都不需要
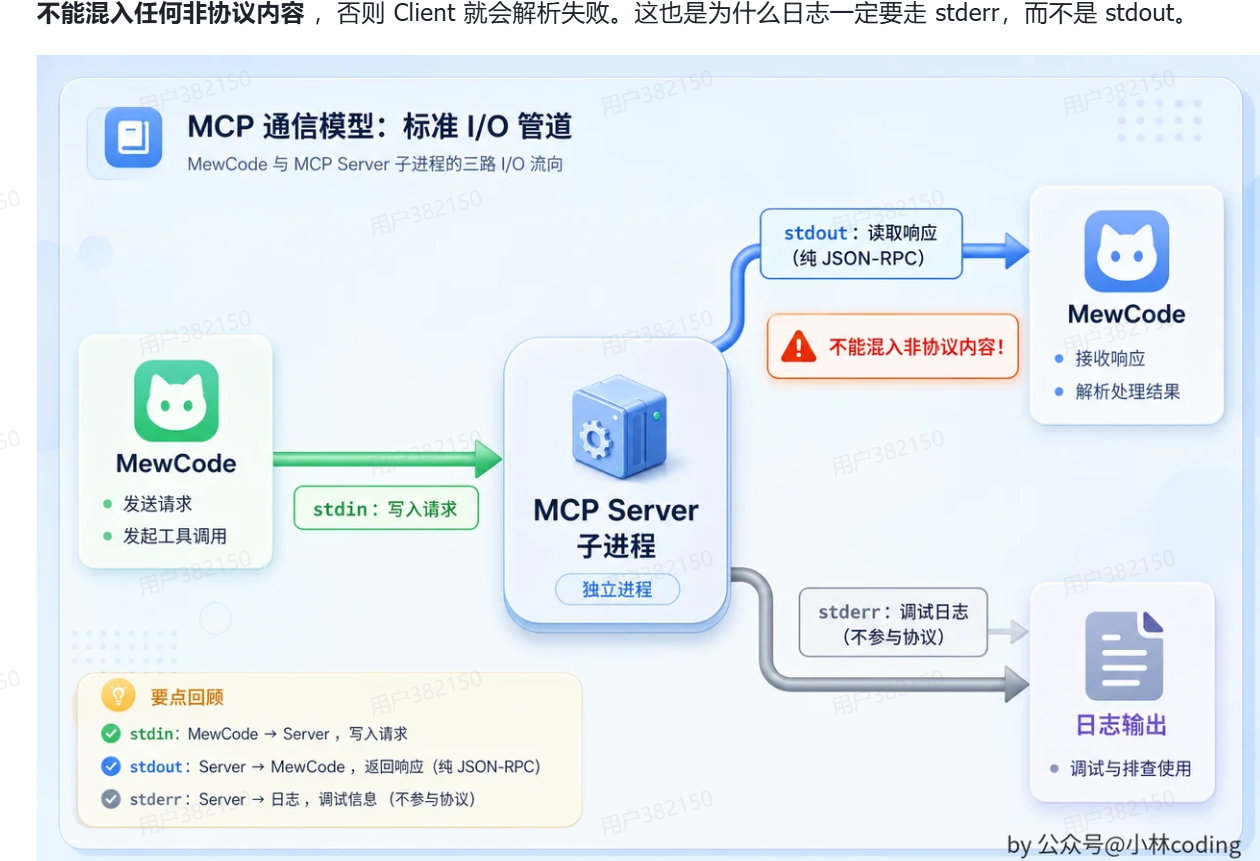
stdio 的 Server 就是一个普通的命令行程序。Host 启动时 spawn 它,然后往它的 stdin 写请求、从它的 stdout 读响应。
没有端口要占,没有防火墙要开,没有服务发现要做。 进程起来了工具就能用,Host 退出子进程跟着结束。
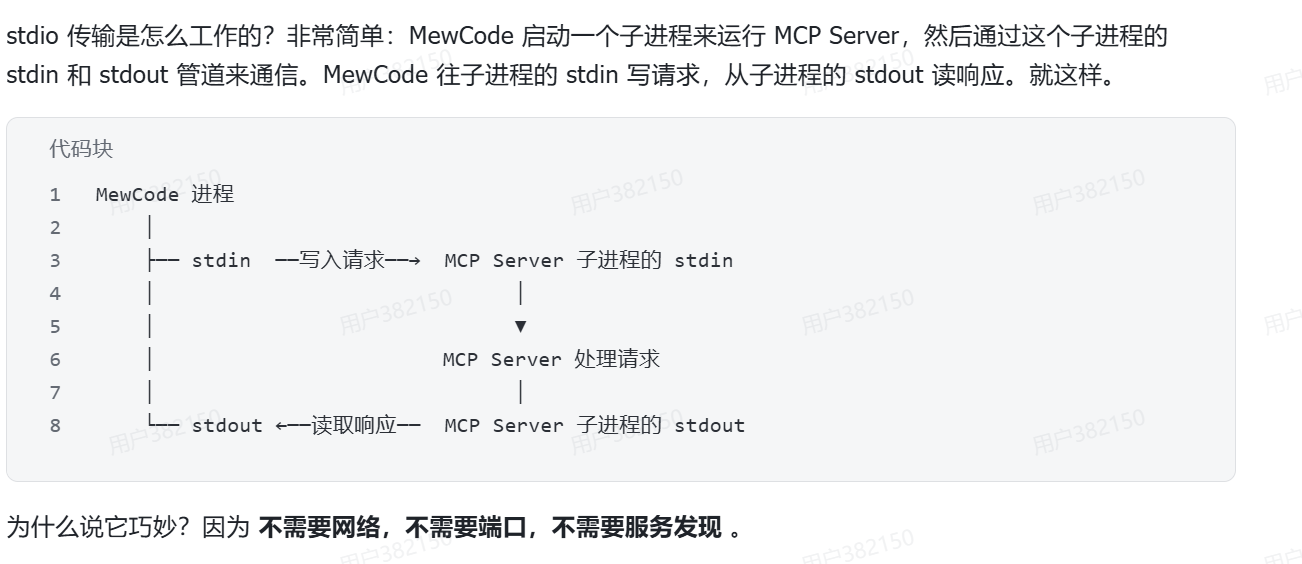
跟传统的”起个服务、开个端口、Client 连上去”比,省掉的全是运维成本:
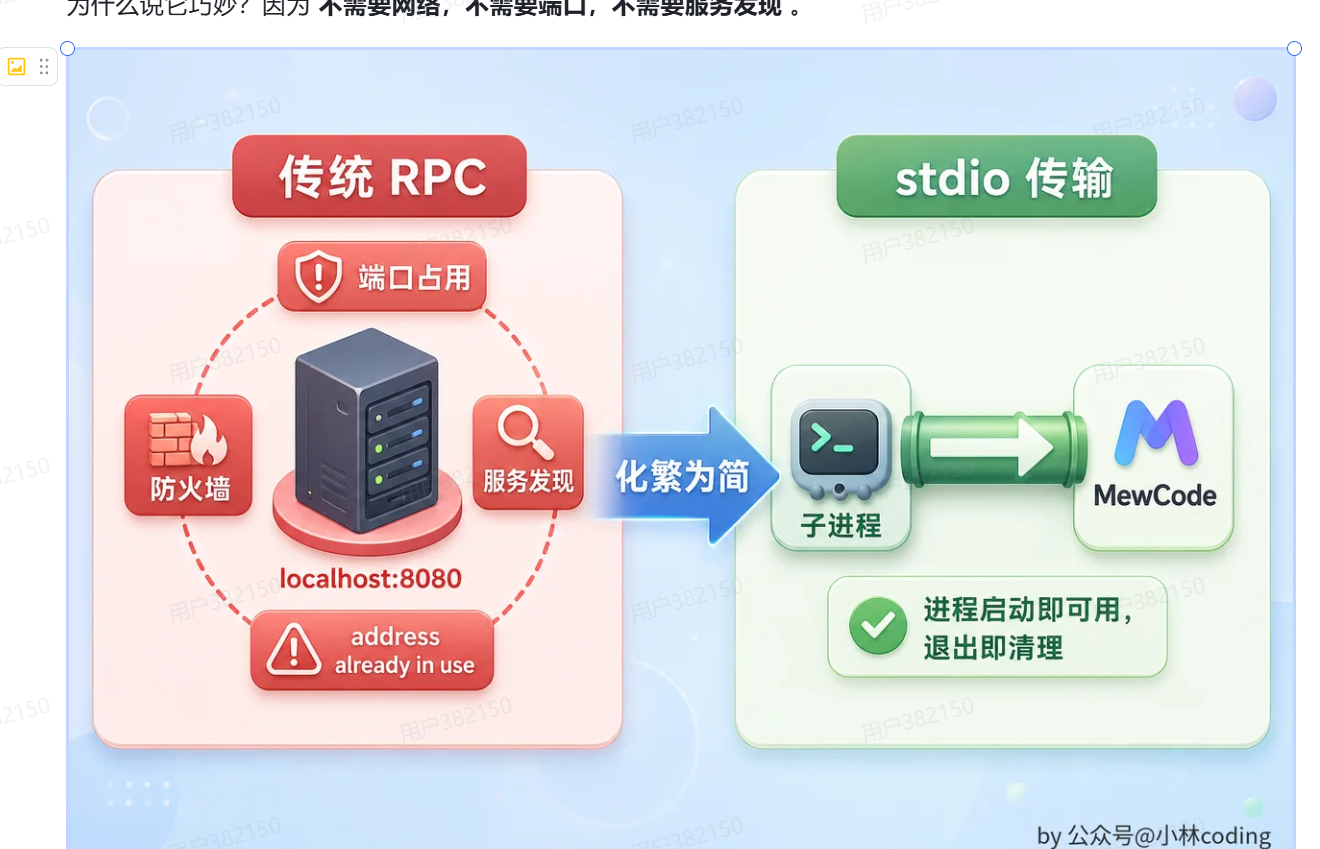
启动即用,退出即清理。 代价是这个 Server 只能被本机这一个 Host 用。
stdio 有三条 I/O 通道,职责不能混:
| 通道 | 干什么 | 谁看 |
|---|---|---|
| stdin | Host → Server 的 JSON-RPC 请求 | Server |
| stdout | Server → Host 的 JSON-RPC 响应 | Client 解析 |
| stderr | 日志、调试信息 | 人 |
stdout 上只能有 JSON-RPC,一个字符都不能多。
在 Server 里随手写一句 print("starting..."),那行字就会跟 JSON 混在一起,Client 解析直接失败。这是写 MCP Server 最容易踩的第一个坑——要打日志,走 stderr。
Streamable HTTP:一次 POST,两种响应
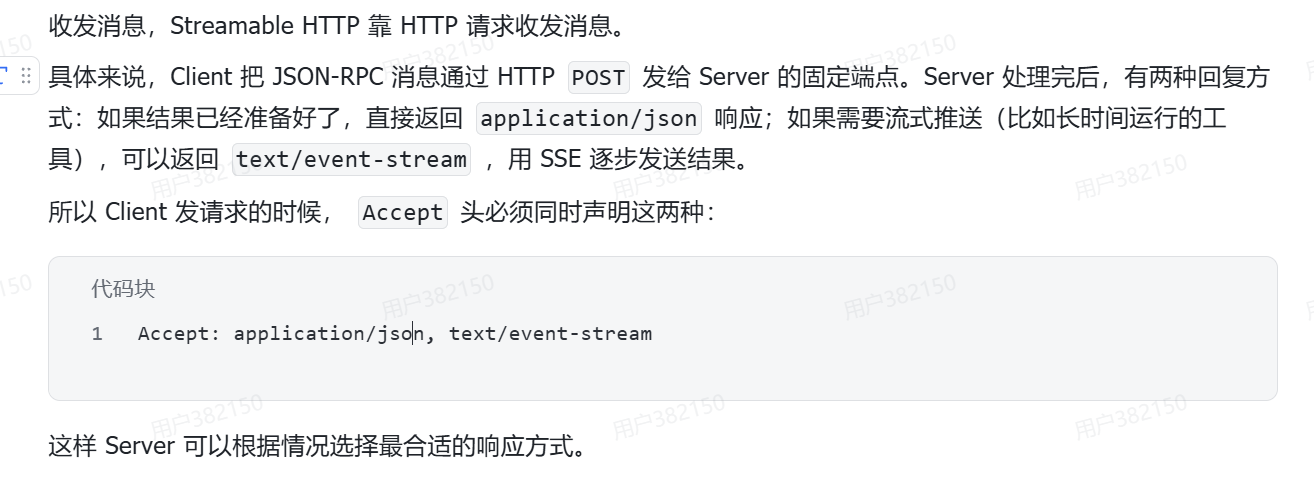
Server 部署在某个 URL 上,Client 往里 POST JSON-RPC 消息。响应有两种形态:
application/json—— 一问一答,普通请求走这条text/event-stream—— SSE,Server 要分多次往前推(进度通知、长任务)时走这条
所以请求头里的 Accept 必须两种都声明:
1 | Accept: application/json, text/event-stream |
只写一种,Server 想用另一种回你的时候就没得选了。
4. 一次连接的三步
两种传输之上,逻辑层的流程是同一套:
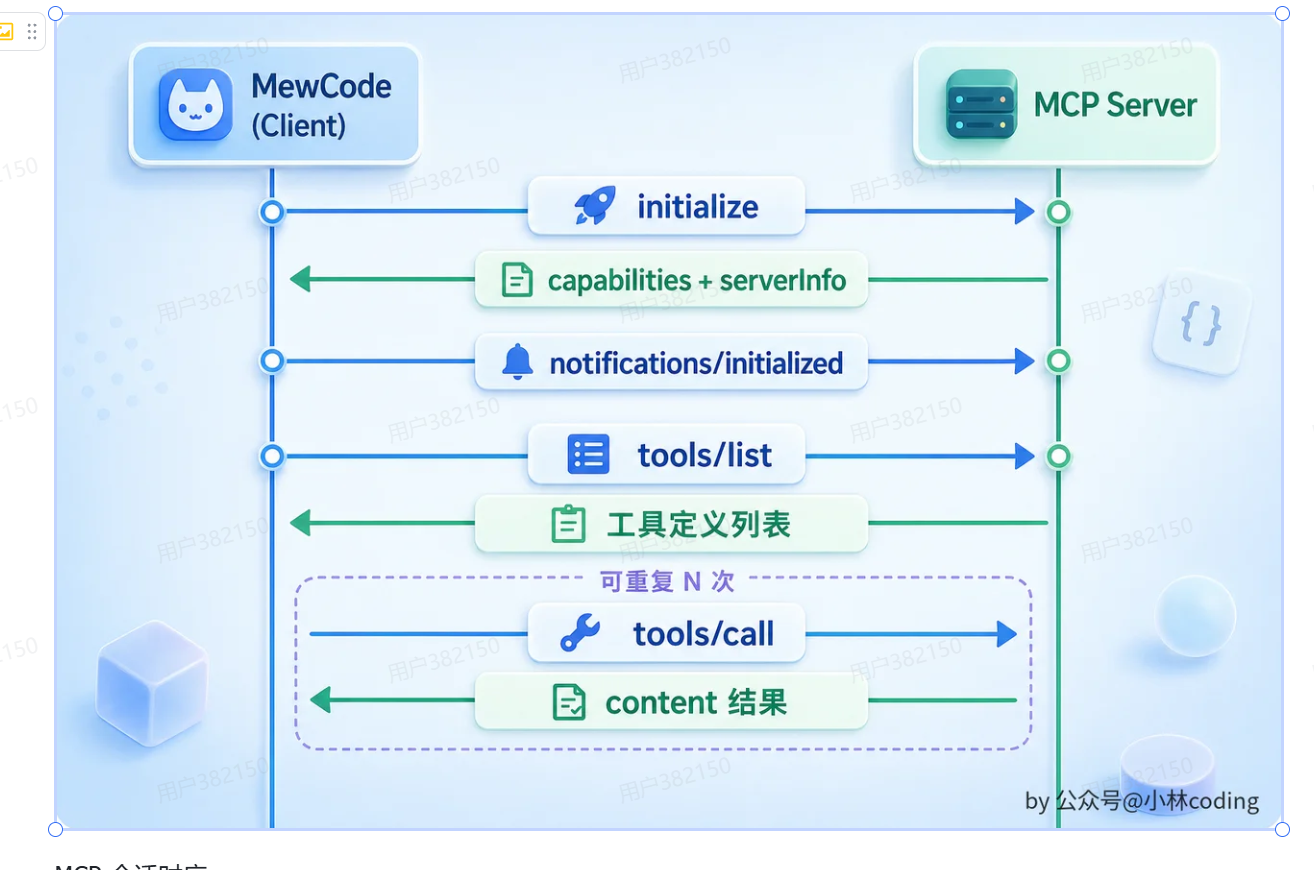
initialize → notifications/initialized → tools/list → tools/call × N
前三步整个连接只做一次,第四步重复无数次。
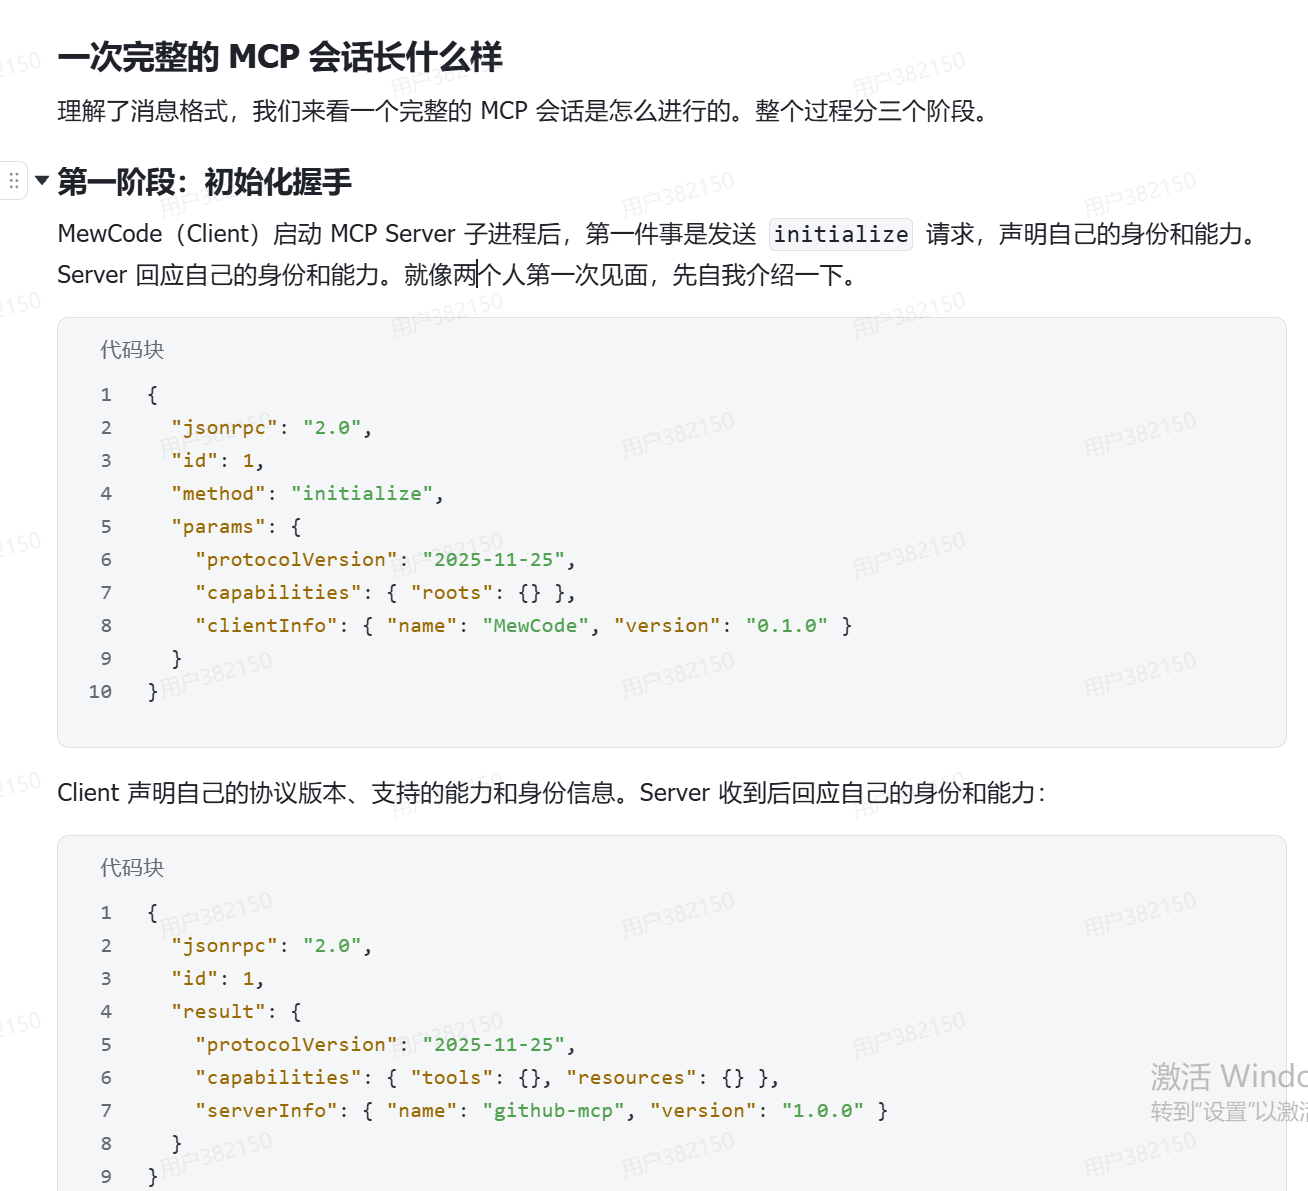
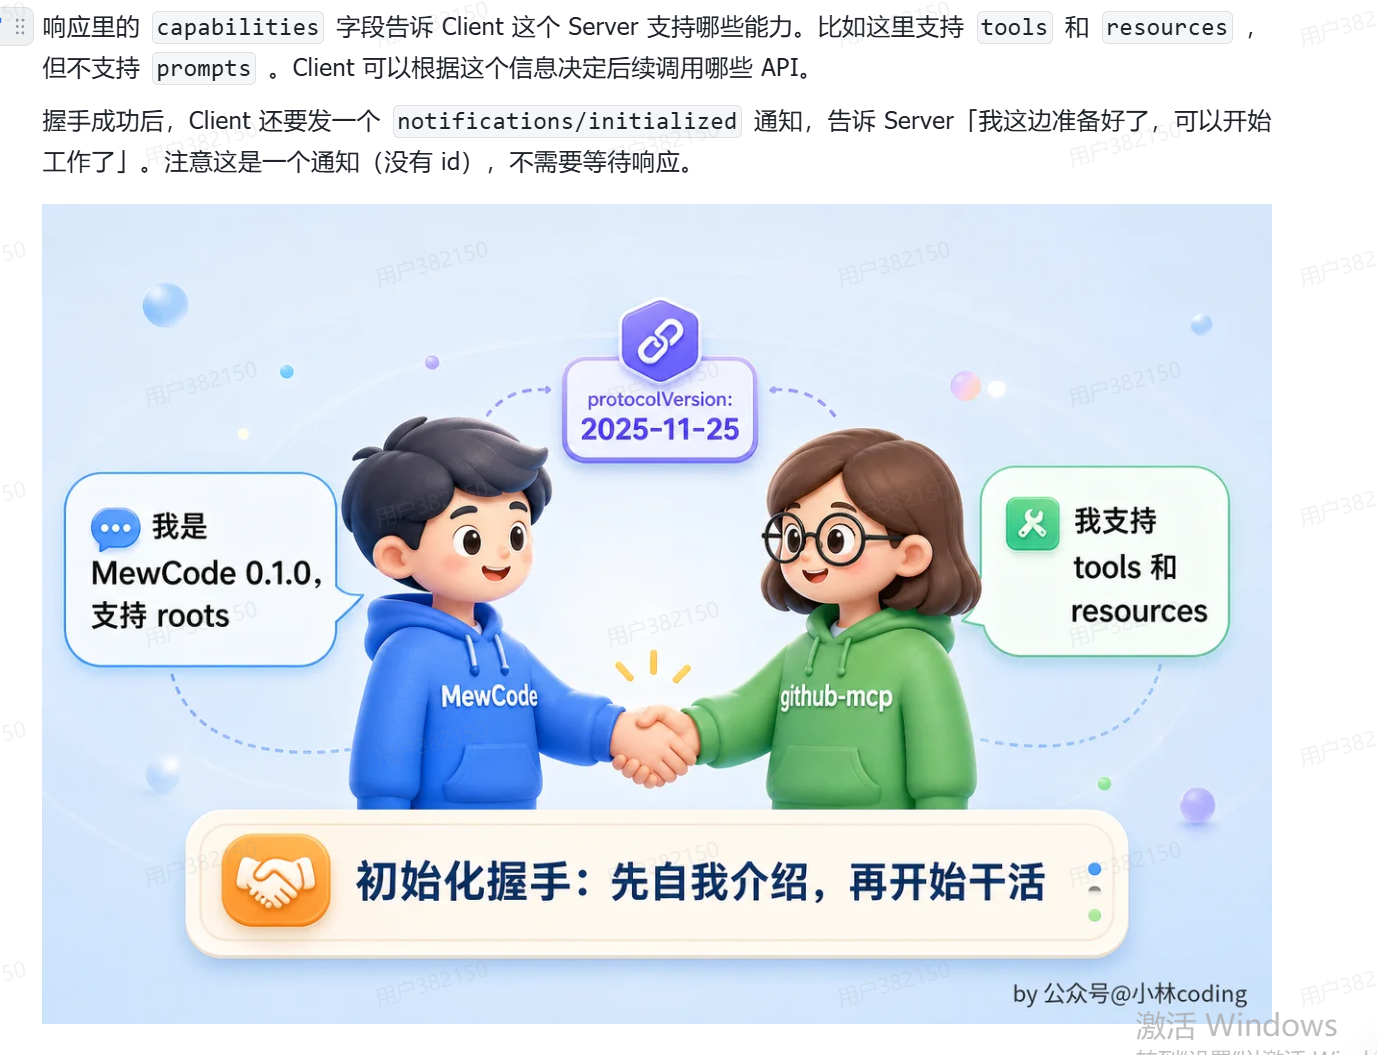
第一步:initialize 握手
Client 先发请求:
1 | { |
Server 回:
1 | { |
两边交换的是三样东西:
protocolVersion—— Client 说”我想用 2025-11-25”。如果 Server 不支持,它回一个自己能支持的版本,以 Server 的为准capabilities—— Server 说”我提供 tools 和 resources,不提供 prompts”;Client 说”我支持 roots 和 sampling”。这是能力协商:之后双方只会调用对方声明过的东西clientInfo/serverInfo—— 名字和版本,出错的时候拿来对账
握手响应回来后,Client 还要再发一条通知:
1 | { "jsonrpc": "2.0", "method": "notifications/initialized" } |
它没有 id。在 JSON-RPC 里,没有 id 的消息就是通知——对方不需要回。
为什么要多这一条?因为 initialize 的响应发出去时,Server 并不知道 Client 收好了没有。这条通知是一个明确的”我这边准备好了,可以开始干活”。
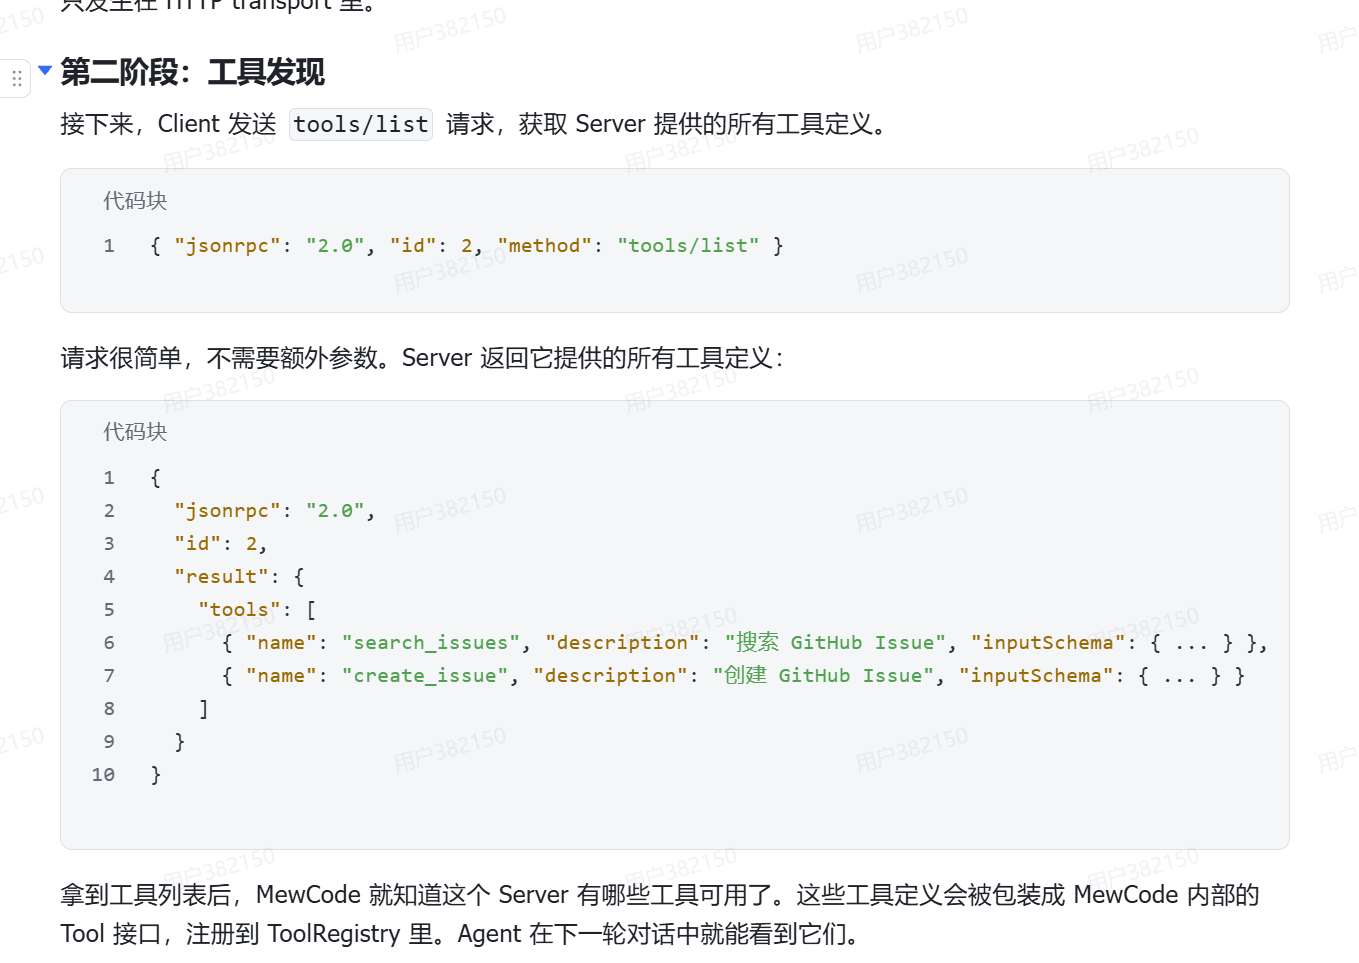
第二步:tools/list——把工具清单拿回来
1 | { "jsonrpc": "2.0", "id": 2, "method": "tools/list", "params": {} } |
1 | { |
inputSchema 就是一份 JSON Schema——跟 LLM API 里那份是同一个东西。叫法是各家的:Claude 是 input_schema,OpenAI 是 parameters,MCP 是 inputSchema。
这里只列了 tools。如果 Server 还提供 resources 和 prompts,另有 resources/list 和 prompts/list,形状一样。
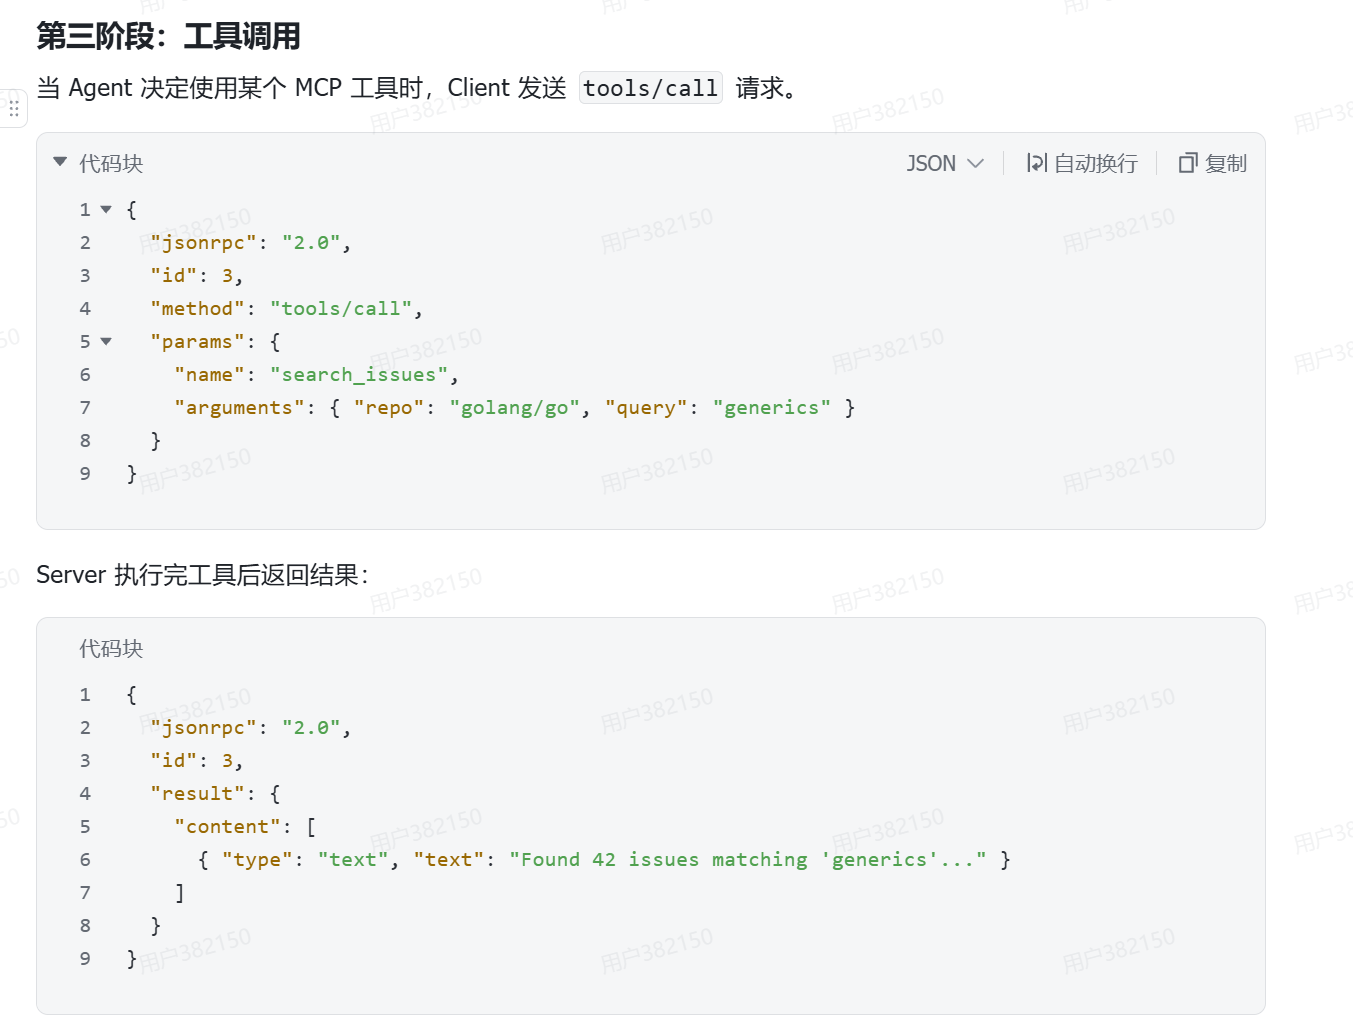
第三步:tools/call——真正调用
1 | { |
1 | { |
两个细节值得停一下:
一、参数是 arguments,一个对象。 模型给的参数直接放进去,不用自己 json.loads。
二、结果不是字符串,是一个 content 数组。 文本、图片、音频都能放——因为工具的输出本来就不一定是纯文本。截图、图表、文件引用都要能回。这跟 tool_result 的 content 是同一个思路。
还有 isError 这个字段:
工具执行失败时,Server 回的是 "isError": true 加一段错误说明,而不是一个 JSON-RPC 错误。 道理和上一篇 §4 一样——JSON-RPC 错误是给程序看的(协议层出问题了,比如方法名写错),isError 是给模型看的(工具跑了,但没跑成)。后者模型有机会自己纠正,所以必须让它看到。
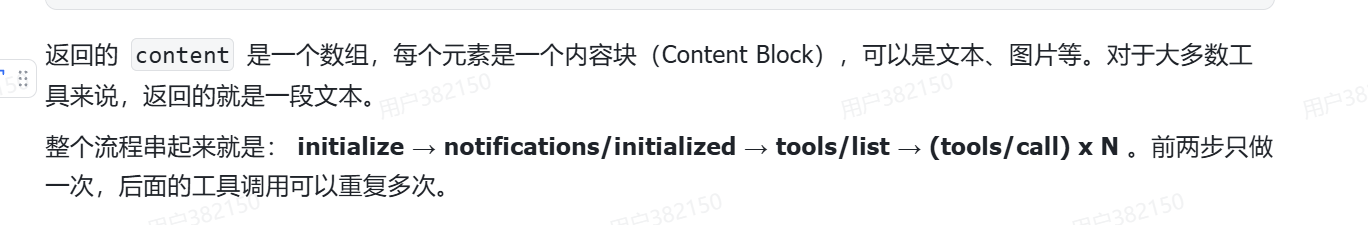
把顺序串起来,一次完整会话就是:
1 | initialize ← 握手:版本 + 能力 + 身份 |
一个版本提示
上面这套握手,在 2026-07-28 那版规范里被整个去掉了。
那一版取消了 initialize / notifications/initialized,改成按需调用 server/discover 查能力;协议版本、客户端身份这些信息改成跟着每一个请求走(放在 _meta 里)——也就是连接不再有”状态”。同时 Roots、Sampling、Logging 三个能力被标记为废弃。
这篇按 2025-11-25 讲,原因是现在在跑的 Server 绝大多数还是这一版,而规范给废弃留了至少 12 个月的窗口。看别人的代码时如果只看到 server/discover 没看到 initialize,那就是新版的写法。
5. 请求和响应怎么配对
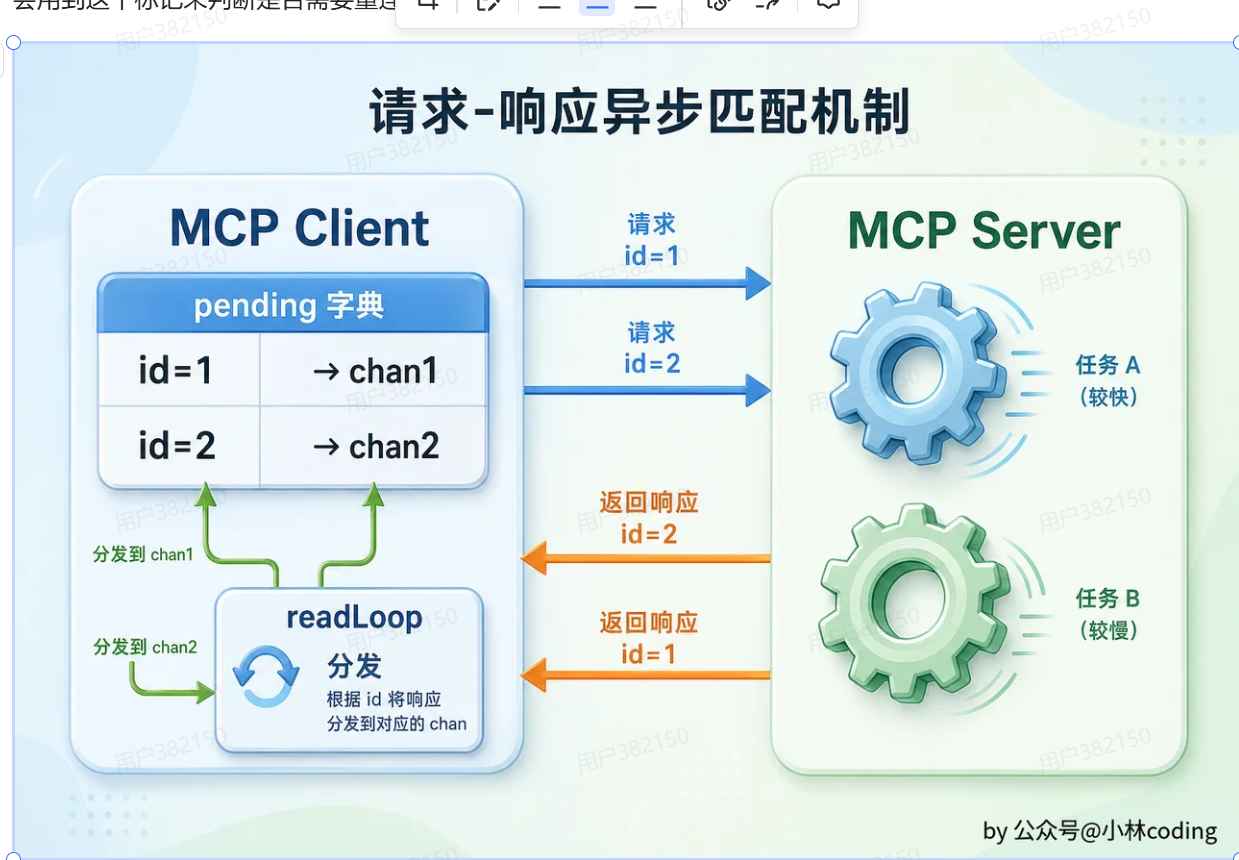
上面写的是”一问一答”的顺序版。真实实现里,响应是可能乱序回来的——尤其用 HTTP 并发调三个工具的时候。
Client 的做法是一张待处理表:
1 | pending = {} # id → 等待这个响应的队列 |
三个要点:
- 请求发出前先把
id → 队列记下来。 不能等响应回来才建——响应比登记快的时候,消息就丢了 - 派发靠
id,不靠到达顺序。 谁先回来不影响谁是谁 - 没有
id的消息是通知,走另一条路。它可能是 Server 主动推的进度更新,也可能是它在用 Sampling 反过来请求 Host 调模型
6. 工具接进来之后:注册到同一张工具表
tools/list 拿回来的东西,接下来要做一件事:包装成本地工具,注册进 Agent 自己的工具表。
转换很轻——inputSchema 和 Claude 的 input_schema 基本一一对应,改个字段名就行。注册完之后,工具表里会同时躺着两类工具:
| 来源 | 名字 |
|---|---|
| 内置 | ReadFile / Bash / Grep |
| MCP(github Server) | mcp_github_search_issues |
| MCP(db Server) | mcp_db_query |
| MCP(slack Server) | mcp_slack_send |
加前缀是为了防重名。 两个 Server 各提供一个叫 search 的工具,前缀一加就分得开了——顺便也告诉模型”这个工具来自哪个 Server”。
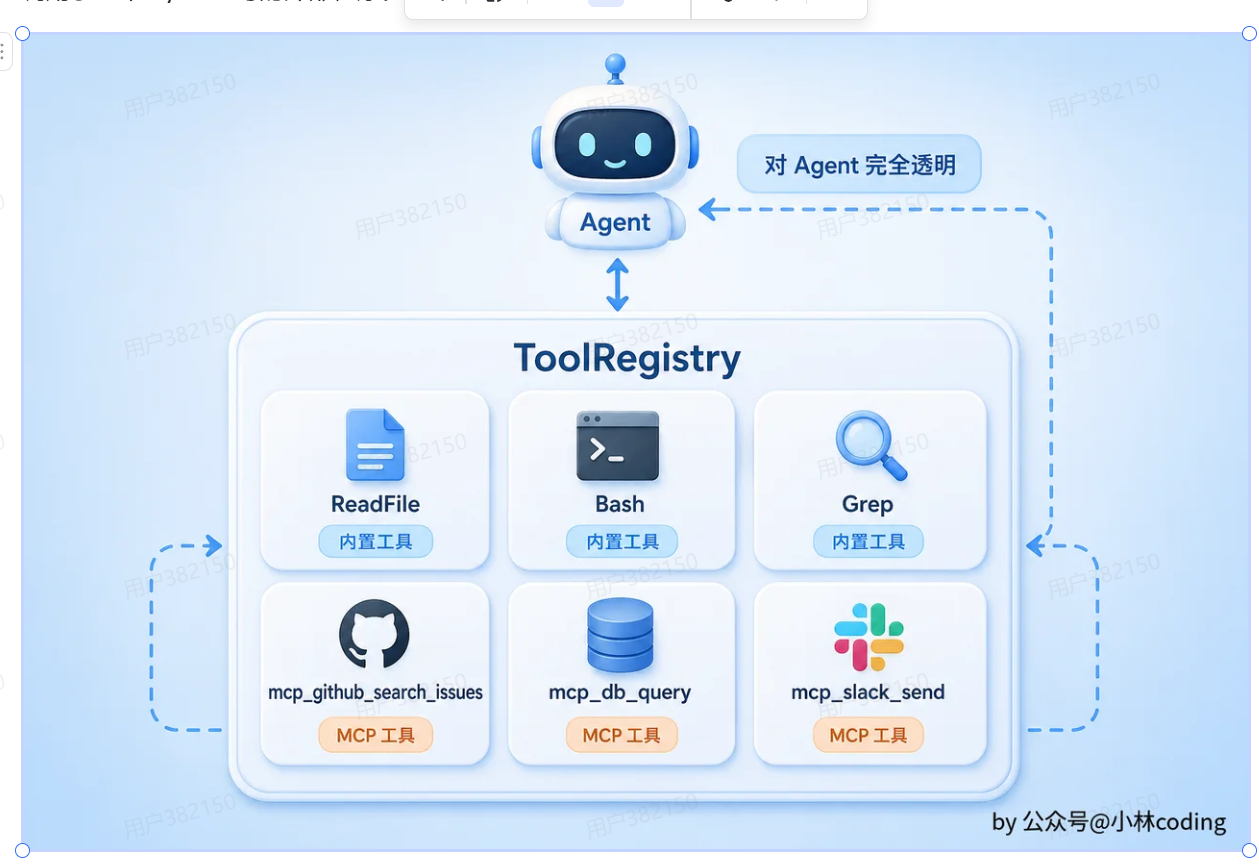
对 Agent 来说,这两类工具没有区别。 Agent Loop 那一层完全不知道 mcp_github_search_issues 背后是一根管道、一个子进程,还是一个大洋彼岸的 HTTP 服务——它只是拿到一个名字和一份 schema,执行,拿结果。
这正是 MCP 想要的效果:把”工具从哪来”这件事,挡在工具表以下。
工具表对外只需要一个取 schema 的方法:
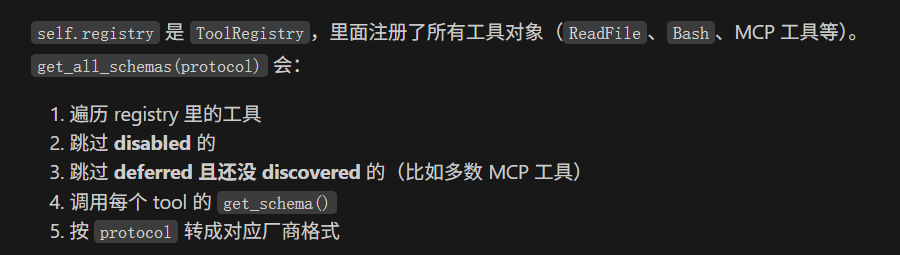
1 | tools = self.registry.get_all_schemas(self.protocol) |
protocol 是”这份 schema 给谁用”——Claude 一套形状,别的供应商另一套。同一个工具表,为不同供应商翻译成不同格式,这个转换只在这一个地方做。
这个方法内部除了遍历和转换,还有两个跳过条件:disabled 的(被用户关掉的),以及 deferred 且还没被 discovered 的。第二个是延迟加载用的,§8 展开。
7. 配置与启动
配置差不多长这样:
1 | mcp_servers: |
用哪种传输,判据就一条:有 command 是 stdio,有 url 是 HTTP。 不需要另写一个 type 字段——这两个字段天然互斥,写不出”两个都有”的配置。
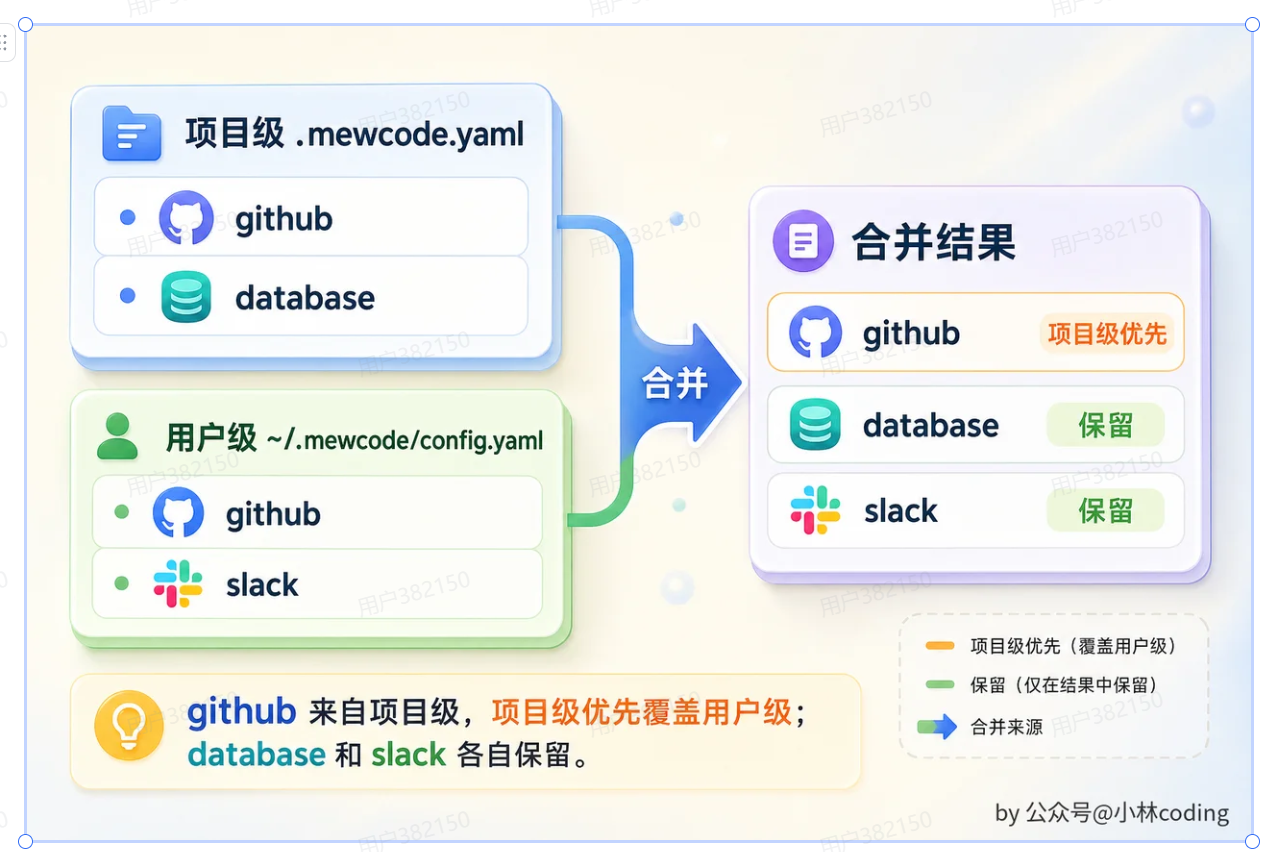
配置分两级,项目级覆盖用户级:
| 级别 | 位置 | 放什么 |
|---|---|---|
| 用户级 | 家目录下的全局配置 | 你个人常用的 Server、个人 token |
| 项目级 | 项目根目录下的配置文件 | 只有这个项目需要的 Server |
合并规则是按 Server 名字逐项覆盖:项目级里同名的那一项整个替掉用户级的,其余的用户级项保留。
这样团队可以把”这个项目要连哪个数据库”写进仓库,而每个人自己的 token 留在本地。${GITHUB_TOKEN} 这种写法是关键:配置文件进仓库,密钥不进仓库。
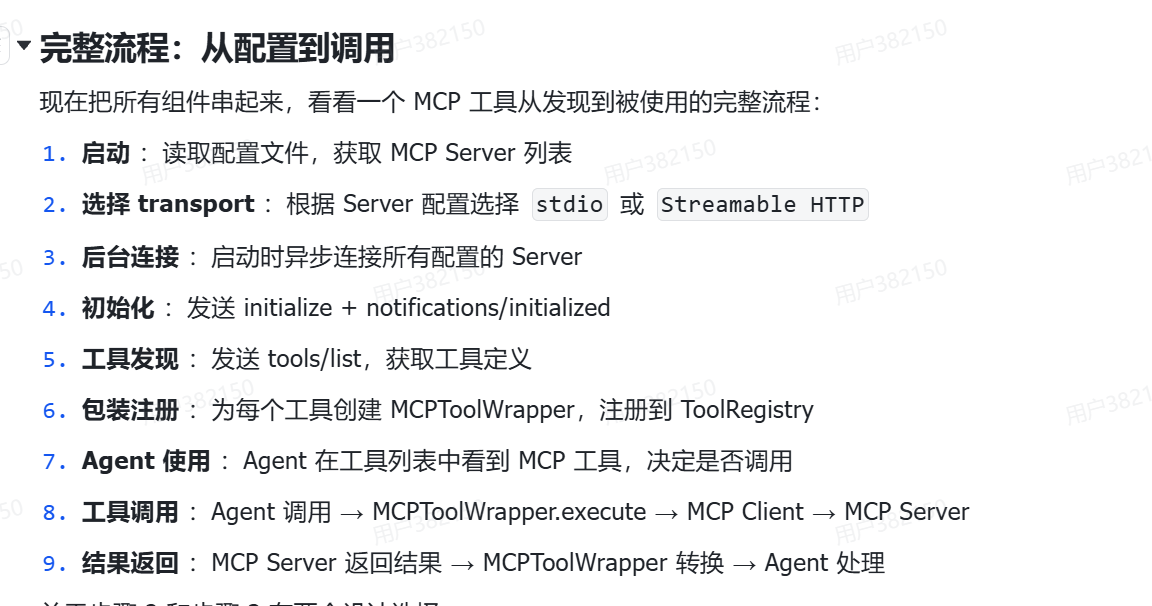
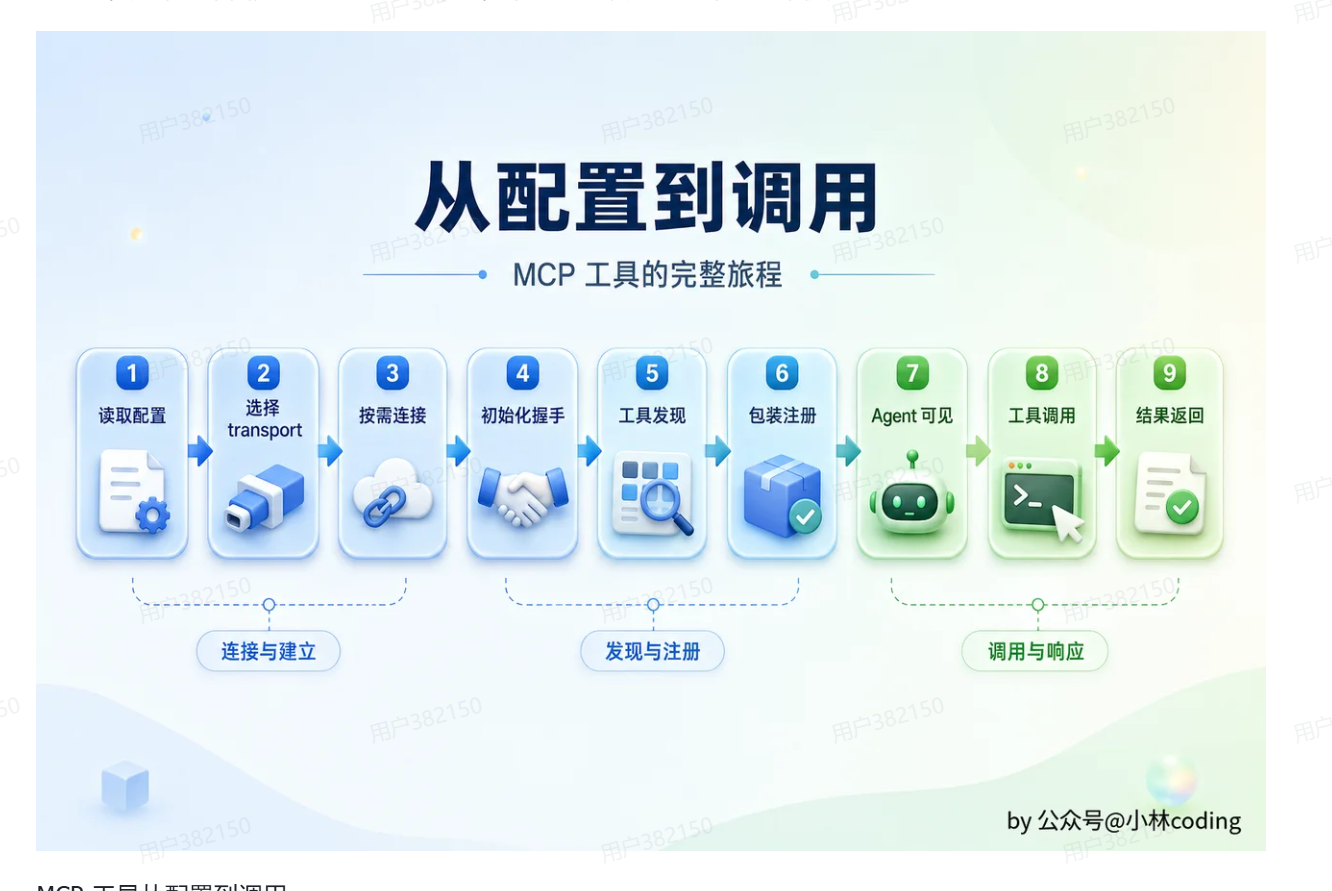
启动时按顺序发生的事
- 读两级配置,合并出最终的 Server 列表
- 每个 Server 看它是
command还是url,决定用哪种 transport - 后台建立连接(不阻塞主流程)
initialize握手tools/list拉工具清单- 包装成本地工具,注册进工具表
- Agent Loop 正常跑——取工具表时,MCP 工具已经在里面了
- 模型要调某个 MCP 工具 → 转成
tools/call发过去 - 结果转回
tool_result塞回 messages
其中两处工程上的选择值得单独说。
一、连接是后台做的,启动不等它。 某个 Server 起不来(网络不通、npx 装不上、命令不存在),只打一条警告,不阻止启动——其他工具照常可用。一个 Server 挂掉,不该让整个 Agent 用不了。 这也是 §1 把 Client 拆成一对象一连接的好处:坏的只坏那一个。
二、连接是复用的。 握手和 tools/list 一个进程里只做一次,之后一直用同一条连接。不是每次调工具都重连——那样每个调用都要多两个往返。
顺带一提,这个”启动时后台连上所有 Server”的做法,主流 Coding Agent 基本都是这么干的——因为它对用户来说延迟最低:等你打完第一句话,工具早就在了。
8. 工具太多:延迟加载
接 10 个 Server 就是几百个工具,而工具定义本身就要吃掉上下文:
| 工具定义占的 token | |
|---|---|
80 个工具全量塞进 tools |
约 15,000 |
| 只塞核心工具 + 一个检索工具 | 约 1,000 |
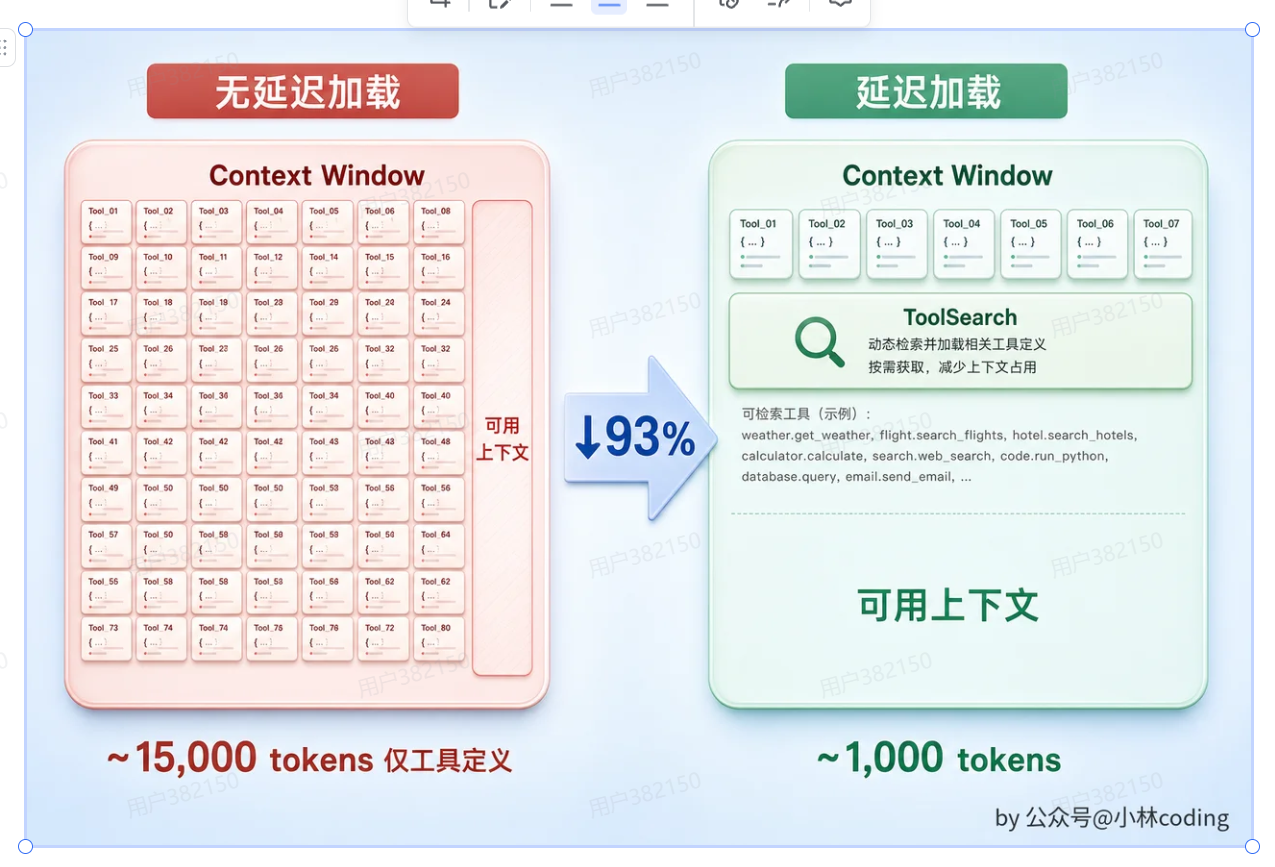
麻烦的地方在于,tools 是每一轮请求都要整份发出去的(上一篇 §5:API 无状态,messages 只增不减、每轮整个发一遍,tools 也在里面)。15,000 token 的固定开销乘上几十轮——活还没开始干,成本已经花掉一大截。
比钱更麻烦的是效果:几百个工具一次摆给模型,选错工具的概率明显上升。
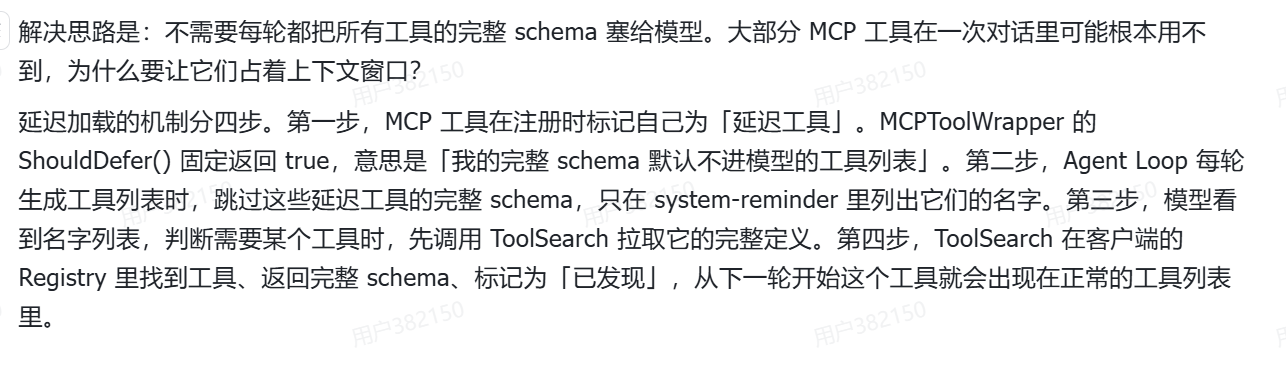
做法是把它们延迟加载,分四步:
- 注册时就标记成”延迟”的——MCP 工具默认都算这一类。因为几百个工具里,一次任务真正会用到的一般就那么几个
- 生成工具列表时跳过它们的完整 schema,只在 system-reminder 里列个名字。模型知道”有这么个东西存在”,但不用付完整定义的 token
- 模型需要的时候,调一个叫
ToolSearch的工具把完整定义拉出来 - Registry 返回 schema,同时把它标记为「已发现」——从下一轮起,它就跟普通工具一样出现在
tools里了
两轮下来的样子:
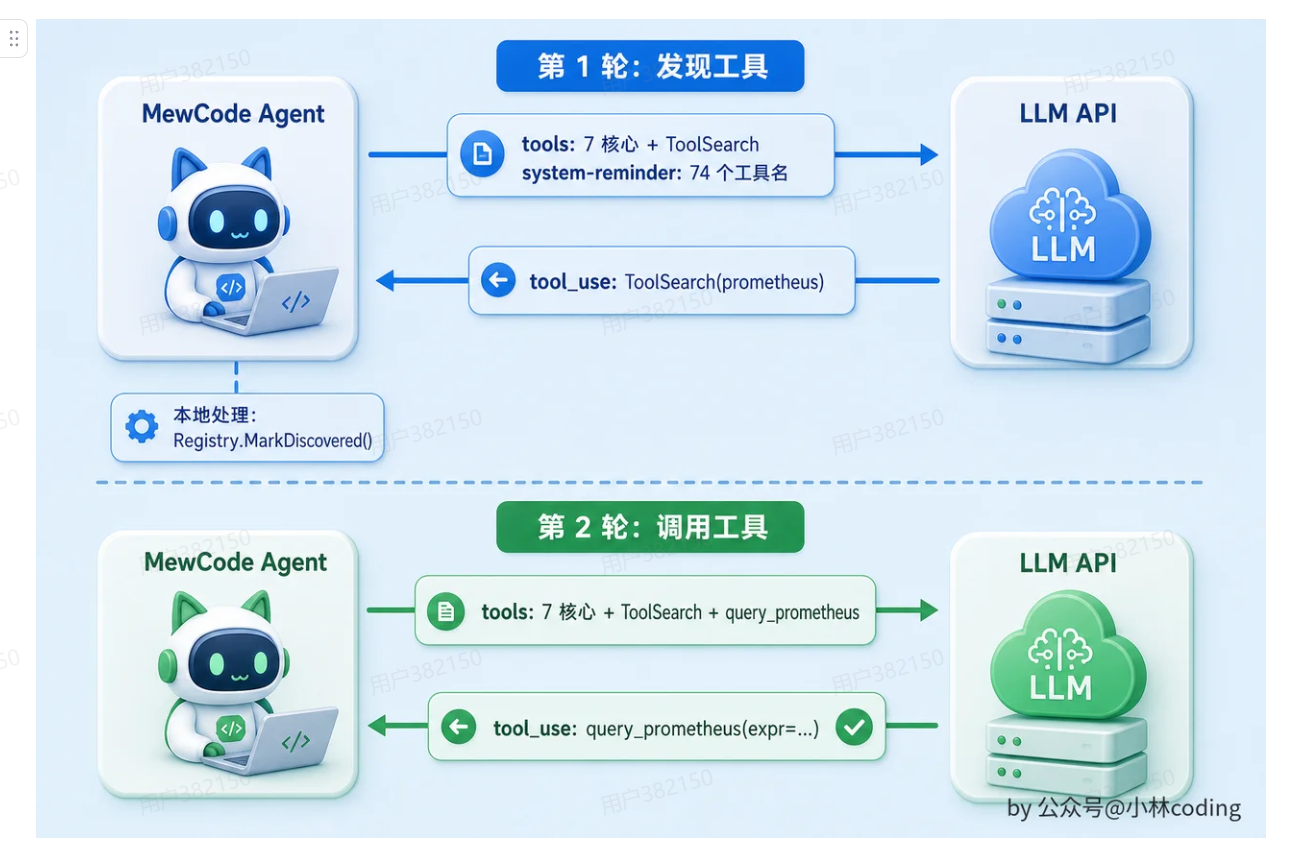
- 第 1 轮:
tools里只有 7 个核心工具 +ToolSearch,system-reminder 里挂着 74 个工具名。模型看到里面有 Prometheus 相关的名字,调ToolSearch("prometheus");本地把它标记为已发现 - 第 2 轮:
tools里多了一个query_prometheus,模型这一轮就能直接调它了
代价是最坏情况多花一轮。 模型得先”搜”再”用”,多一次往返。
所以核心工具(读文件、跑命令、搜索)不该延迟——它们每轮都在用,延迟了等于每轮都多一轮,那就本末倒置了。
9. 小结
一、MCP 解决的是 N×M 的接线问题。 三个角色:Host 是程序,Client 是 Host 里的连接对象(跟 Server 一对一),Server 是能力提供方。
二、它分两层:JSON-RPC 2.0 管”说什么”,stdio / Streamable HTTP 管”怎么送”。 换传输,上层逻辑不变。
三、stdio 不需要端口和认证,代价是本机专用。 三条 I/O 通道职责不能混——stdout 上只能有 JSON-RPC。Streamable HTTP 的 Accept 要同时声明 application/json 和 text/event-stream。
四、一次连接三步:initialize → notifications/initialized → tools/list,之后 tools/call 重复 N 次。 前三步只做一次。握手协商的是版本、能力、身份三样东西。
五、MCP 工具和内置工具注册进同一张工具表,加 Server 名前缀防重名,对 Agent Loop 完全透明。连接后台建立、失败只警告——一个 Server 挂掉不该拖垮整个 Agent。
六、工具多的时候要延迟加载:默认只给名字,用 ToolSearch 按需拉完整定义。省 token,也提高选对工具的概率;代价是最坏情况多一轮。
参考
- MCP 官方规范(2025-11-25):https://modelcontextprotocol.io/specification/2025-11-25
- 生命周期(
initialize握手):https://modelcontextprotocol.io/specification/2025-11-25/basic/lifecycle - 传输(stdio / Streamable HTTP):https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- 2026-07-28 变更(移除握手、
server/discover、废弃 Roots / Sampling / Logging):https://modelcontextprotocol.io/specification/2026-07-28/changelog - 上一篇:ReAct 与 Agent Loop —— https://wywzixin.github.io/agent/react-agent-loop/
- LLM 请求与流式响应 —— https://wywzixin.github.io/agent/llm-request-streaming/