上下文压缩与 Token 管理
Agent 的上下文管理分两层:便宜的那层先把大结果挪出上下文,贵的那层用一次 LLM 调用把历史压成摘要。
设计哲学四个字:能轻则轻。轻量手段能扛住的,绝不动用昂贵的全量摘要。
| 第 1 层:大结果存磁盘 | 第 2 层:全量摘要 | |
|---|---|---|
| 信息损失 | 几乎为零 | 高 |
| API 开销 | 零 | 高(多一次 LLM 调用) |
| 定位 | 便宜的预防 | 贵但强的兜底 |
问题本身上一篇已经说清了:messages 只增不减、每轮整个发一遍,token 消耗是平方级增长(ReAct 与 Agent Loop §5)。而上下文窗口是个硬数字——200,000 就是 200,000,超了 API 直接拒绝。
所以不能等它涨到极限,得主动管。
1. 两层管的是两个不同的东西
先说清楚这两层不是”简单版”和”复杂版”,它们解决的是不同维度的问题:
- 第 1 层管单条消息的大小 —— 防止一次超大的工具输出直接把上下文撑爆
- 第 2 层管对话历史的累积长度 —— 防止几十轮对话下来总量超限
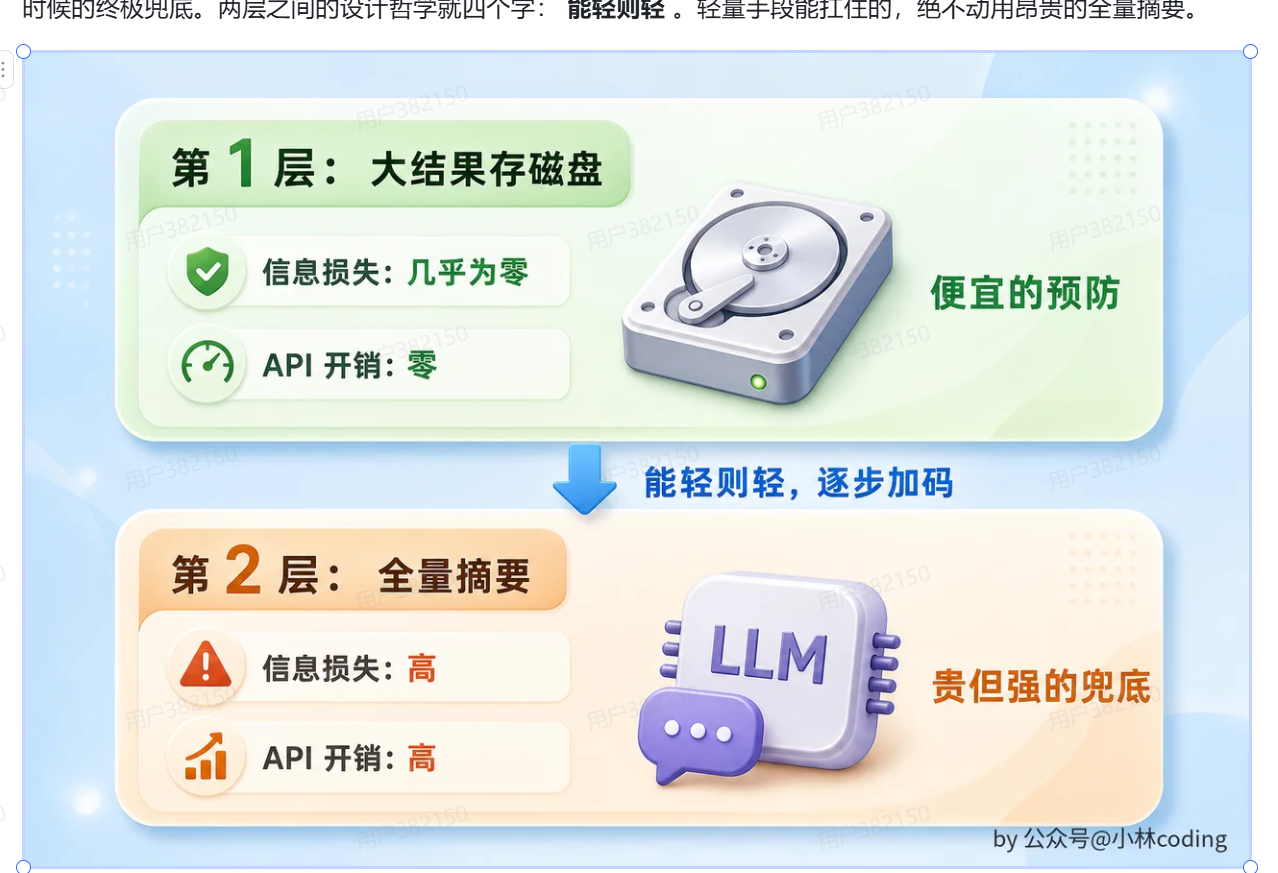
两个运行场景能把这个分工说透:
- Agent 连着读了 20 个小文件,每个都没超第 1 层的阈值,第 1 层什么也没做;但累积下来总量逼近 167K,第 2 层触发,把 20 轮对话压成一份几千 token 的摘要
- Agent 执行了一条命令,输出 80K 字符日志。第 1 层把它存盘、只留 2K 预览;上下文总量离阈值还远,第 2 层完全不触发
两层各管各的,谁也不越界。 下面逐个说。
2. 第 1 层:大结果存磁盘
单个结果超限
一个工具的执行结果超过 50,000 个字符(约 12,500 token)时,系统不会把完整内容塞进对话历史,而是做两件事:
- 完整结果写到磁盘上的一个文件
- 对话历史里只放一个预览加文件路径
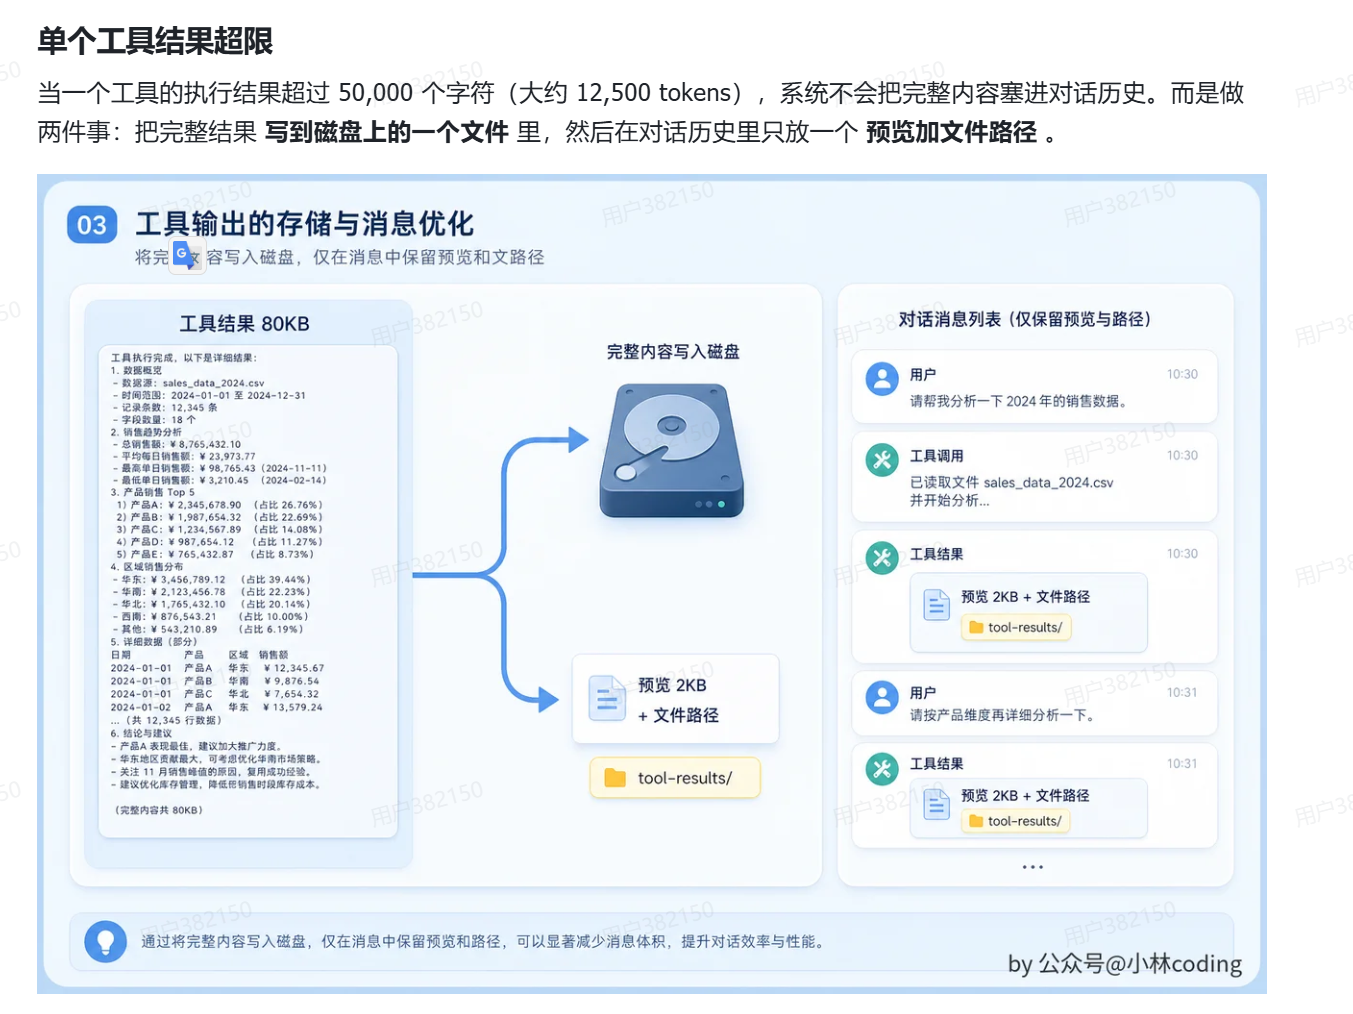
模型看到的实际内容长这样:
1 | <persisted-output> |
这个设计好在信息没有丢——只是从上下文里挪到了磁盘上。模型看到预览觉得有用,可以再去读那个文件;不需要,就白拿一个 2K 的摘要。
代价几乎为零:不花 API 调用,不花时间。
聚合限制:单条没超,合起来超了
光管单个结果还不够。想一个场景:一轮里模型并行调了 10 个工具,每个结果都是 40K 字符——单个都没超 50K 阈值,但合起来是 400K。
所以除了单个工具的上限,还有一条每条消息的聚合限制:200K 字符。超了就把最大的那些存盘,直到总量降到预算以内。
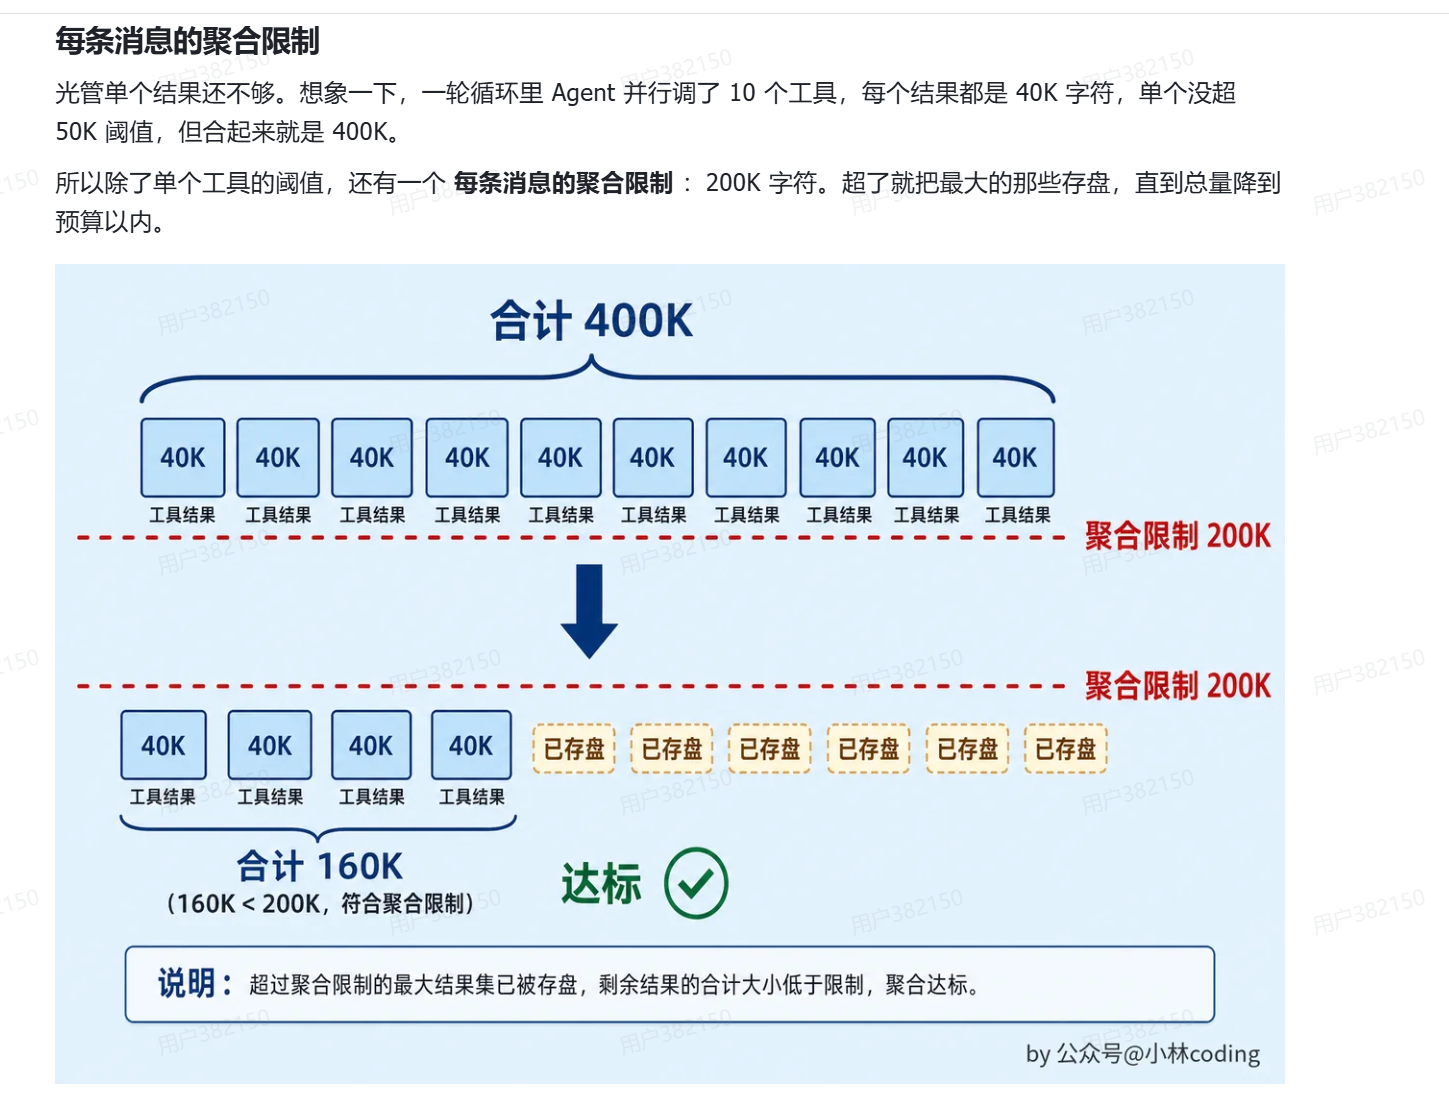
上图里 10 × 40K = 400K,把最大的 6 个存盘,剩下 4 × 40K = 160K,达标。
注意挑的是”最大的那些”——同样的压缩收益,挑大的能少存几个,留下更多完整内容。
为什么阈值是字符数,不是 token
因为字符数是本地能立刻算出来的,token 数不是。
你要精确知道 token 数,得调用供应商的计数接口(多一次往返),或者本地跑分词器(依赖具体模型,还会有偏差)。而工具结果的裁剪是每轮、每个结果都要做的判断——不能每次都去问。
用字符数做近似,用一个宽松的阈值吸收误差,这是工程上的取舍。 精确的那部分留给第 2 层(它的阈值是 token 数,因为它本来就要多花一次调用)。
3. 决策冻结:替换过一次,就不能反悔
这一节是整个上下文管理里最反直觉的部分。
假设第 1 层发现总量超了,要挑几个工具结果存盘。最自然的想法是”每轮重新评估一遍所有结果,挑最该替换的”。
这个想法会直接毁掉 prompt cache。
为什么
LLM 请求与流式响应 里说过:提示词缓存要求前缀完全稳定,改一个字整段缓存就失效。
而工具结果在 messages 里的位置是靠前的——它是历史的一部分。所以:
- 如果第 3 轮把 X 换了,第 4 轮又不换 X 了,X 那个位置的内容变了,从那里往后的整条前缀全部失效
- 前缀一变,缓存不命中,每一轮都在为重复处理前缀买单
所以正确的做法是:决策一旦做出,就冻结。
三类结果,三种待遇
系统维护一个 ContentReplacementState,记录每个 tool_use_id 的替换决策。每一轮面对工具结果时,把它们分成三类:
1 | 已替换过的 → 用缓存的预览字符串原样重放,不重新生成 |
规则就一句话:一旦某个工具结果在某一轮被决定「不替换」,这个决定在整个会话内永远不变——即使后来按聚合限制它应该被替换,也不替换。反过来,如果决定了「替换」,那每一轮都用完全一样的预览字符串去替换,确保前缀逐字节不变。
三轮推演
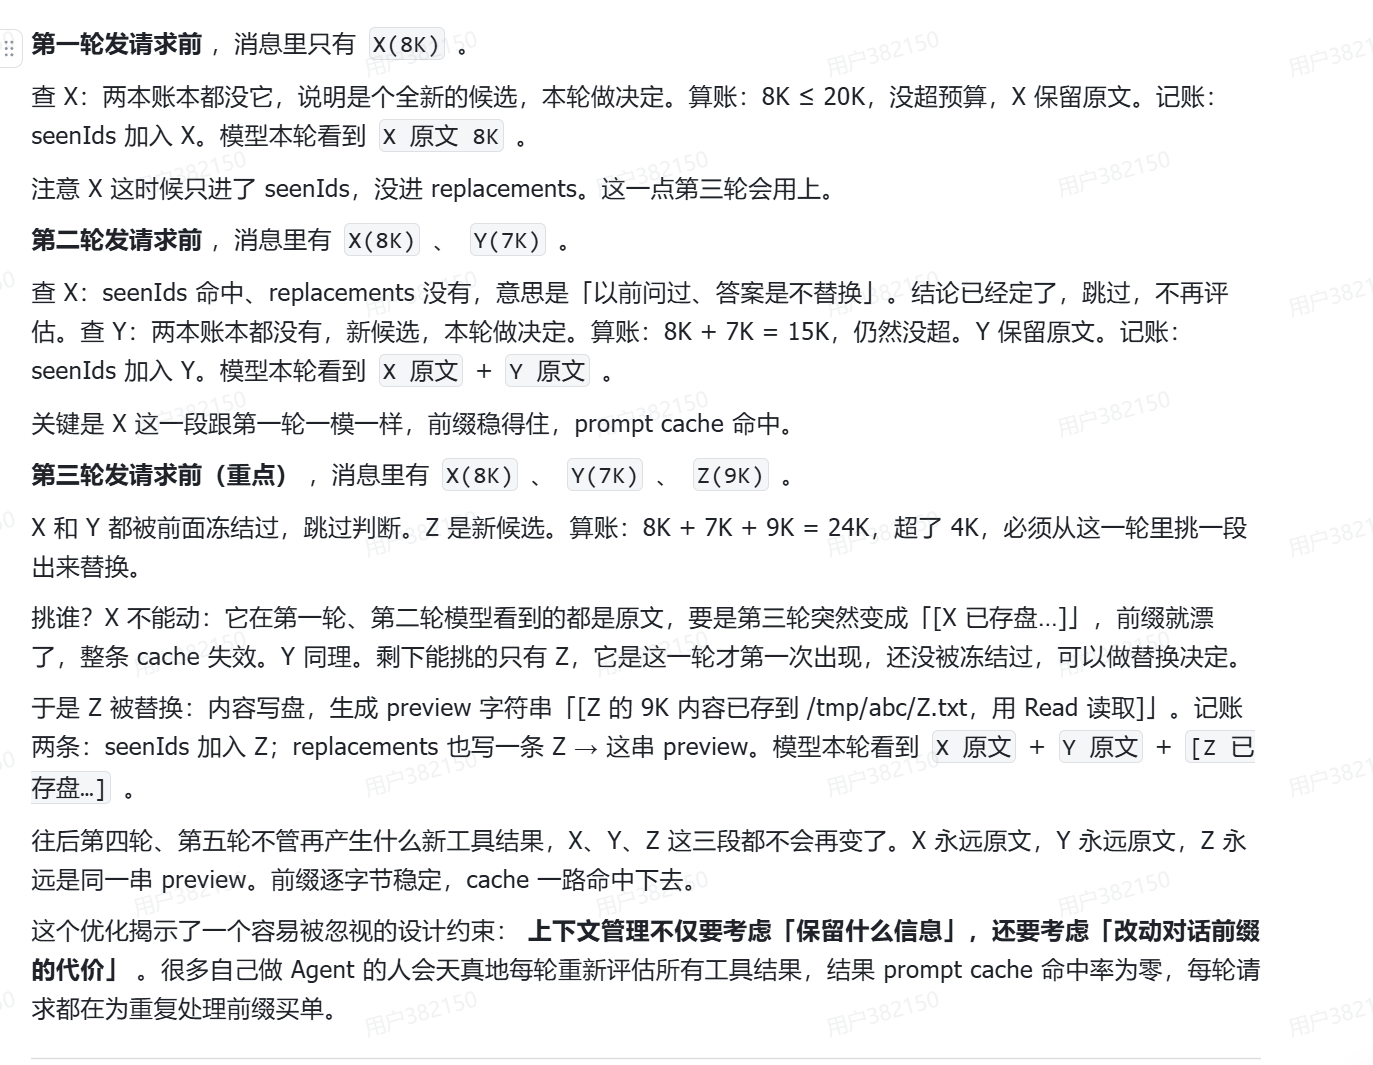
看一个具体的例子。预算假设是 20K,消息里依次出现 X(8K)、Y(7K)、Z(9K):
| 轮次 | 消息 | 账 | 决定 |
|---|---|---|---|
| 第 1 轮 | X(8K) | 8K ≤ 20K | X 保留原文,冻结 |
| 第 2 轮 | X(8K) + Y(7K) | 15K ≤ 20K | X 已冻结,跳过;Y 保留原文,冻结 |
| 第 3 轮 | X(8K) + Y(7K) + Z(9K) | 24K > 20K | X、Y 已冻结不能动,只能挑 Z |
第三轮是关键:账算不过了,必须挑一个替换——但能挑的只有 Z。X 在第 1、2 轮模型看到的都是原文,第三轮突然变成”已存盘”,前缀就漂了,整条缓存失效。Z 是这一轮才第一次出现、还没被冻结过的,可以决定。
于是 Z 被替换,模型这一轮看到的是:
1 | X 原文 + Y 原文 + [Z 已存盘...] |
往后的第四轮、第五轮不管再产生什么新结果,X、Y、Z 这三段都不会再变了。X 永远原文,Y 永远原文,Z 永远是同一串 preview。前缀逐字节稳定,缓存一路命中下去。
由此得到的那条约束
这个优化揭示了一个容易被忽视的设计约束:
上下文管理不仅要考虑「保留什么信息」,还要考虑「改动对话前缀的代价」。
很多自己写 Agent 的人会天真地每轮重新评估所有工具结果——逻辑上更优,实际上 prompt cache 命中率为零,每轮请求都在为重复处理前缀买单。
这和第 5 节那条”历史一旦写进去,就当它不可变”是同一个约束的两个面:一个在说 thinking 块的签名,一个在说工具结果的替换。 都在说同一句话——前缀不能动。
4. 第 2 层:全量摘要
第 1 层管的是单条消息。但20 轮对话,每轮都不大,累积下来一样会撞墙。这时候只能动历史本身:调用 LLM 自己来生成一份对话摘要。
阈值是怎么算出来的
摘要本身也要占空间,所以不能等到 200,000 满了才动手:
1 | 上下文窗口 200,000 |
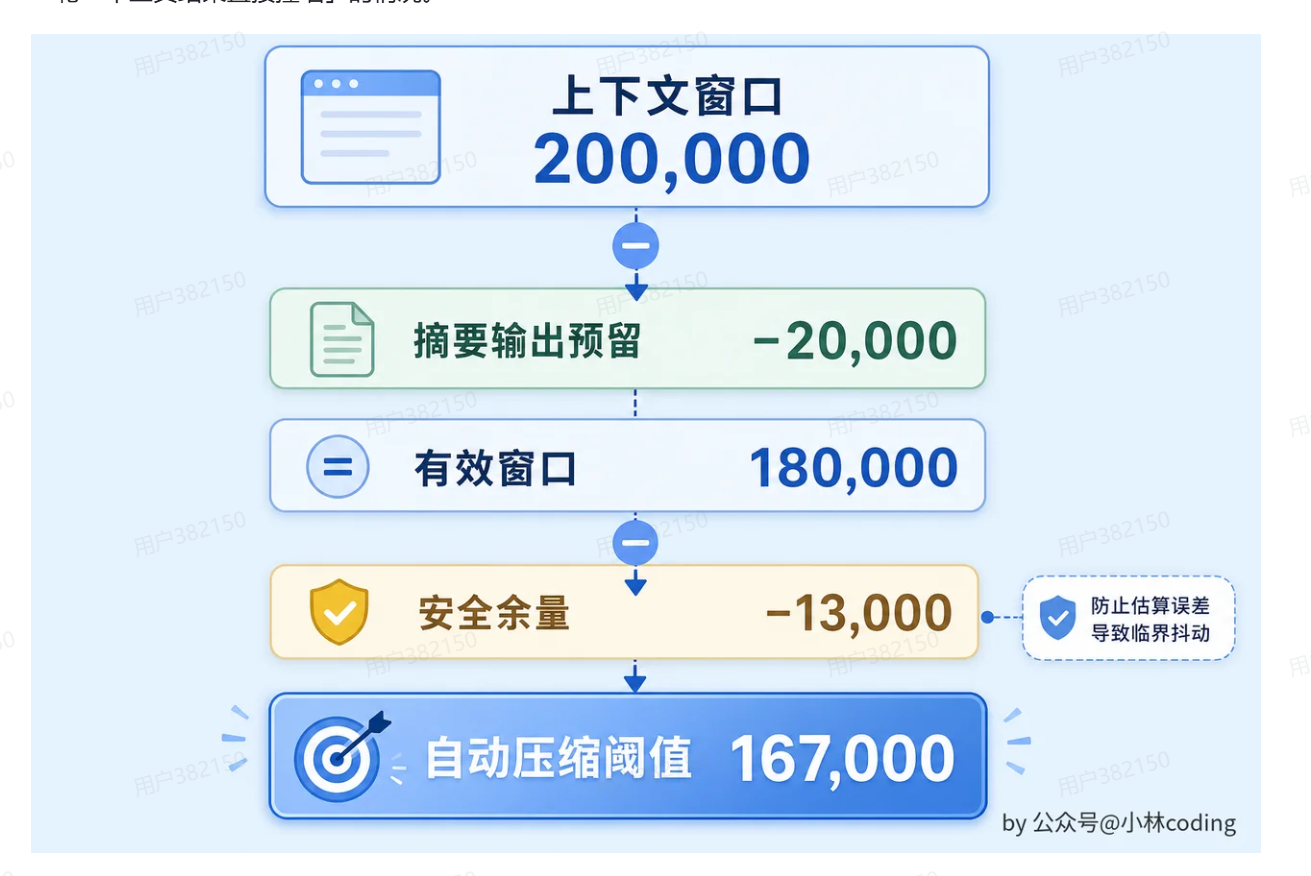
那 13,000 的安全余量值得单独看一眼:token 估算是近似的,如果阈值卡在 180,000,估算偏小的时候就会直接越过硬限制、被 API 拒绝。留一段余量,是为了让”估算误差”这种正常现象不至于变成故障。
摘要 Prompt 的设计:9 个部分
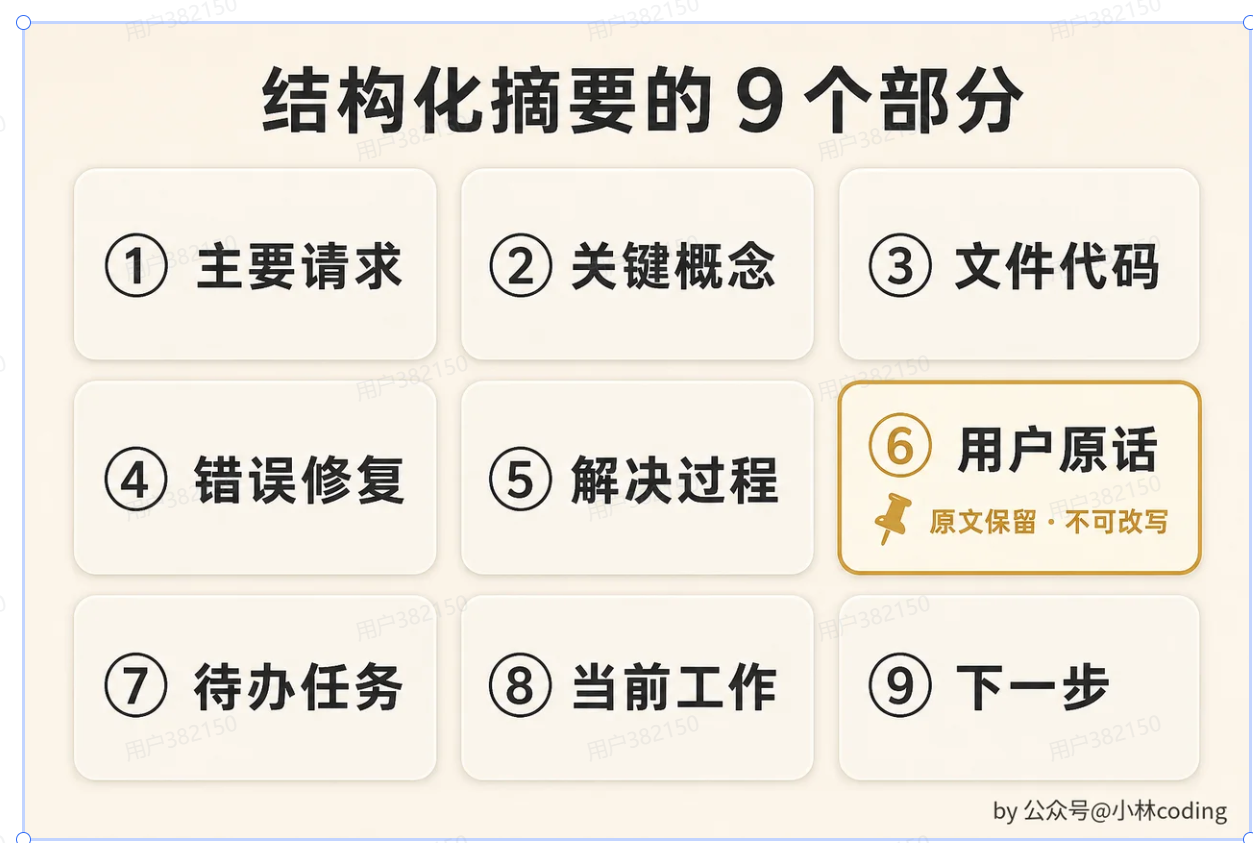
摘要是有固定结构的,不是”帮我总结一下”:
| # | 部分 | 记什么 |
|---|---|---|
| 1 | 主要请求和意图 | 用户到底想做什么 |
| 2 | 关键技术概念 | 讨论过的重要技术点 |
| 3 | 文件和代码段 | 涉及哪些文件,关键代码片段要保留 |
| 4 | 错误和修复 | 遇到了什么错,怎么解决的 |
| 5 | 问题解决过程 | 解决问题的思路和方法 |
| 6 | 所有用户消息 | 用户说过的所有非工具结果的话(原文保留) |
| 7 | 待办任务 | 还没完成的事 |
| 8 | 当前工作 | 最近在做什么(要最详细) |
| 9 | 可能的下一步 | 接下来打算做什么 |
三个设计要点:
一、用户的原始表述必须原文保留,不能摘要改写。 为什么?因为用户的原始表述包含意图、偏好、语气,改写会丢掉这些。 用户说”不要用 interface{},用 any“,你把它摘要成”用户偏好现代语法”——模型下次可能给出 type any = interface{} 这种方向完全反了的东西。摘要是有损压缩,而用户的话是不能有损的那部分。
二、越靠后的越要详细。 第 8 项”当前工作”明确要求最详细,因为那是接下来要接着干的事;而前面几轮的探索过程可以粗。
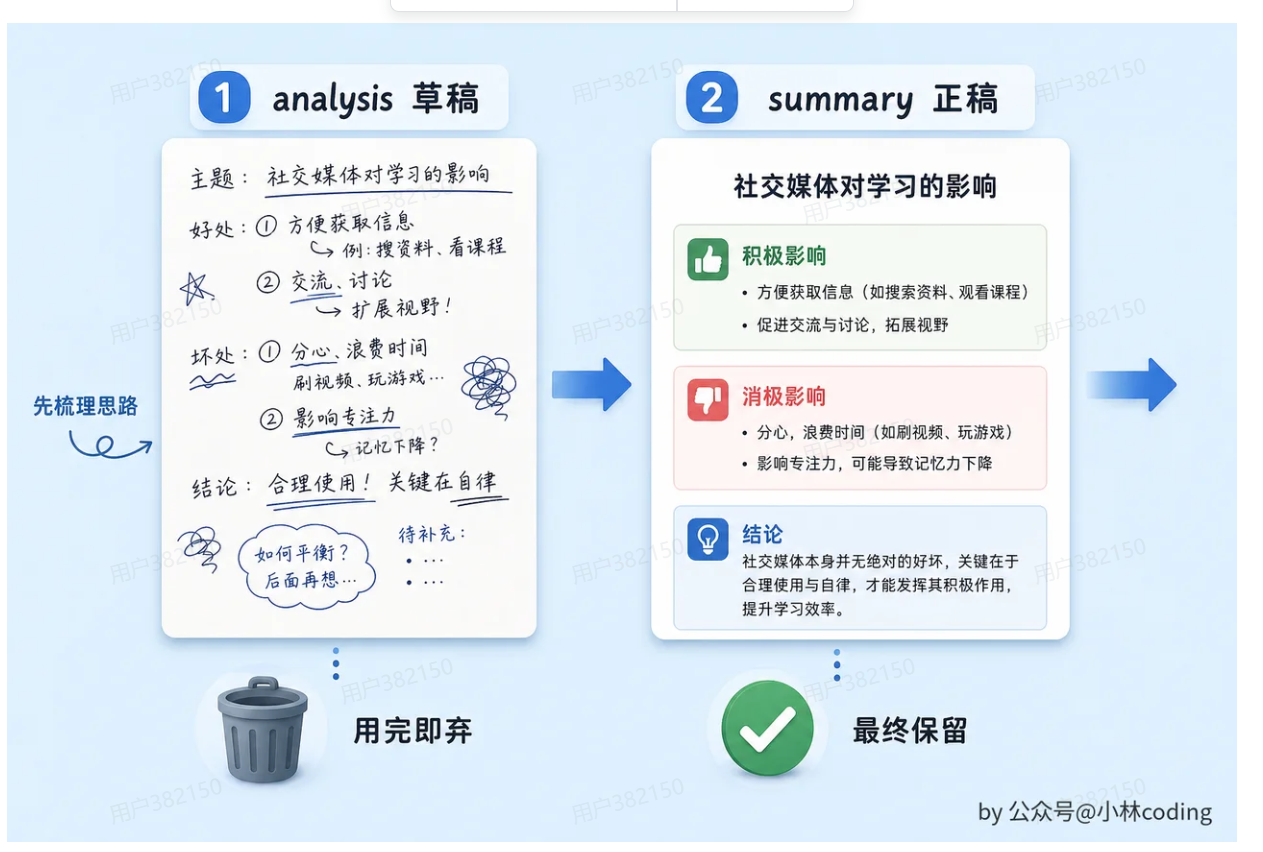
三、先生成草稿,再产出正稿。 压缩分两步走:第一步 analysis 是模型自己的梳理草稿(标出重点、理清思路),第二步 summary 才是最终保留的结构化摘要。草稿用完就丢,不留进上下文。
5. 压缩完不是就完了:恢复
摘要把旧消息替换掉了,但有些关键上下文必须重新附加回来——不然模型醒来以后会缺东西:
| 恢复什么 | 预算 |
|---|---|
| 最近访问的文件 | 最多 5 个,每个最多 5,000 token |
| 技能定义 | 如果之前用过 Skill,重新注入定义,总预算 25,000 token |
| 工具列表 | 重新声明所有可用工具,确保摘要后的首次请求仍带完整工具定义 |
| 压缩边界消息 | 一条特殊消息,见下 |
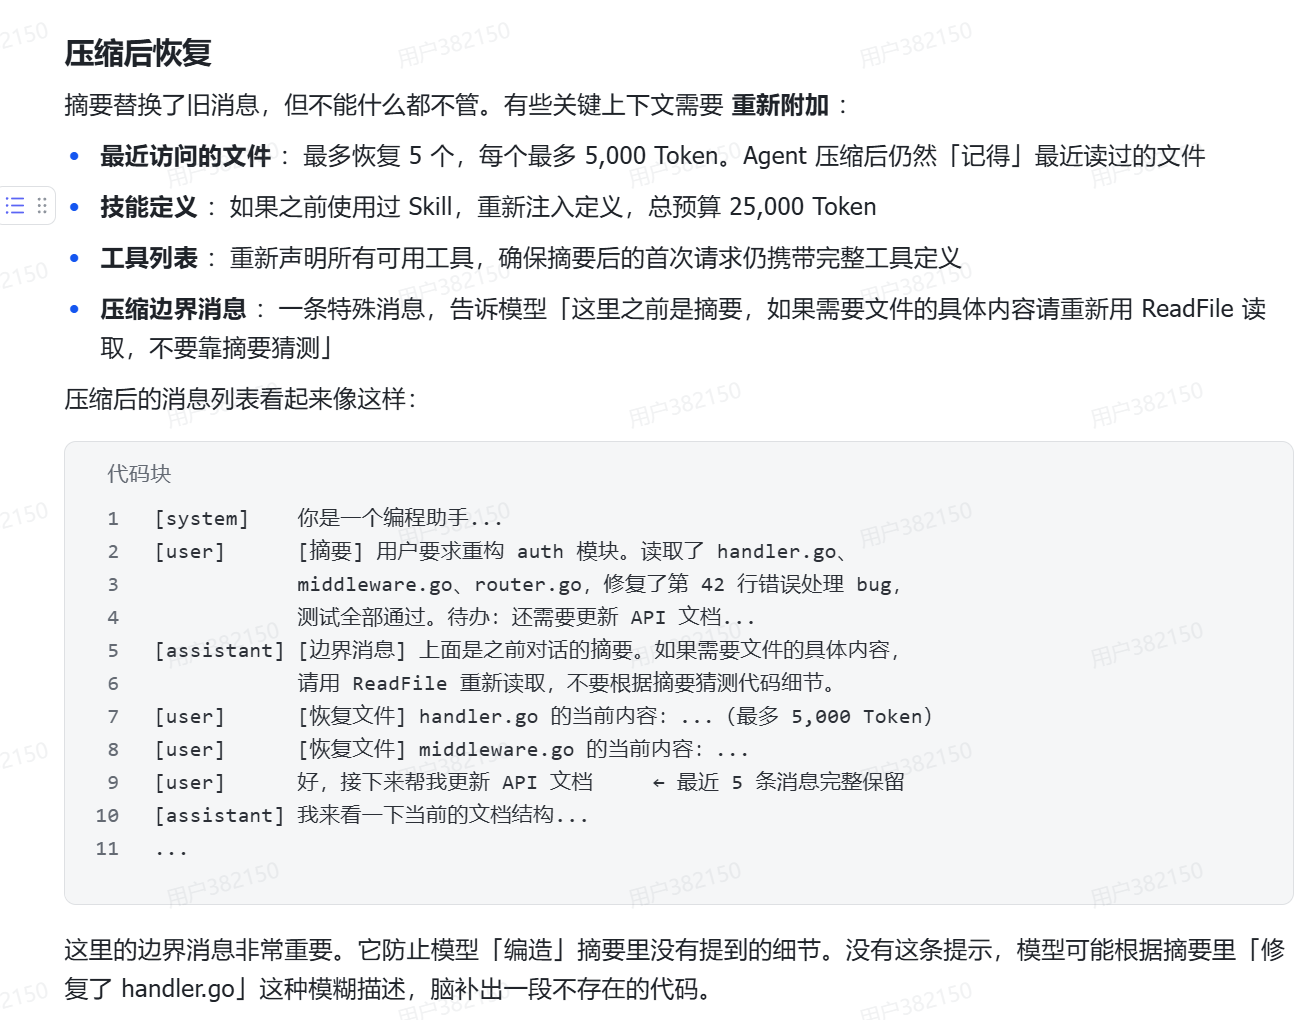
压缩后的消息列表长这样:
1 | 1 [system] 你是一个编程助手... |
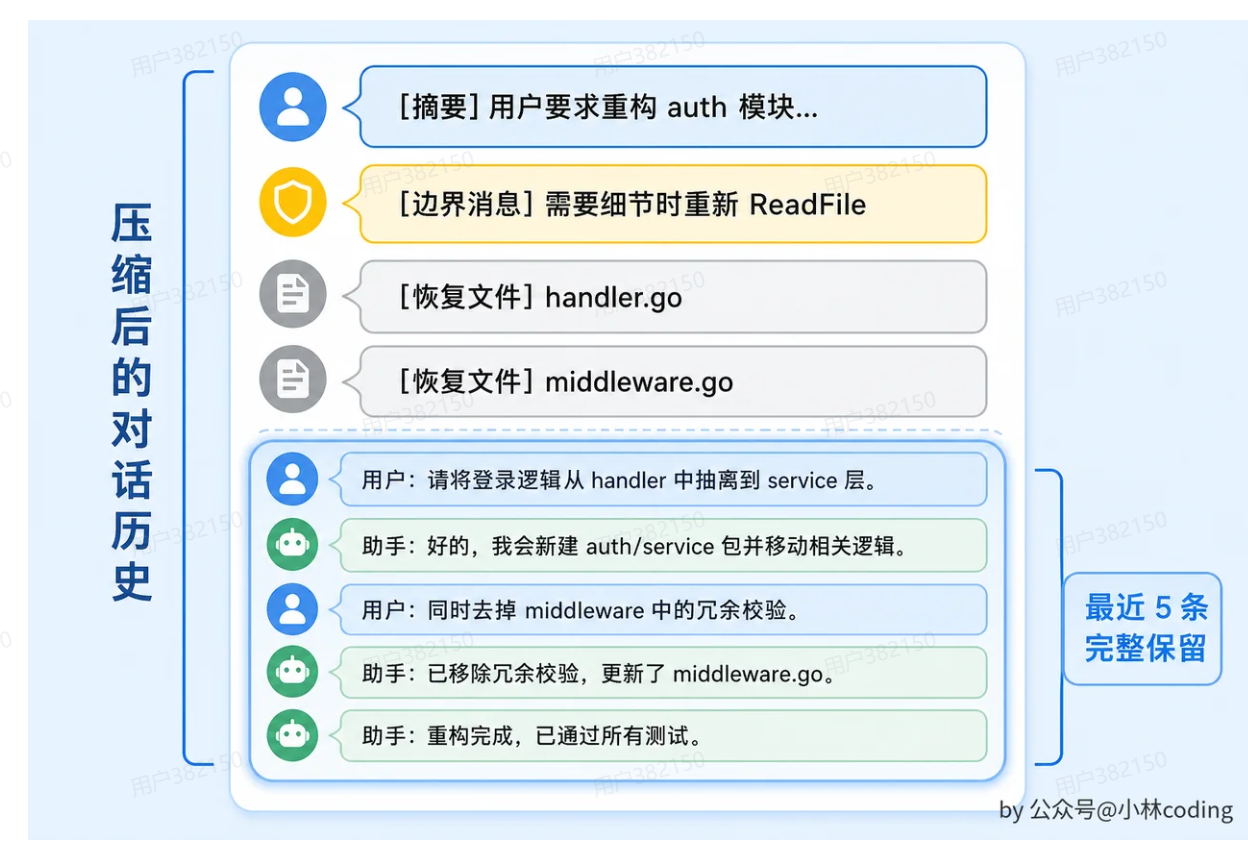
这里的边界消息是最重要的一条,也最容易被漏掉。
它的作用是防止模型”编造”摘要里没有提到的细节。摘要里只会写”修复了 handler.go”,不会有具体代码——没有这条提示,模型可能根据这句模糊描述脑补出一段不存在的代码,然后照着它往下改。
一句话:摘要告诉模型”发生过什么”,边界消息告诉它”细节要重新去拿,不要猜”。
最近 5 条消息完整保留也是同一个道理——刚刚发生的事细节最密集,摘要一定会丢东西,那就干脆不摘要它。
6. 压缩失败了怎么办:熔断器
自动压缩本身就是一次额外的大模型调用,会消耗 token 和时间。而它是有可能失败的:提示词太长、模型拒绝、网络问题、摘要质量差……
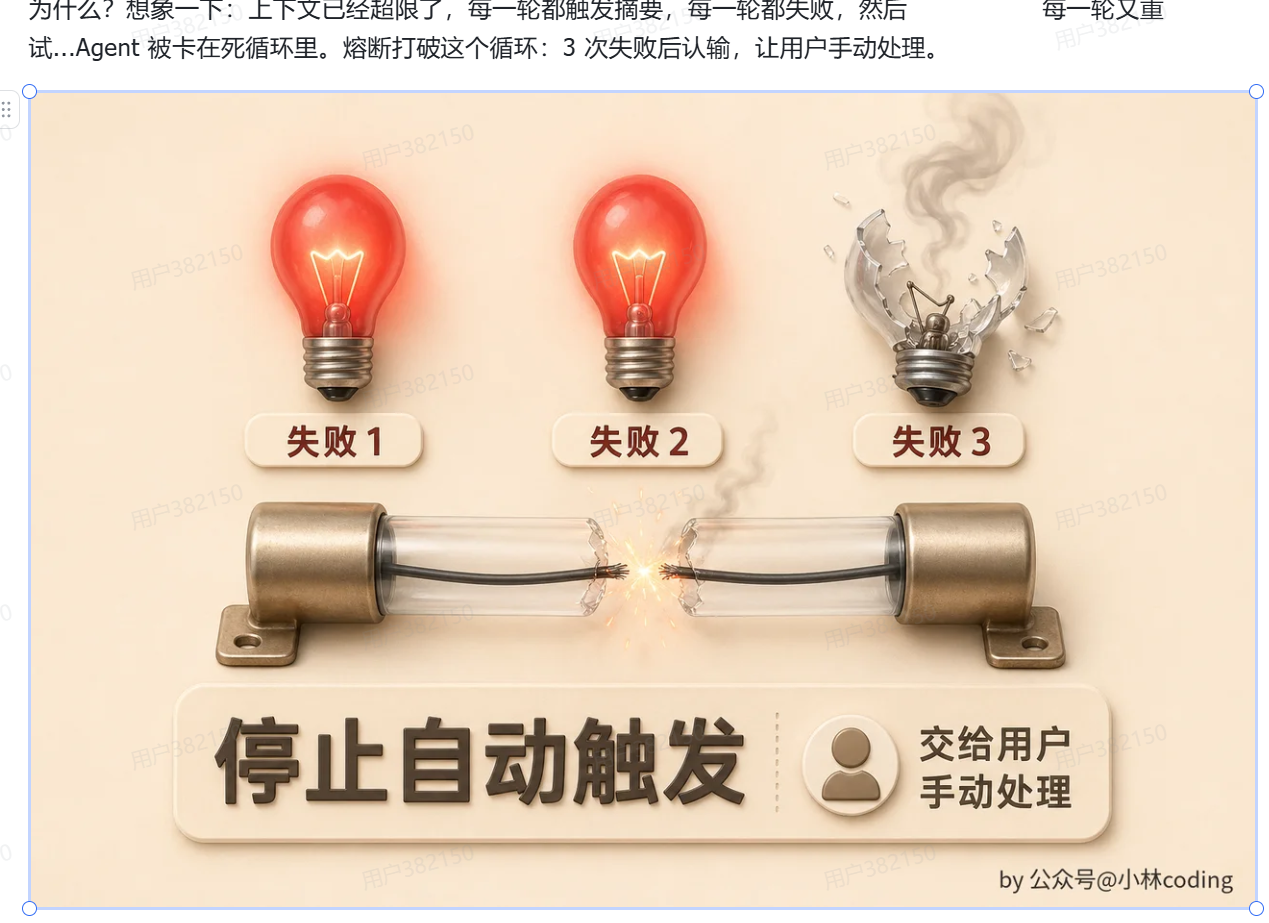
如果压缩一直失败还一直重试,会掉进一个死循环:
上下文已经超限了,每一轮都触发摘要,每一轮都失败,然后每一轮又重试……Agent 被卡在死循环里。
这里用的是一个很常见的容错模式——熔断器(Circuit Breaker):
1 |
|
逻辑就三条:
- 压缩失败一次 → 计数 +1
- 压缩成功一次 → 计数清零
- 连续失败 3 次 → 熔断器打开
打开以后,暂时停止自动压缩,返回提示让用户手动处理(/compact):
1 | # 处于软硬阈值之间时 |
| 状态 | 熔断器行为 | 类比 |
|---|---|---|
| 正常 | 允许自动压缩 | 电路正常通电 |
| 连续失败 3 次 | 打开熔断,停止自动压缩 | 跳闸,保护线路 |
| 手动压缩成功 / 强制压缩 | 清零计数 | 重新合闸 |
注意这里有个细节:只有在软阈值和硬阈值之间才会检查熔断器。
一旦超过硬阈值,会强制压缩,无视熔断器——因为再不压就真的要炸了。熔断保护的是”还有余地时别浪费钱”,不是”宁可炸了也不压”。
7. 另外两条路径:紧急压缩和手动压缩
熔断是”压缩自身出问题”时的处理。但还有一条路径要兜:正常的对话请求发出去,API 返回 prompt_too_long 错误。
这说明自动压缩的阈值没挡住。可能是 token 估算偏差太大,也可能某一轮工具结果异常巨大,两次检查之间直接跳过了阈值。不管什么原因,结果是上下文已经超了 API 的硬限制,请求被拒绝。
不处理的话,Agent 就直接报错停工了,用户只能手动 /compact 然后重试。
做法是在 Agent Loop 里捕获这个错误,立刻触发一次 ForceCompact,压缩完用新的消息列表重试原来的请求。 相当于”撞墙了,赶紧压缩,然后再试一次”。如果压缩后仍然超限,就按正常错误流程处理,不再无限重试。
自动压缩是预防,紧急压缩是治疗。 大部分情况下自动压缩能在撞墙前拦住;万一因为估算误差或极端情况漏过去了,紧急压缩兜底,让 Agent 不至于因为一次估算偏差就彻底瘫痪。
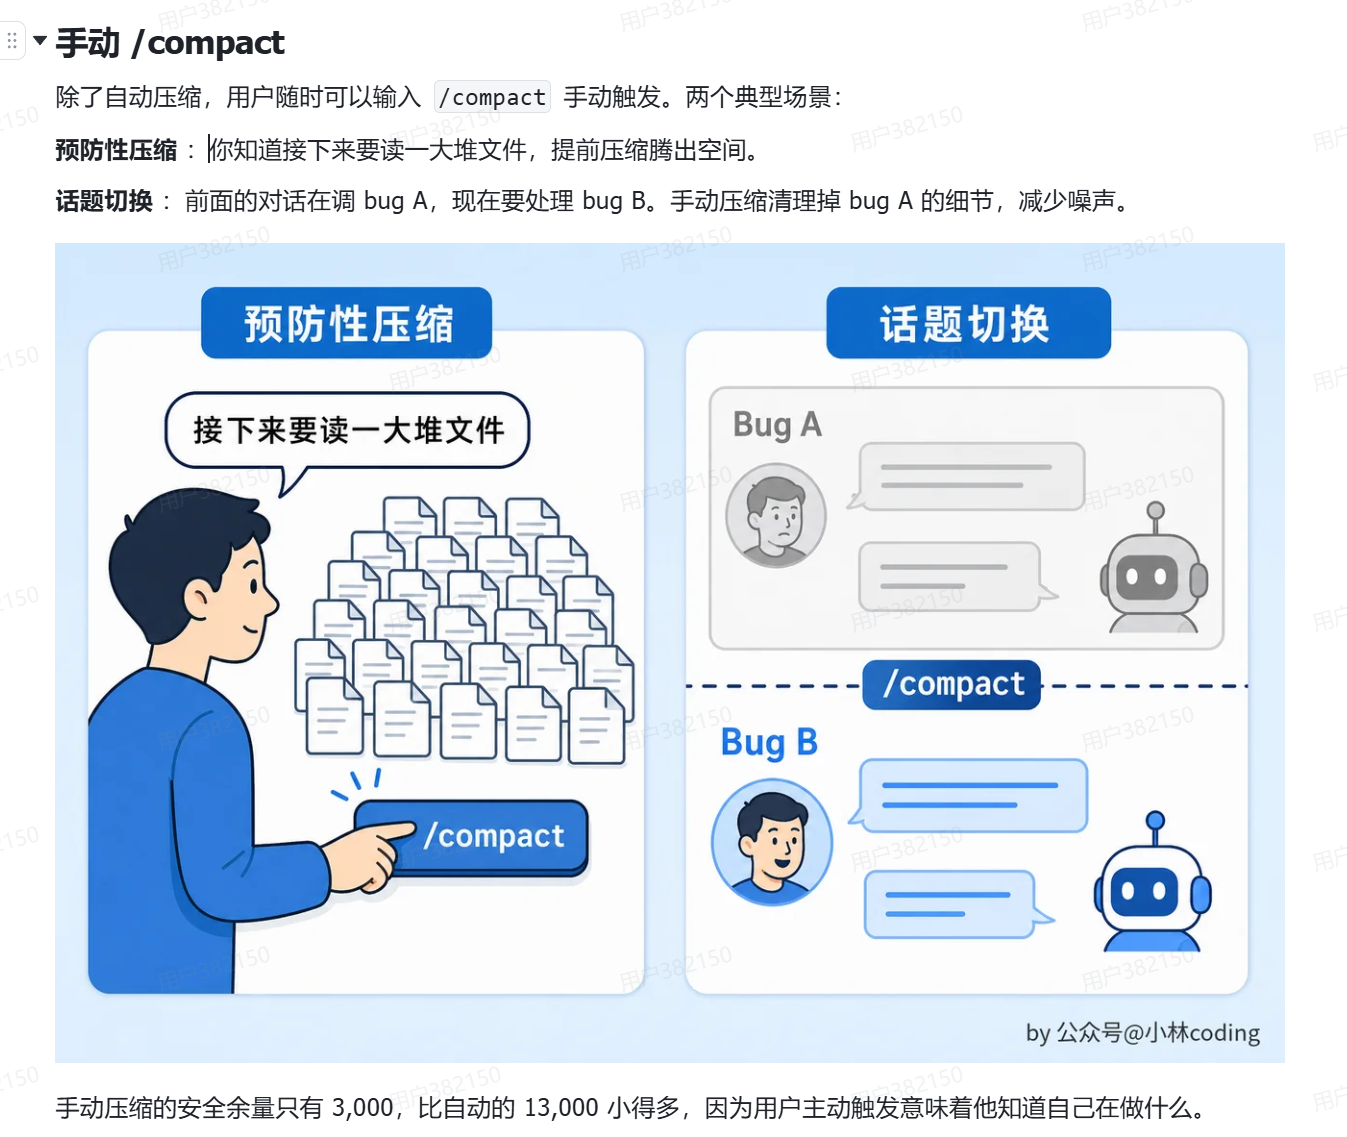
手动 /compact
除了自动压缩,用户随时可以输入 /compact 手动触发。两个典型场景:
- 预防性压缩 —— 你知道接下来要读一大堆文件,提前压缩腾出空间
- 话题切换 —— 前面的对话在调 bug A,现在要处理 bug B。手动压缩清理掉 bug A 的细节,减少噪声
有个数字对比值得注意:手动压缩的安全余量只有 3,000,比自动的 13,000 小得多。 因为用户主动触发意味着他知道自己在做什么——不需要系统替他留那么大一段安全垫。
8. 两层是怎么协作的
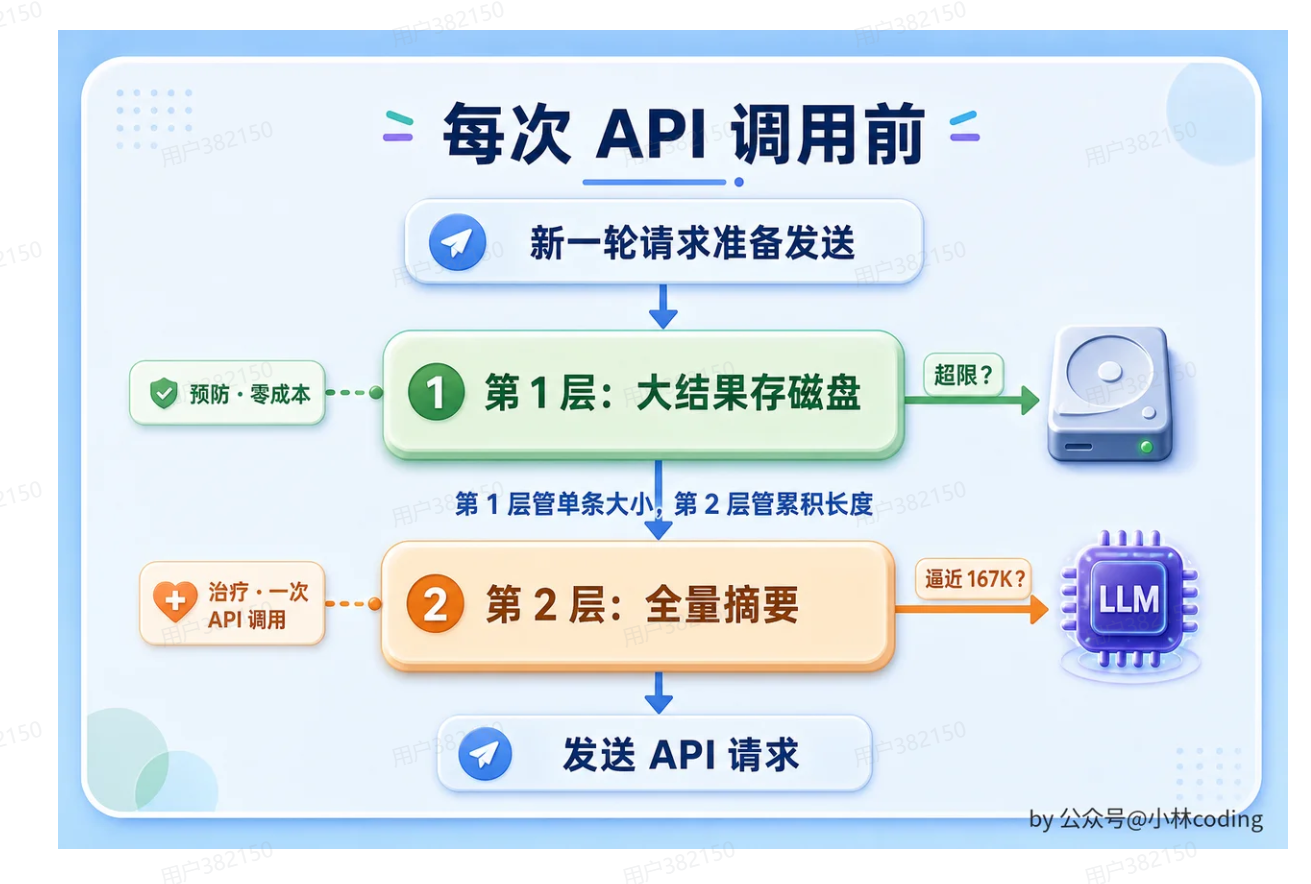
最后把两层串起来。每次调 API 之前,依次做两件事:
1 | 新一轮请求准备发送 |
两个方法的职责边界很清楚:
applyToolResultBudget先执行,检查新产生的工具结果有没有超限。它解决的是”单次工具输出太大”,是一个预防性措施autoCompact紧接着执行,检查整体上下文有没有逼近窗口上限。它解决的是”对话累积过长”,是一个治疗性措施
顺序不能反:
先做便宜的那层。 第 1 层做完以后,总量可能已经降到阈值以下了,第 2 层就完全不用触发——省下一次 LLM 调用。反过来先摘要再存盘,就白白花了一次调用去总结本来要被挪走的内容。
9. 小结
一、两层管两个维度。 第 1 层管单条消息的大小(大结果存磁盘,信息损失近零、API 开销零),第 2 层管对话历史的累积长度(全量摘要,信息损失高、要花一次调用)。能轻则轻,先便宜的后贵的。
二、第 1 层有两个阈值:单个结果 50,000 字符,每条消息聚合 200,000 字符。用字符数是因为它是本地能立刻算出来的——token 数不是。
三、替换决策必须冻结。 一旦决定”不替换”就永远不反悔,一旦决定”替换”就每轮原样重放同一串 preview。每轮重新评估逻辑上更优,实际上会让 prompt cache 命中率归零。 上下文管理不仅要考虑”保留什么信息”,还要考虑「改动对话前缀的代价」。
四、摘要是结构化的 9 个部分,其中用户的原始表述必须原文保留——摘要是有损压缩,而用户的话是不能有损的那部分。压缩完还要恢复最近的文件、技能定义、工具列表,以及那条最容易被漏掉的边界消息(”细节请重新读,不要根据摘要猜”)。
五、压缩会失败,所以要熔断。 连续失败 3 次就停下,交给用户——但在硬阈值之上会无视熔断强制压缩。除此之外还有两条兜底:捕获 prompt_too_long 后紧急压缩重试,以及用户手动 /compact。
六、顺序是先便宜后贵。 第 1 层跑完可能就不用第 2 层了——这就是”能轻则轻”在代码里的样子。
参考
- 提示词缓存(
cache_control,前缀必须稳定):https://platform.claude.com/docs/en/build-with-claude/prompt-caching - 上一篇:Function Calling —— https://wywzixin.github.io/agent/function-calling/
- ReAct 与 Agent Loop(上下文为什么是平方级增长):https://wywzixin.github.io/agent/react-agent-loop/
- LLM 请求与流式响应 —— https://wywzixin.github.io/agent/llm-request-streaming/
- MCP 协议与工具接入 —— https://wywzixin.github.io/agent/mcp-protocol/
上下文压缩与 Token 管理