Agent 记忆系统
Agent 的记忆分两层:工作记忆是上下文窗口,只活在当前会话里;长期记忆落在磁盘上,跨会话有效。
长期记忆有三种形态,区别在于谁写的:
| 形态 | 是什么 | 谁写的 |
|---|---|---|
| 项目指令文件 | 预先写好的项目知识和编码规范 | 人,写一次 |
| 会话持久化 | 每一轮对话的原始记录 | 系统,自动追加 |
| 自动记忆 | 从对话里提炼出的偏好、纠正、项目事实 | Agent 自己,边用边攒 |
三种形态最后都变成一段文本,走同一条管线注入到请求里。它们不是三个独立的功能,是同一件事的三个来源。
上一篇讲的是上下文窗口装不下怎么办(上下文压缩与 Token 管理)。这一篇讲另一半:什么东西不该只活在窗口里。
1. 两层记忆,三种长期形态
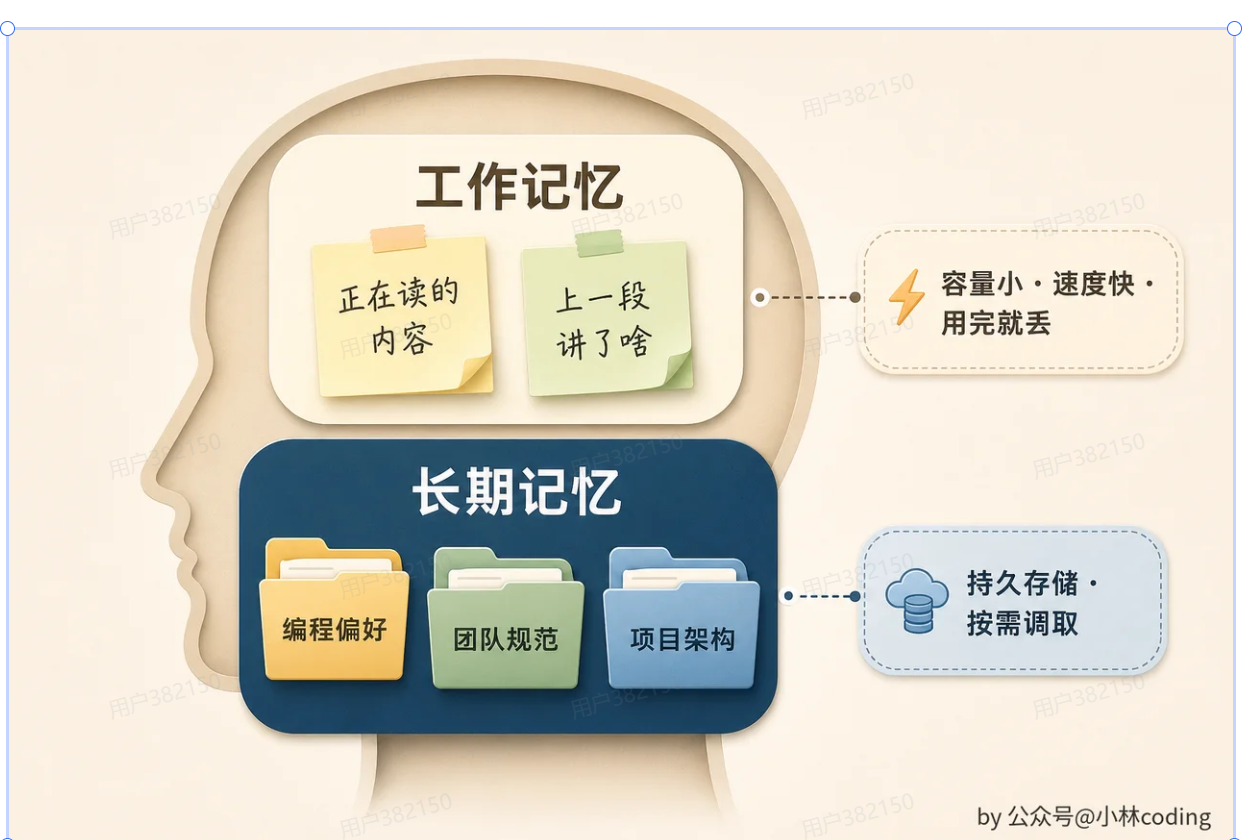
工作记忆就是上下文窗口。 那个 200K token 的空间是 Agent 的「大脑带宽」,当前正在处理的信息全在这里——容量小、速度快、用完就丢。它的生命周期就是一个会话,进程一退,里面什么都没了。
长期记忆对应的是所有持久化到磁盘上的信息。 这一层不随进程退出而消失,按内容性质分,它有三副面孔:
- 会话持久化 —— 你跟 Agent 的每次对话都存下来,下次可以恢复。就像第二天早上打开电脑看到昨天的聊天记录,上下文立刻回来了。
- 项目指令文件 —— 预先写好的项目知识和编码规范,相当于员工的「入职文档」,启动就读。
- 自动记忆 —— Agent 在对话中自己积累的经验:你的编码偏好、项目的技术细节。
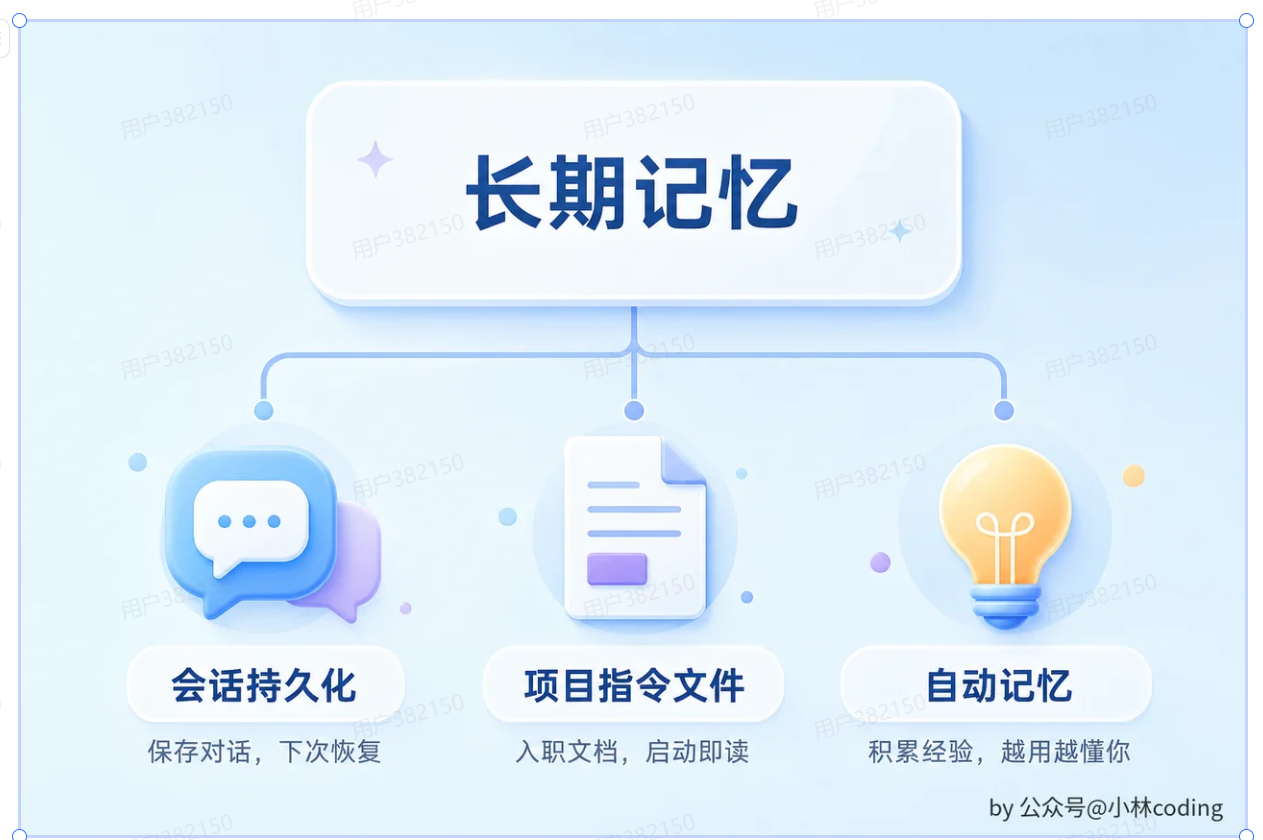
接下来三节分别拆这三种形态。有个共同的观察可以先把话说了:它们解决的是同一类问题的不同侧面——什么信息值得活过一次会话。
2. 项目指令文件:Agent 的入职文档
最直观的一种长期记忆:一份 Markdown,Agent 每次启动都读一遍。
它有三级,按优先级排:
1 | 1. 项目根目录/AGENT.md <- 项目级(最高优先级) |
为什么项目级有两个位置
因为有些内容该共享,有些不该。
有些团队希望 Agent 的指令文件提交到 Git,让所有成员用同一份 Agent 指令——那就放项目根目录,跟着仓库走。而有些开发者写的指令里含有个人特定的内容,不想提交到版本库,就放 .agent/ 目录下,然后把这个目录加进 .gitignore。
两个位置,一种文件,区别只在版本控制里可见不可见。
加载:拼接,不是覆盖
流程很直观:按优先级顺序依次检查每个路径,文件存在就读取,不存在就跳过。所有读到的内容用 --- 分隔线拼成一段完整文本,注入到 messages 里。Agent 在处理用户的实际请求之前,就已经「读完入职文档」了。
这里有个容易想反的点:三级不是「高优先级覆盖低优先级」,而是全部保留、拼在一起。
因为这个设计假设三级管的是不同的东西——用户级装个人偏好(「回复尽量用中文」),项目级装团队规范和项目知识(「部署脚本在 scripts/ 下」)。它们本来就不冲突,硬要覆盖反而会丢掉信息。
用 @include 拆开
一份指令文件写到几百行就该拆了。用一个 @include 指令,把大块知识拆成独立文档:
1 | # AGENT.md |
入口文件只留目录,真内容在各自文档里。好处是结构化、可复用、便于维护——改编码规范只动 coding-style.md。
但它引入了两个新风险:
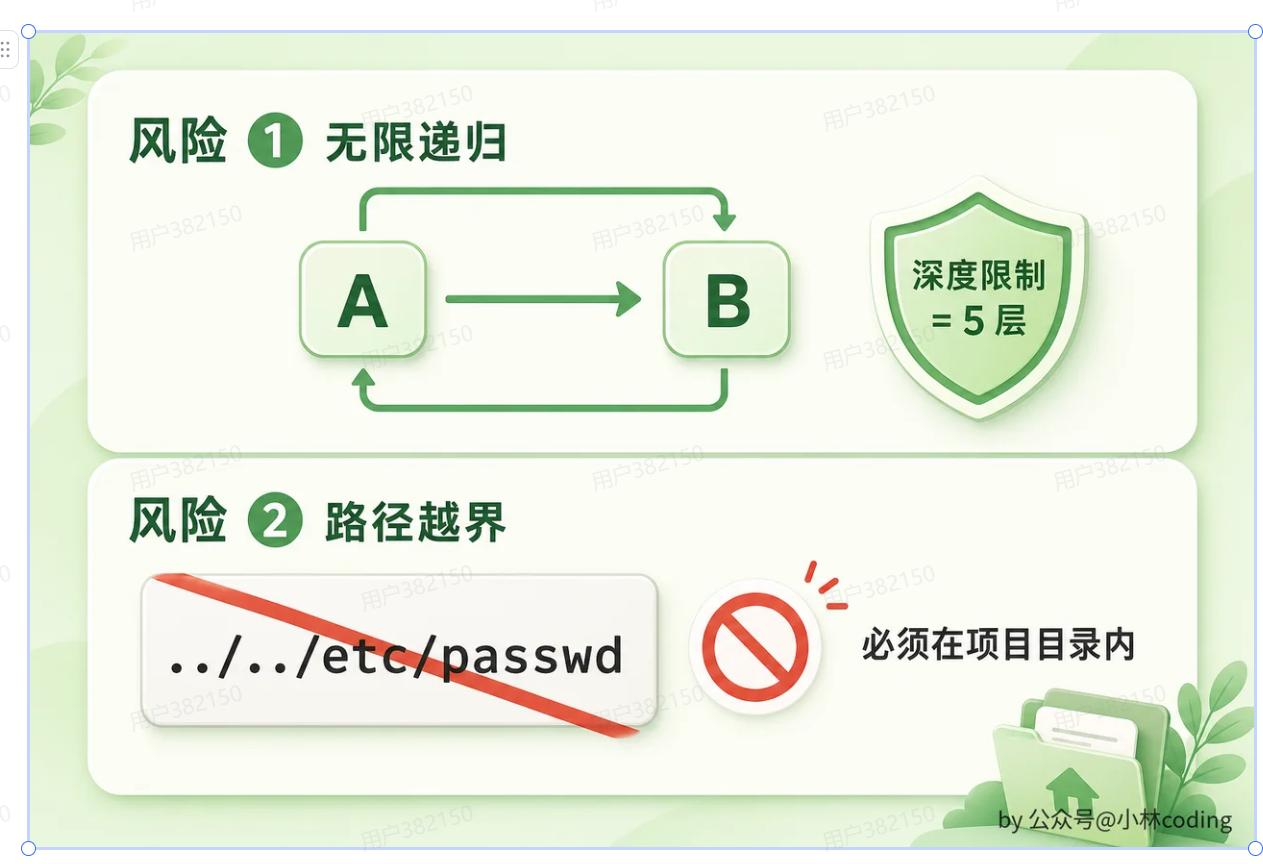
- 无限递归 ——
A.mdincludeB.md,B.md又 includeA.md,解析器就转不出来了。对策很简单:限制深度,5 层封顶。 - 路径越界 ——
@include ../../etc/passwd会把项目外的文件读进上下文。对策是校验:解析出来的路径必须落在项目目录内。
两条都是「展开用户提供的东西」时通用的防御,跟模板引擎、构建工具踩的是同一类坑。
3. 会话持久化:让对话可以「存档读档」
指令文件解决的是预先写好的知识。但还有一类长期记忆是动态产生的:你跟 Agent 的每次对话、每个操作、每个决策,需要在会话结束后存下来,以便恢复。
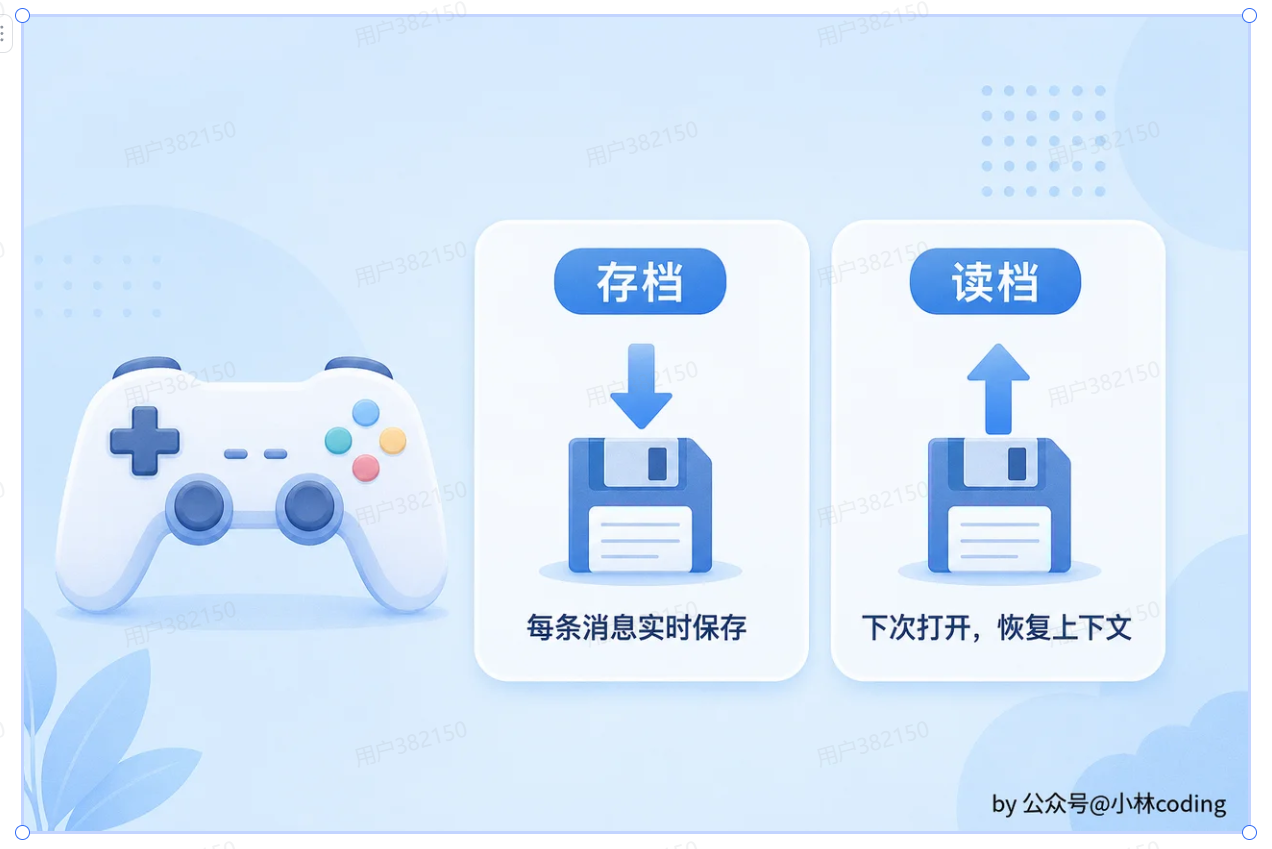
存储格式选了 JSONL(JSON Lines):每行一个 JSON 对象,代表一条消息。
为什么是 JSONL 而不是一个大 JSON
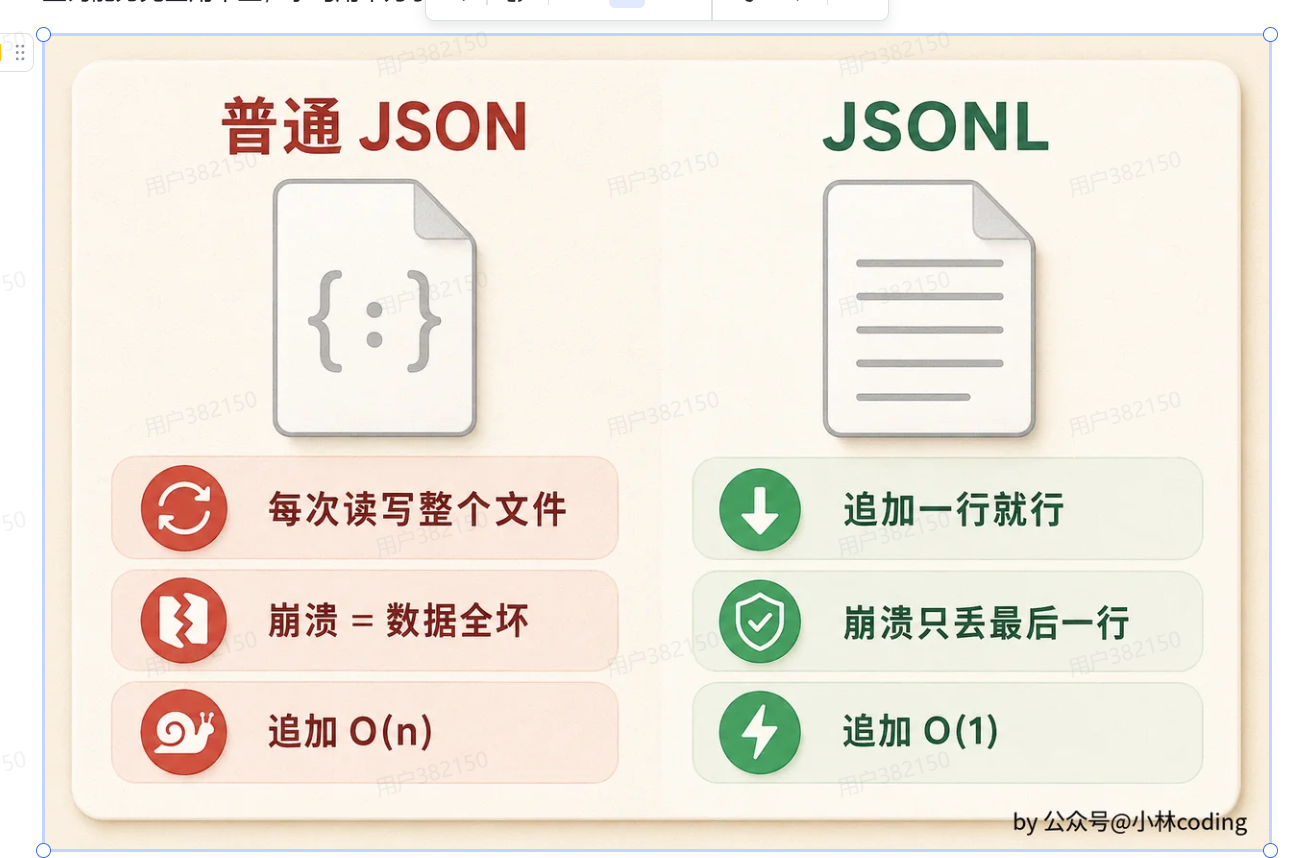
| 普通 JSON | JSONL | |
|---|---|---|
| 写入 | 每次读写整个文件 | 追加一行就行 |
| 崩溃 | 数据全坏(文件本身就是半个 JSON) | 只丢最后一行 |
| 追加复杂度 | O(n) | O(1) |
三条里最关键的是第二条。Agent 是一个长时间运行的进程,被 Ctrl-C、被 OOM killer 杀掉、机器断电,都是常态。用大 JSON 存,一次崩溃就丢掉整个会话历史;用 JSONL 存,最坏情况是丢掉最后一条写得半截的消息。
一条记录长什么样
1 | RecordType = "user" | "assistant" | "tool_result" |
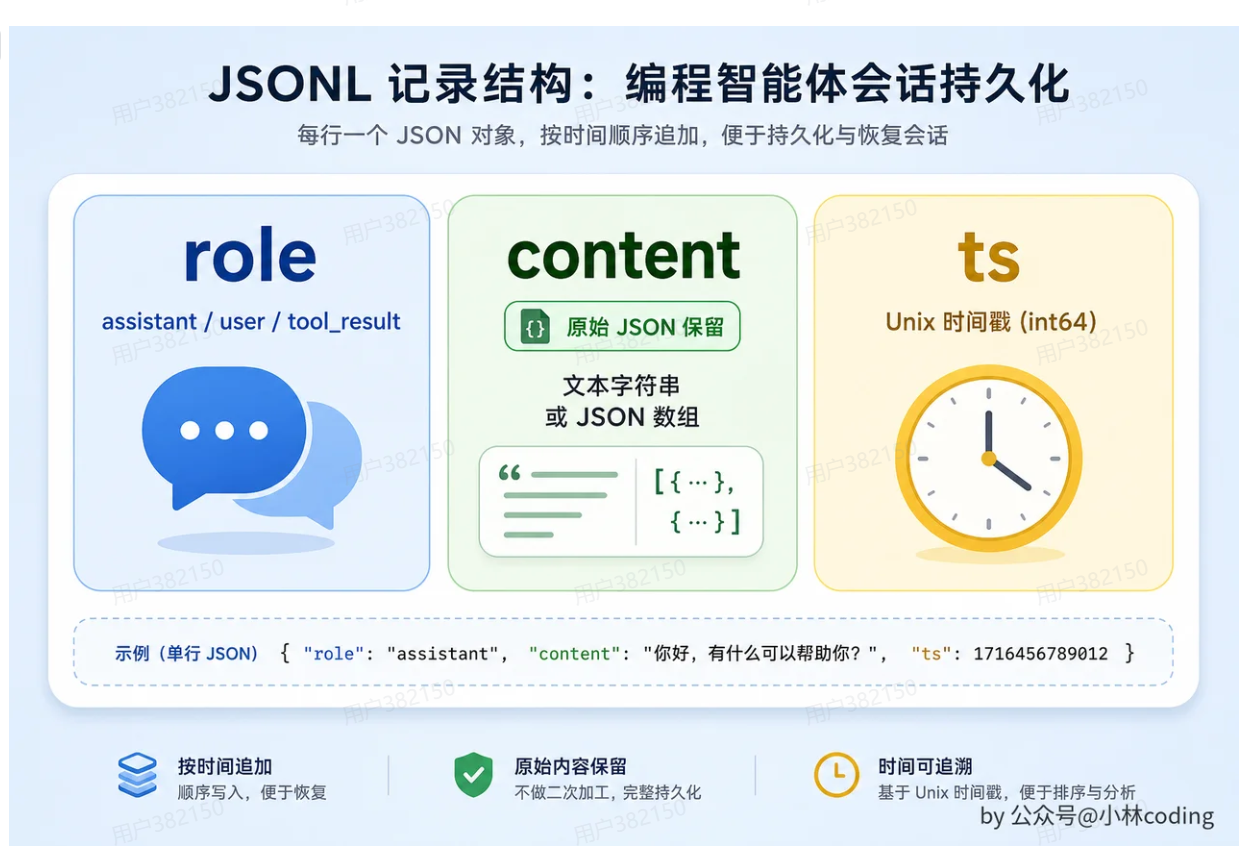
content 那一行的注释值得单独说:保留原始 JSON,不做额外转换。
也就是说,落到盘上的内容跟发给模型的内容是同一个形状,中间不做一层自己的数据模型。好处是恢复的时候不用「反序列化 → 转成内部结构 → 再序列化回去」这一圈——直接把读到的 JSON 拼进 messages 就行,不会因为转换丢字段(比如某个 provider 加了个新字段,或者 tool_use 上的额外元数据)。
代价是存储层完全不知道内容语义,想按内容查询得自己解析。这里不需要,所以划得来。
文件这么放:
1 | .agent/ |
会话 ID 是 YYYYMMDD-HHMMSS-xxxx:前 15 个字符的时间戳让你一眼看出创建时间,末尾 4 个十六进制随机后缀避免同秒冲突。单进程下普通用户几乎用不到后缀,但 CI/CD 那种可能瞬时启动多个会话的场景能保证 ID 不撞车——同秒生成两个会话也会落到不同文件,不会出现多个进程往同一个 .jsonl 里交错写消息。
这里还有一个刻意的省略:没有元信息文件。 那 /session list 怎么快速展示会话列表?直接解析 JSONL。列表需要的信息就两个——会话创建时间(从文件名就能读出来)和最后活跃时间(读文件最后一行的 ts 字段)。JSONL 文件通常不大,逐行扫也足够快,额外维护一个元信息文件带来的复杂度不值得。(这就是上一篇「能轻则轻」的同一套取舍。)
写入顺序:先文件,后内存
每次追加消息时:
1 | function Session.Append(message): |
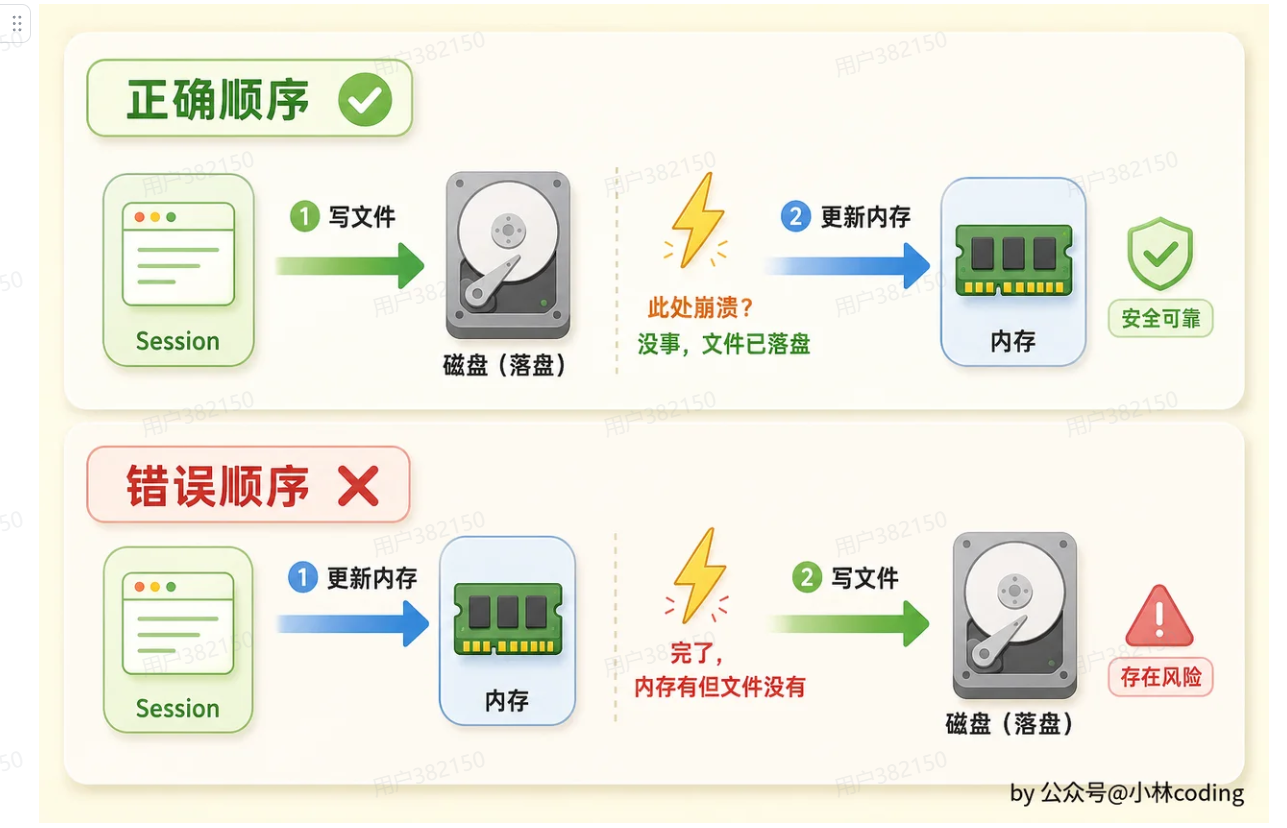
注意这个顺序。 如果写文件成功、更新内存前程序崩了,没关系——下次恢复时会从文件重建内存状态。反过来先更新内存再写文件,崩溃时内存里有、文件里没有的那条消息就永远丢了。
一句话:磁盘是真相,内存只是它的缓存。
恢复不是读回来就完了
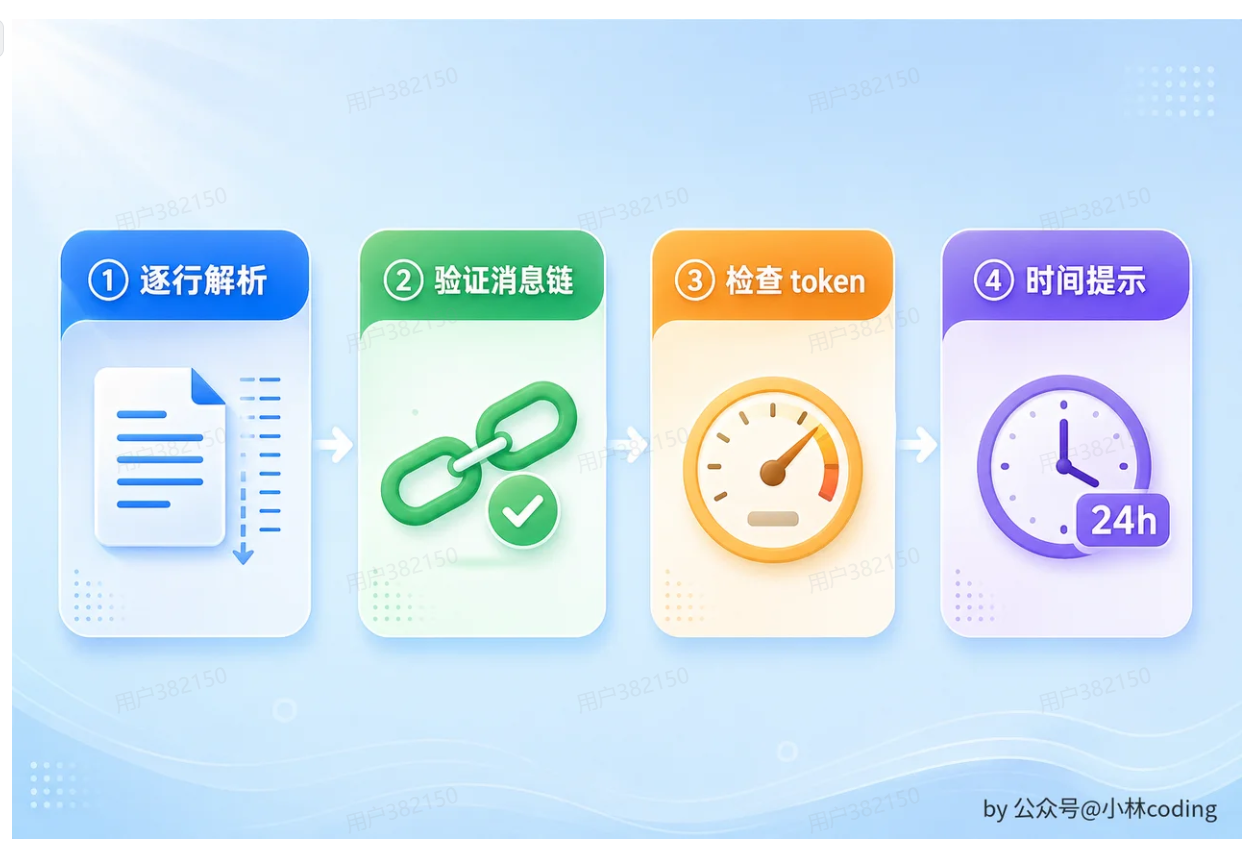
四步走:逐行解析 → 验证消息链 → 检查 token → 时间提示。
第一步,逐行解析,不完整的行直接跳过。
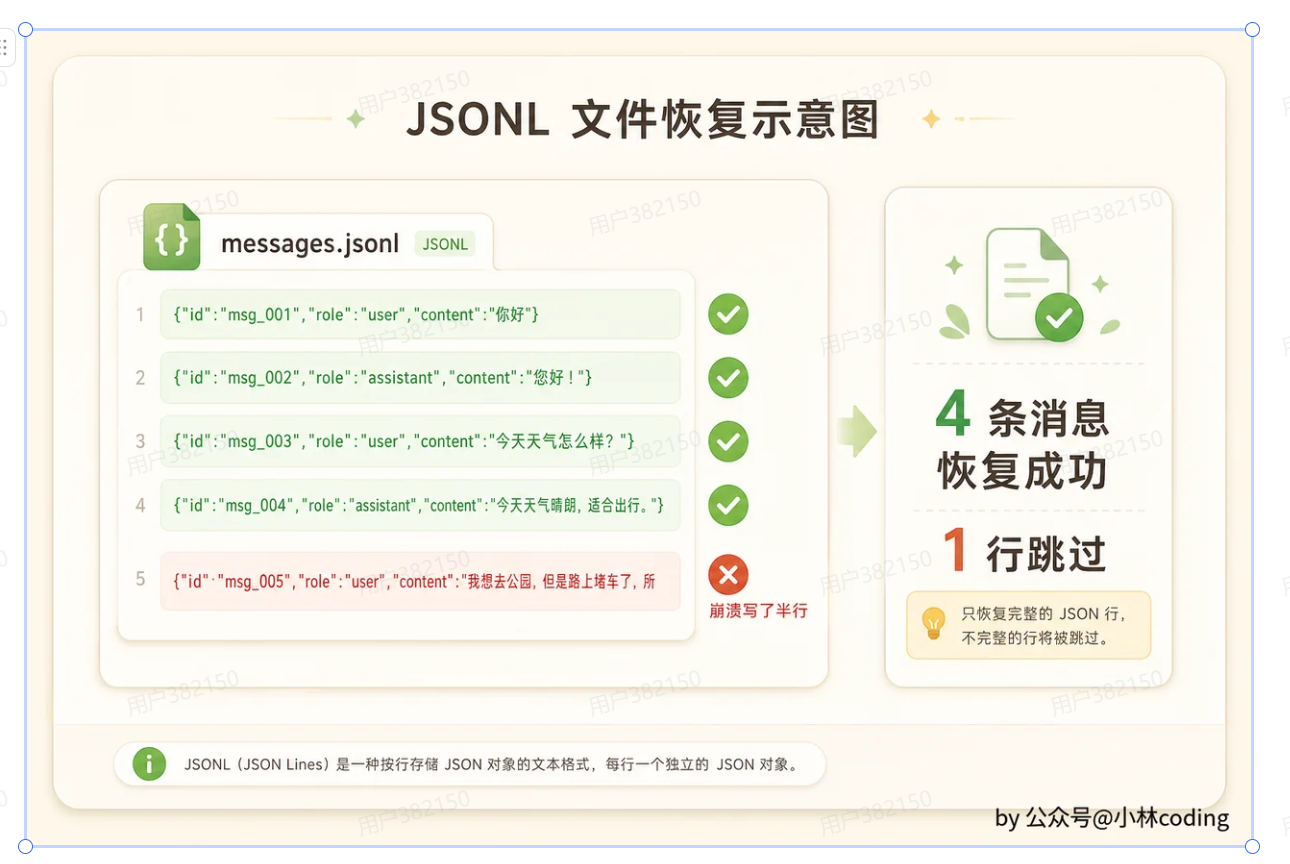
崩溃通常会留下最后一行写了一半的 JSON。这一行解析失败,跳过它,前面的照常恢复。 这正是 JSONL 相对大 JSON 的价值所在——错误被限制在一行之内。
第二步,验证消息链。
这一步容易被忽略。tool_use 必须有一个配对的 tool_result,如果历史里有个 tool_use 后面什么都没有,这段消息发给模型会直接报错——API 要求消息链完整(tool_use / tool_result 的配对规则在 LLM 请求与流式响应 里拆过)。
什么时候会出现这种断裂?工具执行到一半进程被杀、或者崩溃恰好发生在两次追加之间。这时候要么补一条「工具被中断」的 tool_result,要么把这个 tool_use 及其后续一起截掉——总之不能原样发出去。
第三步,检查 token。
恢复出来的历史可能已经超过自动压缩的阈值了(比如会话本来就快到 167,000 才中断的)。所以恢复之后要立刻判断:这份历史需不需要先压一遍再继续? 否则用户一开口撞上的就是 prompt_too_long。
第四步,时间提示。
恢复出来的最后一条消息可能是三天前的。如果原样发过去,模型会把它当成「刚刚发生的事」,接着回答「好的,我这就继续」——它不知道中间隔了三天。
所以在恢复后的上下文里塞一条提示:距上次对话已过去 N 天。 24 小时以内则跳过——那种情况下上下文基本还是连续的,加提示反而多话。
这一步没有任何技术含量,但它是「恢复」和「无缝恢复」之间的差别。
顺手清理
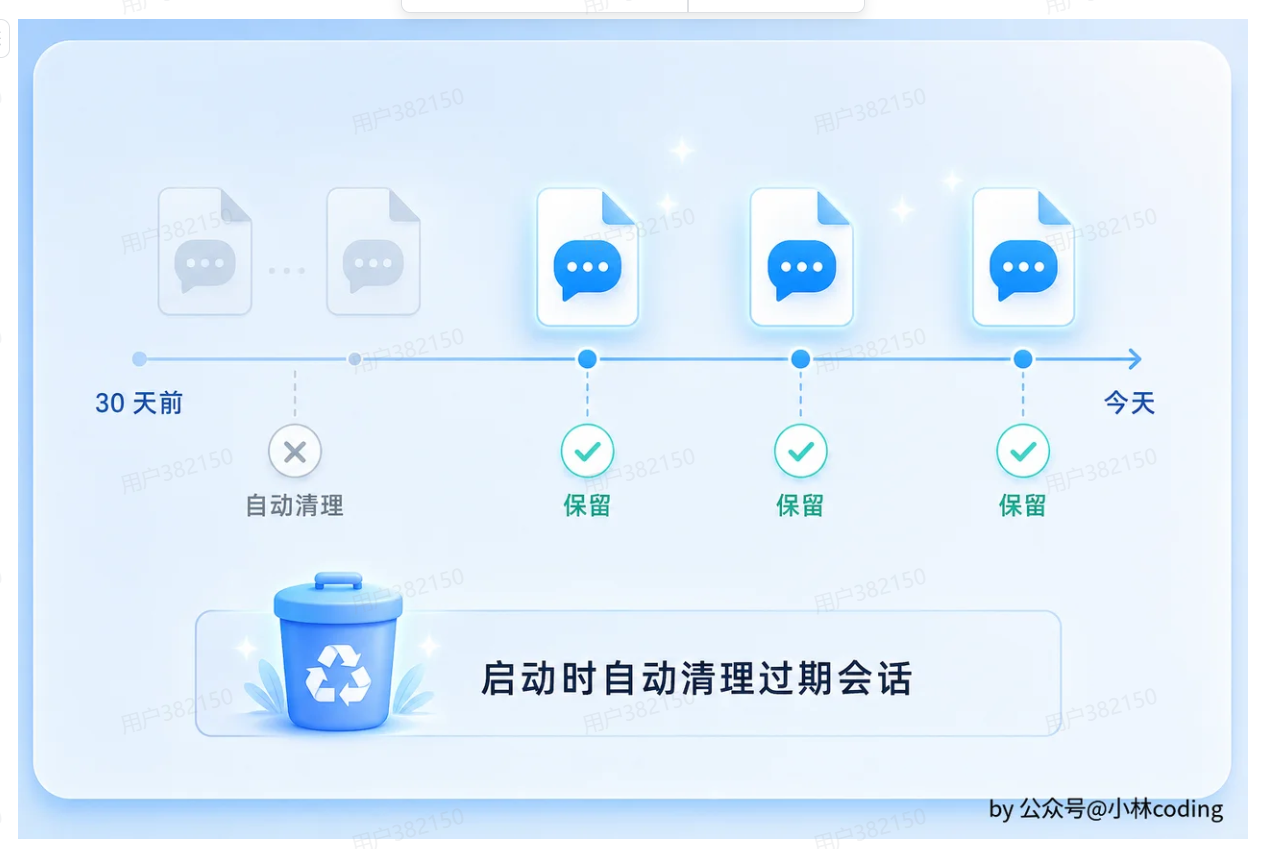
启动时顺手删掉 30 天前的会话文件。会话历史是只增不减的,没有这一步,目录会一直长下去。
4. 自动记忆:让 Agent 自己「记笔记」
前两种记忆,一个靠人预先写,一个靠系统照原样录。它们都缺一样东西:判断。
指令文件是人提前想好的,想不到的就漏了;会话持久化是流水账,它不区分哪条重要哪条不重要。 自动记忆补的正是这一环——让 Agent 在对话过程中自己判断「这句话值得长期记住」,然后记下来。
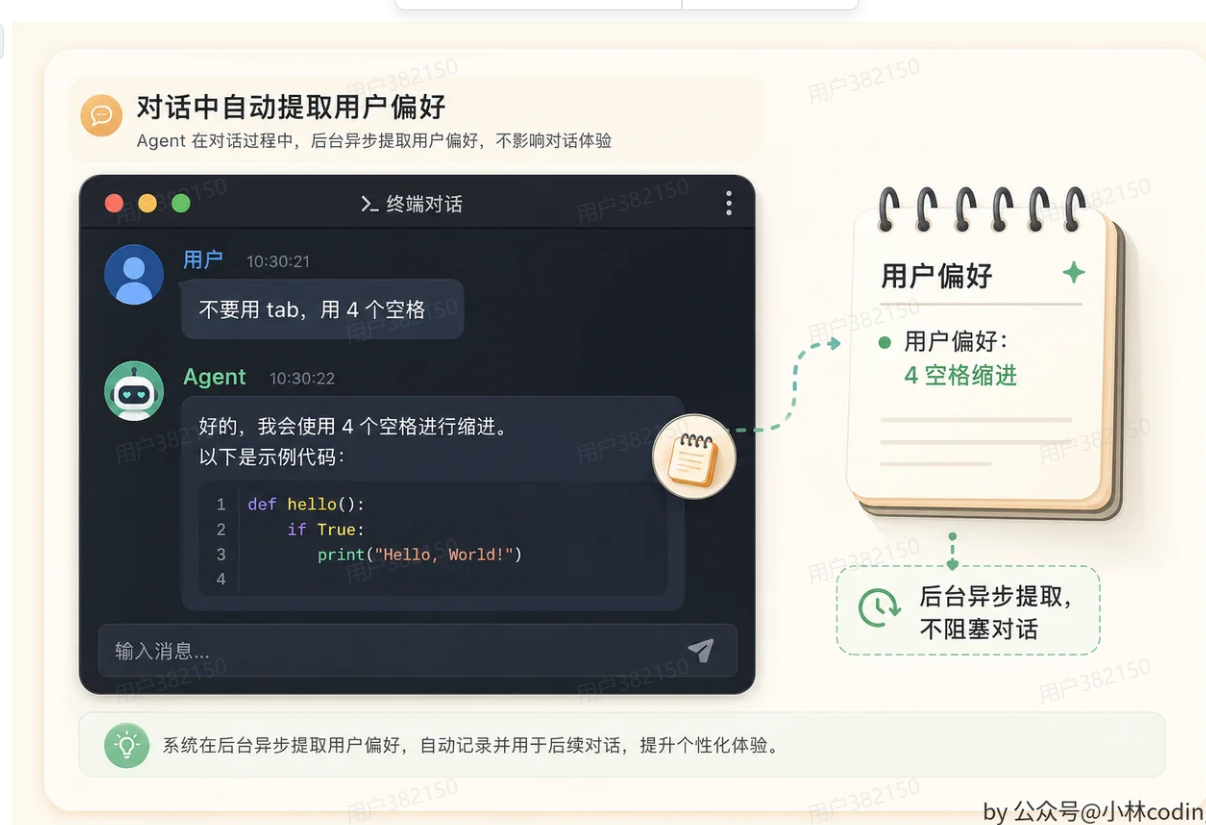
时机:每轮 Agent Loop 结束后
判断放在哪儿跑?答案是模型给出最终回复、不再调用工具的那个时刻——一轮 Agent Loop 结束。
这个点选得有讲究:这一轮已经走完,结论都出来了,提取器看到的是一个完整的一问一答。放在循环中间提取,拿到的是半截状态,模型刚读完文件还没动手,你没法判断它最终要干什么。
而且这一步是异步的。它在后台回顾本轮对话,不阻塞用户的下一轮输入——用户敲完下一句,记忆提取可能还没跑完。用一次额外 LLM 调用换永久能力,但不能让它出现在用户能感知的延迟里。
四类记忆,两个归属
四类按归属分成两组:
| type | 是什么 | 存在哪 |
|---|---|---|
user 用户偏好 |
编码习惯、语言习惯(「不要用 tab」) | 用户级 ~/.agent/memory/ |
feedback 纠正反馈 |
用户指出 Agent 错了,并给出正确做法 | 用户级 ~/.agent/memory/ |
project 项目知识 |
技术栈、目录结构、部署方式 | 项目级 <项目根>/.agent/memory/ |
reference 参考信息 |
外部链接、API 文档地址 | 项目级 <项目根>/.agent/memory/ |
分组的依据很干净:关于「人」的跟着人走,关于「项目」的跟着项目走。
user 和 feedback 换个仓库仍然成立——「不要用 tab」在你所有项目里都成立——所以放用户级,所有项目复用。project 和 reference 换个项目就完全不适用了(「数据库是 PostgreSQL 15」只对这一个仓库有意义),所以放项目级,还可以选择提交到 Git 跟团队共享。
type 字段选对了,目录也就定了。 这个设计省掉了一个配置项。
存储:一条记忆一个文件
1 | .agent/memory/ |
注意是「一条记忆一个文件」,不是一个大文件。 这个选择带来三个好处:
- 新增不用改旧文件 —— 加一条记忆就是写一个新文件,不会跟别人(或别的会话)同时改同一个大文件
- 删除就是删文件 —— 不用在几百行里定位再删
- 索引和正文可以分开用 —— 索引整个注入,正文按需读取(下一节细说)
索引文件只有指针,每行一条:
1 | - [偏好 any 语法](user-prefers-any.md) — 用户要求用 any 替代 interface{} |
单条记忆的格式跟项目指令文件是同一套 Markdown——frontmatter 加正文:
1 | --- |
description 那一行是给索引和检索用的,正文里的 Why 和 How to apply 是给模型用的——只有一行结论,模型下次遇到类似情况可能还是会犹豫;带上「为什么」和「怎么应用」,它才知道边界在哪。
提取靠一段提示词
没有规则引擎,没有分类器,就是一次 LLM 调用:
1 | memoryExtractionPrompt = """ |
倒数第二行是去重的全部实现:已有相同含义的记忆不要重复创建。
为什么不用相似度算法?因为整个记忆目录清单就在提示词里——模型看得到已有记忆的 name 和 description,它做的判断比向量相似度更准(「用 any 而不是 interface{}」和「偏好 Go 现代语法」字面不相似,但说的是同一件事)。用向量去重反而要多维护一套索引、一套阈值,还得调。
最后一行同样重要:没有值得记忆的内容就什么都不做。 给提取器一个「可以什么都不做」的选项,它才不会为了交差硬凑出一条记忆。
去重交给 LLM 有个前提:记忆得足够少,少到能整个列进提示词。 几十条没问题,几万条就得上检索了——那时候这套设计才需要换。
5. 三种记忆是怎么汇进一次请求的
到这里三种形态都各自落盘了。最后一步是把它们拼进请求:
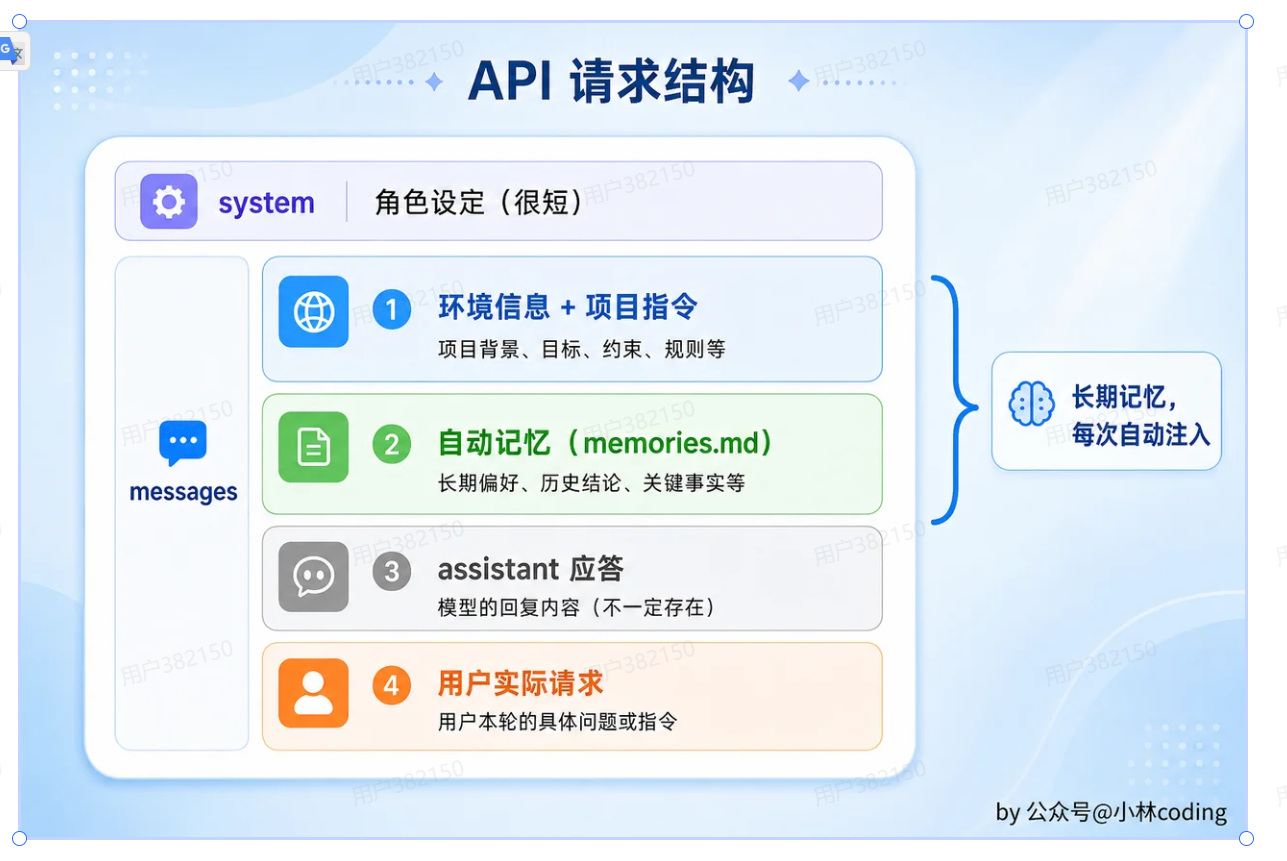
1 | { |
system 很短,只有一句角色定义。 项目指令和记忆索引都放在 messages 里,作为第一条 user 消息。这个分工有两个理由:
system是最稳定的那一层,只放角色设定。项目指令和记忆每次会话都可能变,放在 messages 里,改的只是消息内容,不用去动 system。- 项目指令和记忆索引走的是同一条加载管线(发现文件 → 读取内容 → 注入 messages)。塞进 system 就得给它俩单独维护一套逻辑。
注入索引,不注入正文
再看一眼上面那条消息:注入的是 MEMORY.md 的索引,每行一条,指针加一句话说明。不是所有记忆的正文。
模型看到索引,只知道「有这么回事」;真要用的时候,再用读文件的工具去读那个文件。
这是渐进披露——跟 Skill 的加载方式同一个思路(Function Calling介绍 §6):平时只带着 name + description,命中了才把正文读进来。道理是一样的:上下文的每一行都按 token 收费,所以先给它目录,别给它全书。
一个副作用
按这个设计,索引是会话启动时注入一次的。所以这一轮新学到的记忆,不会当场生效——提取器在回合结束后才写文件,而索引早就注入完了。要等下一次会话,它才进上下文。
这个延迟是有意接受的:记忆本来就是为「下次」准备的,不是为「这一轮」准备的。本轮需要的信息,本来就在上下文里。
6. 小结
一、记忆分两层,判断标准是活多久。 工作记忆是上下文窗口,会话结束就没了;长期记忆落在磁盘上,跨会话有效。前者要压缩(上一篇),后者要组织(这一篇)。
二、长期记忆有三种形态,区别在于谁写的。 项目指令文件是人预先写的,会话持久化是系统照原样录的,自动记忆是 Agent 自己判断出来的。三者最后走同一条管线注入请求——不是三个功能,是同一件事的三个来源。
三、项目指令文件是三级拼接,不是覆盖。 项目根目录、.agent/、用户目录三个位置各有用途;三级管的是不同的东西(个人偏好 / 团队规范 / 项目知识),所以全部保留。@include 让它能模块化,代价是要自己防住无限递归和路径越界。
四、会话持久化选 JSONL,是为了崩溃时只丢最后一行。 追加 O(1)、错误被限制在一行之内,天然适合一个随时可能被杀的长时间进程。写入顺序是先落盘再更新内存——磁盘是真相,内存只是缓存。
五、恢复比读取麻烦: 跳过不完整的行、验证 tool_use / tool_result 的配对、检查要不要先压缩、补一条「距上次 N 天」的提示。最后一条没有技术含量,但它是「恢复」和「无缝恢复」的差别。
六、自动记忆的核心是判断,实现是一段提示词。 每轮 Agent Loop 结束后异步提取,按 user / feedback / project / reference 分类——关于「人」的跟人走,关于「项目」的跟项目走。一条记忆一个文件,MEMORY.md 只存指针。去重交给提取 LLM,因为整个目录清单就在提示词里。
七、注入索引,不注入正文。 长期记忆的索引贴在请求最前面,正文按需读取——渐进披露,跟 Skill 一个思路。含义是新学到的记忆要下次会话才生效,因为索引在会话启动时就注入了。
参考
- Claude Code 记忆(
AGENT.md与自动记忆):https://code.claude.com/docs/en/memory - Agent Skills(渐进披露):https://code.claude.com/docs/en/skills
- 上一篇:上下文压缩与 Token 管理 —— https://wywzixin.github.io/agent/context-compaction/
- ReAct 与 Agent Loop —— https://wywzixin.github.io/agent/react-agent-loop/
- LLM 请求与流式响应 —— https://wywzixin.github.io/agent/llm-request-streaming/
- Function Calling介绍 —— https://wywzixin.github.io/agent/function-calling/
- MCP 协议与工具接入 —— https://wywzixin.github.io/agent/mcp-protocol/